CBOWとSkip-gramの仕組みと覚え方:Word2vecにおける単語予測モデルの基礎
 山崎講師
こんにちは。ゆうせいです。
自然言語処理の分野において、コンピューターに言葉の意味を理解させるための基礎技術として単語のベクトル化があります。単語を数値の並びであるベクトルに変換する代表的な手法がWord2vecであり、その内部にはCBOW(シーボウ)とSkip-gram(スキップグラム)という2つのモデルが存在します。
両者はどちらも単語同士の前後の並び順を利用して学習を行いますが、入力と出力の関係性が正反対に設計されています。この入力と出力の方向性を明確に整理することで、それぞれの名前の意味と計算の仕組みを無理なく把握できます。
本記事では、前提知識を持たない方に向けて、CBOWとSkip-gramの基本概念から構造の違い、覚え方、実務上の長所と短所、そして理解を深める学習の手順を解説します。
単語のベクトル表現と予測モデルの基礎
コンピューターは文字そのものを意味として解釈できないため、単語を数値の配列に置き換える必要があります。
単語の意味はその周囲にある文脈(前後の単語)によって形成されるという言語学の仮説に基づき、前後の単語との関連性を統計的に学習する手法がWord2vecです。
虫食い問題と出題者による比喩
高校の英語の授業で出題される空欄補充問題を想定します。
1つ目の形式は、前後の文脈をヒントにして中央の空欄に入る英単語を当てる問題です。「The (空欄) barks loudly」という文において、前後の単語を手がかりに空欄が「dog」であると推測します。
2つ目の形式は、中央に指定された1つのキーワードから、その前後に置かれるはずの単語群を連想して文章を復元する作業です。「dog」という単語を中心にして、その前後に「The」や「barks」が並ぶ可能性が高いと推測します。
前者の空欄補充に相当する仕組みがCBOWであり、後者の連想復元に相当する仕組みがSkip-gramです。
構成する用語の整理
モデルの仕組みを読み解くために必要な用語の意味を整理します。
- ターゲット単語:予測の対象または起点となる中心の単語
- 周辺単語(コンテキスト):中心の単語の前後に存在する単語群
- ウィンドウサイズ:中心の単語から前後何文字までを周辺単語として扱うかを決める範囲
- 語彙数 V:辞書に登録されているすべての単語の総数
- 隠れ層の次元数 N:単語を表現するために圧縮するベクトルの長さ
2つのモデルの構造と相違点
CBOWとSkip-gramは、ニューラルネットワークの入力層と出力層にどの単語を配置するかという点で正反対の構成をとります。
CBOWの構造:周辺から中心を予測する
CBOWは Continuous Bag-of-Words の略称です。
周辺にある複数の単語を入力として受け取り、その中心に位置する1つのターゲット単語を予測します。
たとえば、前後2単語ずつを周辺単語とする場合、合計4つの単語ベクトルが入力層に渡されます。隠れ層ではこれらの入力ベクトルの平均値が計算され、出力層において中心に入る単語の確率分布が算出されます。
単語の出現順序を問わず袋(Bag)の中に詰め込んで平均化する性質を持つため、Bag-of-Wordsという名称が付けられています。
Skip-gramの構造:中心から周辺を予測する
Skip-gramは、CBOWとは逆の計算順序をたどります。
中心にある1つのターゲット単語を入力として受け取り、その前後に現れる複数の周辺単語を予測します。
入力層には中心の単語ベクトルのみが入り、隠れ層を経由して、出力層では複数の周辺単語それぞれの発生確率が計算されます。
中心から離れた前後の単語へと飛び越えて(Skipして)関連性を予測する性質が名称に反映されています。
2つのモデルの構造比較
入力と出力の配置の違いは次の通りです。
- CBOWの入力:複数の周辺単語
- CBOWの出力:1つの中心単語
- Skip-gramの入力:1つの中心単語
- Skip-gramの出力:複数の周辺単語
CBOWとSkip-gramの覚え方
両者の名称と役割を取り違えないための記憶法として、言葉の構成要素と矢印の方向を結びつける手法が役立ちます。
頭文字と役割の対応づけ
名称に含まれる単語に着目して整理します。
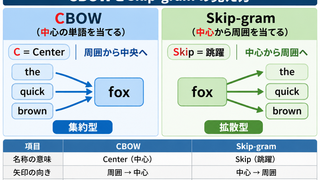
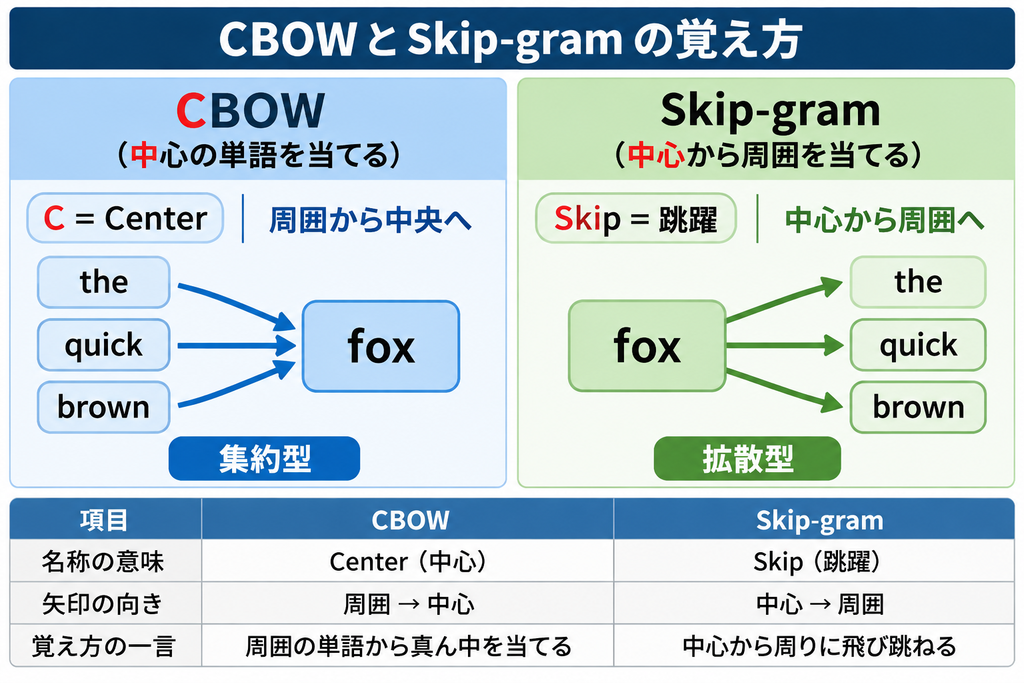
- CBOWの「C」は Center(中心)を連想し、「中心の単語を当てるモデル」と覚えます。
- Skip-gramの「Skip」は跳躍を意味し、「中心から周囲へ向かって飛び跳ねるように周囲を当てるモデル」と覚えます。
矢印の形状による視覚的な整理
情報の流れを矢印の広がりとして捉えることも有効です。
- CBOW:周囲から中心へ向かって矢印が集まる形(集約型)
- Skip-gram:中心から周囲へ向かって矢印が放射状に広がる形(拡散型)
複数の周辺情報から1つの中心を絞り込む動作がCBOWであり、1つの起点から複数の周囲へと展開する動作がSkip-gramであると対応づけることで、入力と出力の関係性を正確に再現できます。
各モデルの長所と短所
データ処理の特性や学習結果には、双方に明確な相違点が存在します。
CBOWの長所と短所
- 長所複数の周辺単語を足し合わせて平均化するため計算の負荷が低く、大規模な文章データに対しても高速に学習を完了させることができます。頻出する一般的な単語の表現獲得において安定した精度を発揮します。
- 短所周辺単語のベクトルを平均化する過程で語順の情報が失われます。また、出現回数の少ない珍しい単語(低頻度語)については、頻出単語の数値に埋もれてしまい、意味の正確な学習が難しくなる傾向があります。
Skip-gramの長所と短所
- 長所1つの中心単語に対して周辺の単語ごとに独立した予測試行を行うため、学習のサンプル数が実質的に増加します。その結果、出現回数が少ない珍しい単語に対しても文脈情報が反映されやすく、語彙全体の細やかなニュアンスを捉えたベクトルが獲得できます。
- 短所1つの単語から複数の単語を個別に予測するため、計算回数が単語数に応じて跳ね上がり、学習の完了までに長い計算時間を要します。
まとめ
CBOWとSkip-gramは、入力と出力の向きを入れ替えることで、それぞれ異なる特徴を持つ単語ベクトルを生成するモデルです。
- CBOWは周囲の複数の単語から中央の1単語を当てるモデルであり、学習速度に優れる
- Skip-gramは中央の1単語から周囲の複数単語を当てるモデルであり、低頻度語の精度に優れる
- 中心へ集めるCBOW、外へ広がるSkip-gramという構造の違いが存在する
Word2vecに関する理解を深めるためには、次の手順に沿って学習を進める方法を推奨します。
- 「I have a pen」のような短い例文を用意し、ウィンドウサイズを1に設定した上で、CBOWとSkip-gramそれぞれの入力データと教師データの組み合わせを手作業で書き出す。
- 出力層における確率計算で用いられる多値分類の関数であるsoftmax関数の計算式を確認する。
- 全単語に対する確率計算の負担を軽減するために考案された手法であるネガティブサンプリング(Negative Sampling)の仕組みを調べる。
- 単語同士の足し算や引き算(例:King - Man + Woman = Queen)がなぜ成立するのか、ベクトルの空間的な配置とコサイン類似度の算出方法へと学習範囲を広げる。
投稿者プロフィール