新人エンジニア研修講師
研修講師のための発信者情報開示請求入門 中傷されたときの判断手順と現実的なコスト新着!!
こんにちは。ゆうせいです。 研修講師として活動していると、自分の名前がインターネット上に残ります。実績として残ることもあれば、望まない形で書かれることもあります。 口コミサイトに事実と異なることを書かれた。SNSで中傷さ […]
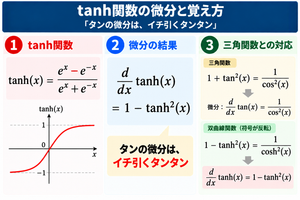
tanh関数とその微分の覚え方:基本定義と1引く二乗の公式を再現する手順新着!!
こんにちは。ゆうせいです。 人工知能や機械学習の計算モデルにおいて、数値を一定の範囲に収めながら次の処理へ受け渡す道具として、ハイパボリックタンジェント関数(tanh関数)が広く利用されています。学習を始めたばかりの段階 […]
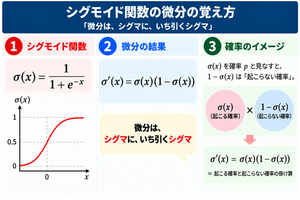
シグモイド関数とその微分の覚え方:基本定義と公式を素早く再現する手順新着!!
こんにちは。ゆうせいです。 人工知能や機械学習の計算において、入力された数値を一定の範囲に収める役割を持つ数式としてシグモイド関数が広く用いられます。学習を始めたばかりの方がこの関数の微分計算を学ぶ際、複雑な数式の変形に […]
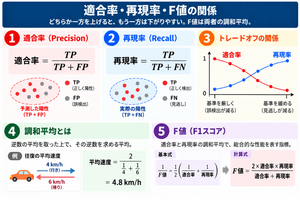
適合率・再現率・F値の公式の覚え方:分母の違いから整理する評価指標の基本新着!!
こんにちは。ゆうせいです。 機械学習や統計のモデルが下した判断の正しさを測る際、正解率だけでなく適合率や再現率といった指標が頻繁に用いられます。しかし、計算式に出てくる記号や用語が似ているため、初学者の段階ではどちらがど […]
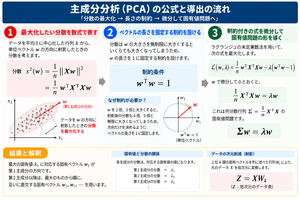
主成分分析の公式の導出と覚え方:共分散行列の固有値問題への流れを整理新着!!
こんにちは。ゆうせいです。 たくさんの項目を持つデータを扱う際、重要な情報をできるだけ残したまま項目数を減らす手法として主成分分析が使われます。学習を進める中で、最終的に共分散行列の固有値問題へと行き着く数式の展開に直面 […]
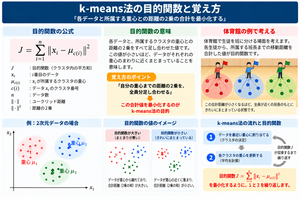
k-means法の目的関数と更新式:仕組みと導出の整理新着!!
こんにちは。ゆうせいです。 データを似た者同士のグループに分ける手法は、機械学習の領域でクラスタリングと呼ばれます。クラスタリングの代表的な手法であるk-means法は、単純な規則を繰り返すことでデータを分類します。分類 […]
研修講師のためのフリーランス法入門 契約・報酬・中止時の扱いを実務目線で整理新着!!
こんにちは。ゆうせいです。 研修講師として業務委託で仕事を受けていると、次のような経験はないでしょうか。 登壇日は決まっているのに、契約書が届かない。報酬の振込が研修の3か月後になる。営業用のデモ研修を無償で頼まれる。研 […]
行動力と実行力は何が違うのか 0→1の力と1→100の力新着!!
こんにちは。ゆうせいです。 人事評価のコメントを書くとき、「行動力がある」「実行力が高い」という言葉を使ったことはないでしょうか。 では、この2つは何が違うのでしょうか。 研修でこの質問をすると、答えがきれいに割れます。 […]
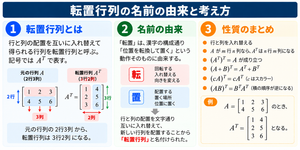
転置行列の名前の由来とは?初心者向けに基礎からわかりやすく解説新着!!
こんにちは。ゆうせいです。 数学やプログラミングを学び始めると、線形代数の分野で頻繁に出現する概念に転置行列があります。数式記号として見かける機会は多くても、具体的にどのような操作を行っているのか、なぜ「転置」という名称 […]
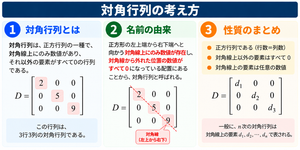
対角行列の名前の由来とは?初心者向けに基礎からわかりやすく解説新着!!
こんにちは。ゆうせいです。 線形代数の基礎を学ぶ中で、計算の効率化やデータの変換において基準となる概念に対角行列があります。名前から対角線に関係があることは推測できても、具体的な構造やなぜそう呼ばれるのかについて、体系的 […]
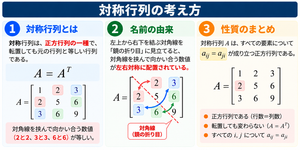
対称行列の名前の由来とは?初心者向けに基礎からわかりやすく解説新着!!
こんにちは。ゆうせいです。 数学やデータ分析を学び始めると、「対称行列」という単語を目にする機会があります。名前を聞いたことがあっても、なぜ「対称」と呼ばれるのか、その理由や実用面での特徴については把握しきれていない場合 […]
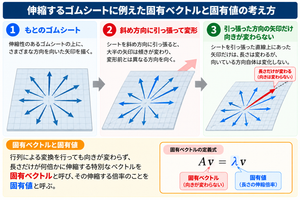
固有値と固有ベクトルの公式の覚え方:向きが変わらないベクトルの意味と計算手順新着!!
こんにちは。ゆうせいです。 線形代数の基礎となる固有値と固有ベクトルは、記号の並びを見ると抽象的な計算に見えがちです。しかし、行列が空間に対して行う変形の働きと結びつけることで、公式の構造を無理なく記憶に定着させることが […]
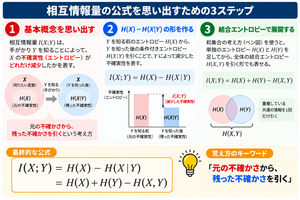
相互情報量の公式の覚え方:片方を知ることで減る不確実性の計算手順新着!!
こんにちは。ゆうせいです。 2つの出来事がどれくらい関係しているかを測る指標として、情報理論では相互情報量が用いられます。一見すると複雑な数式に思えますが、元の不確実性から残った不確実性を差し引くという引き算の構造を押さ […]
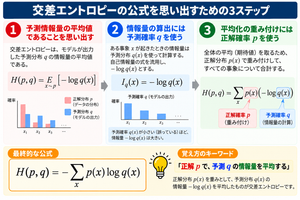
交差エントロピー誤差の公式の覚え方:正解分布と予測分布から理解する情報理論新着!!
こんにちは。ゆうせいです。 機械学習の分類問題などで頻繁に利用される交差エントロピーは、数式の記号が多く、正解と予測のどちらを対数に入れるべきか迷いやすい概念です。確率の分布が持つ意味を整理して数式の構造を把握すると、無 […]
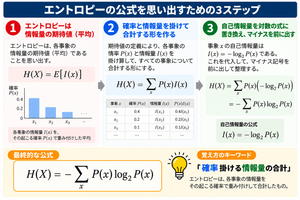
情報理論におけるエントロピーの公式の覚え方:自己情報量の期待値から導く考え方新着!!
こんにちは。ゆうせいです。 情報理論で頻繁に登場するエントロピーの計算式は、記号の並びを見ると難解な印象を受けがちです。しかし、前提となる考え方を一つずつ分解して整理すると、計算式自体が持つ意味を自然に把握できます。この […]
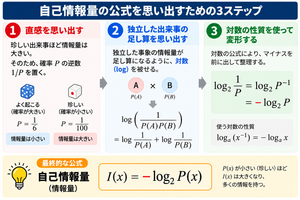
自己情報量の公式の覚え方と直感的理解:確率と情報量の関係新着!!
こんにちは。ゆうせいです。 情報理論の基礎となる自己情報量は、一見すると対数関数を用いた複雑な数式に見えます。しかし、日常の直感と数式を結びつけることで、公式の構造を無理なく記憶できます。数学的な前提知識がない方に向けて […]
MAP推定の公式はベイズの定理の分子部分だけ新着!!
こんにちは。ゆうせいです。 統計的なデータ分析や機械学習の分野において、手元にあるデータから母数を割り出す手法として最大事後確率推定(MAP推定)が用いられます。教科書に掲載されている数式を文字の並びのまま暗記しようとす […]
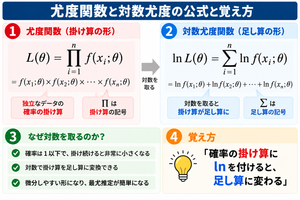
最尤推定と対数尤度の公式の覚え方と積を対数で和に変える計算手順新着!!
こんにちは。ゆうせいです。 統計学や機械学習の学習において、観測されたデータに最もよく当てはまる数値を決定する手法として最尤推定が登場します。その計算過程で必ず使用されるのが対数尤度です。 教科書に並ぶ数式を単なる文字の […]
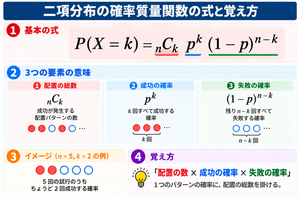
ベルヌーイ分布と二項分布の公式の覚え方と成功確率を用いた計算手順新着!!
こんにちは。ゆうせいです。 確率や統計の基礎を学ぶ際、コイン投げやくじ引きのように結果が2通りしかない試行を扱う場面が数多くあります。このような試行の基礎となるのがベルヌーイ分布であり、その試行を複数回繰り返した結果をま […]
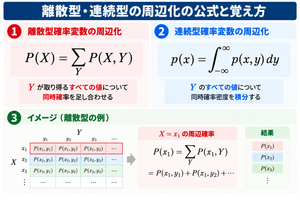
周辺化(周辺確率)の公式の覚え方と不要な変数を足し合わせて消す計算手順新着!!
こんにちは。ゆうせいです。 複数の要素が絡み合う確率の計算において、特定の要素だけに注目したい状況が生じることがあります。統計学や機械学習の基礎理論では、このような操作を周辺化と呼び、得られた確率を周辺確率と定義します。 […]
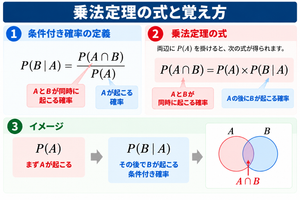
条件付き確率と乗法定理の公式の覚え方と全体を絞り込む考え方新着!!
こんにちは。ゆうせいです。 確率の計算において、特定の条件が与えられた状況下での確率を求める場面があります。教科書では条件付き確率や乗法定理として記号を用いた公式が紹介されますが、文字の並びだけを暗記しようとすると、計算 […]
初心者向けバイブコーディングのセキュリティチェックリストと安全対策新着!!
こんにちは。ゆうせいです。 人工知能(AI)に自然な言葉で指示を出し、プログラムを自動生成するバイブコーディングは、専門知識がない状態でも手軽に制作を体験できる手法として普及しています。 しかし、生成されたプログラムの内 […]
非エンジニアが生成AIを活用して開発を行うバイブコーディングの基礎知識と注意点
こんにちは。ゆうせいです。 近年、日常会話の言葉(自然言語)を用いて人工知能(AI)に指示を出し、プログラムを生成させるバイブコーディングと呼ばれる手法が注目を集めています。IT分野の教育現場においても、受講生からこの技 […]
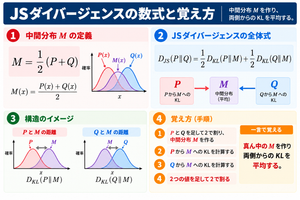
JSダイバージェンスの計算式の仕組みと覚え方:2つの確率分布の対称的な差異を測る指標の基礎
こんにちは。ゆうせいです。 統計学や機械学習の領域において、2つの確率分布の違いを測定する指標としてKLダイバージェンスが広く使われています。しかし、KLダイバージェンスには計算の方向によって値が変わる非対称性や、分母が […]
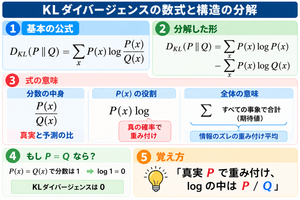
KLダイバージェンスの計算式の仕組みと覚え方:2つの確率分布の違いを測る相対エントロピーの基礎
こんにちは。ゆうせいです。 統計学や機械学習の分野において、2つの確率の散らばり方(確率分布)がどれくらい異なっているかを数値で評価する指標として、KLダイバージェンス(カルバック・ライブラー情報量)が利用されます。 専 […]
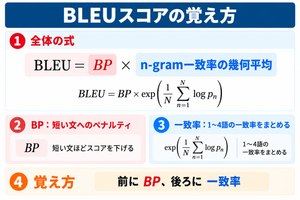
BLEUスコアの計算式の仕組みと覚え方:機械翻訳の自動評価指標の基礎
こんにちは。ゆうせいです。 自然言語処理や機械翻訳の分野において、コンピューターが生成した翻訳文の品質を客観的な数値で測定するための指標としてBLEU(バイリンガル・エバリュエーション・アンダースタディ)スコアが広く利用 […]
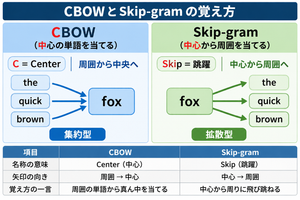
CBOWとSkip-gramの仕組みと覚え方:Word2vecにおける単語予測モデルの基礎
こんにちは。ゆうせいです。 自然言語処理の分野において、コンピューターに言葉の意味を理解させるための基礎技術として単語のベクトル化があります。単語を数値の並びであるベクトルに変換する代表的な手法がWord2vecであり、 […]
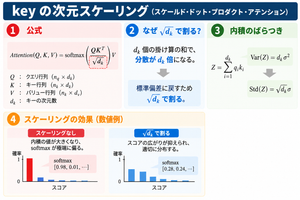
Scaled Dot-Product Attentionにおけるkey次元スケーリングの公式と覚え方
こんにちは。ゆうせいです。 自然言語処理や深層学習の基盤モデルとして広く使われるTransformerには、入力された単語同士の関連度を計算する仕組みとしてScaled Dot-Product Attentionが組み込 […]
モメンタムの仕組みと更新式の覚え方:物理の慣性を応用した勾配降下法の基礎
こんにちは。ゆうせいです。 機械学習や深層学習のモデルを訓練する際、損失関数を最小化するための最適化手法として勾配降下法が広く用いられています。基本的な勾配降下法では、谷底に向かう途中で振動が生じたり、平坦な領域で学習が […]
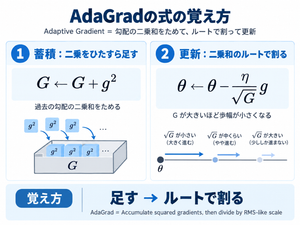
AdaGradの仕組みと更新式の覚え方:勾配の二乗和を用いた学習率の自動調整
こんにちは。ゆうせいです。 人工知能や深層学習のモデルを訓練する際、計算結果の誤差を小さくするためにパラメータの値を少しずつ書き換えていく最適化手法が使われます。その代表的なアルゴリズムの1つがAdaGrad(アダグレー […]