KLダイバージェンスの計算式の仕組みと覚え方:2つの確率分布の違いを測る相対エントロピーの基礎
 山崎講師
こんにちは。ゆうせいです。
統計学や機械学習の分野において、2つの確率の散らばり方(確率分布)がどれくらい異なっているかを数値で評価する指標として、KLダイバージェンス(カルバック・ライブラー情報量)が利用されます。
専門書に掲載されている数式にはシグマ記号や積分、対数(log)が含まれており、初見では複雑に感じられる傾向があります。しかし、基準となる本来の分布と予測した分布のズレを計算する仕組みを順を追って確認することで、数式の組み立て方を整理できます。
本記事では、前提知識を持たない方に向けて、KLダイバージェンスの基本概念から計算式の構造、覚え方、利点と留意点、そして理解を深める学習の手順を解説します。
KLダイバージェンスの基本概念
確率分布とは、どのような事象がどれくらいの確率で発生するかをまとめた規則を指します。
KLダイバージェンスは、基準となる真の確率分布 P と、近似や予測として用意した別の確率分布 Q との間の差異を測定する指標です。情報理論の分野では相対エントロピーとも呼ばれます。2つの分布が完全に一致している場合は 0 となり、分布の形状がかけ離れるほど値は正の方向へ大きくなります。
天気予報の降水確率による比喩
高校の行事で行う遠足の天気を想定します。
気象庁が過去の膨大な観測データから算出した「真の降水確率」と、生徒が直感や簡略化されたアプリで予想した「予測の降水確率」の2つが存在する状況を考えます。
真の確率では「晴れが80%、雨が20%」であるのに対し、予測側が「晴れが50%、雨が50%」と見積もっていたとします。予測を信じて行動すると、雨具の準備などに無駄や不足といった情報伝達のロスが生じます。
KLダイバージェンスは、この「真実の発生ルール」を基準にしたときに、「近似した予測ルール」を採用することでどれくらい余計な情報量(驚きや推測の無駄)が発生するかを計算する数値です。
構成する記号の整理
数式に用いられる記号の意味を整理します。
- x:発生する個々の事象(例:晴れ、雨など)
- P(x):事象 x が発生する真の確率分布(基準となる分布)
- Q(x):事象 x が発生する予測やモデルの確率分布(近似する分布)
- log:情報量の大きさを表すための対数(通常は底として 2 や自然対数の e を使用します)
- D_{KL}(P || Q):確率分布 P を基準としたときの確率分布 Q のKLダイバージェンス
KLダイバージェンスの数式と構造の分解
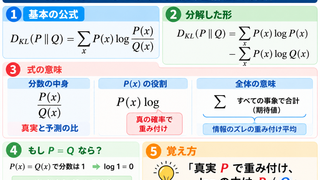
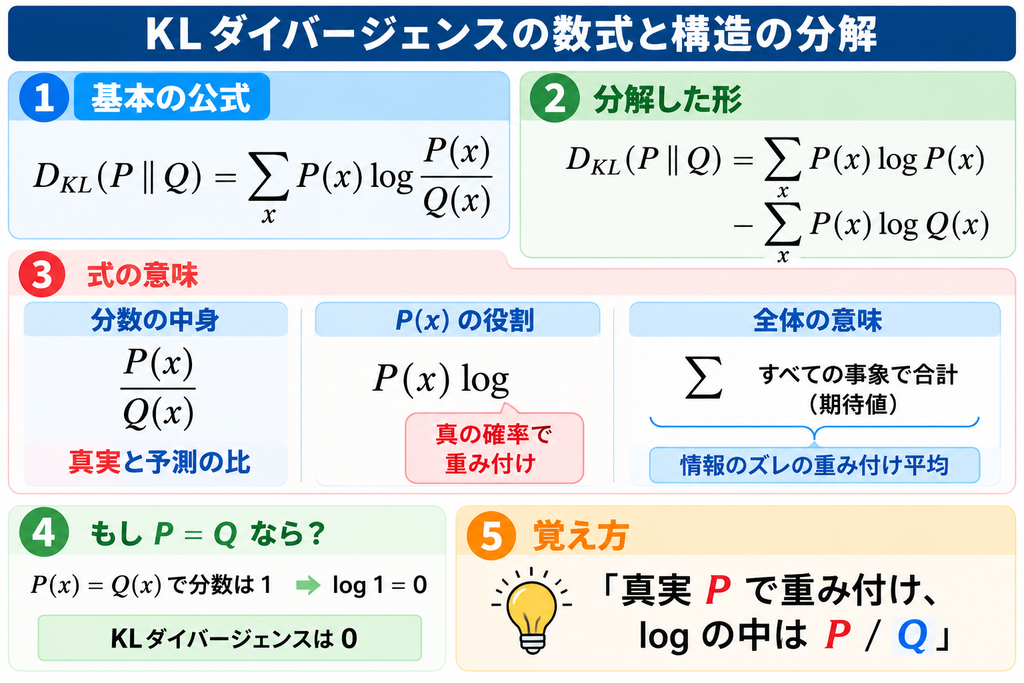
事象が離散的(飛び飛びの値)である場合、KLダイバージェンスの計算式は次の形をとります。

この式は、対数の引き算の性質を利用して2つの部分に分解できます。

1. 対数の中身にある分数の意味
分数 P(x) / Q(x) は、真の確率 P(x) と予測の確率 Q(x) の比率を計算しています。
対数の性質により、log(P(x) / Q(x)) は log P(x) - log Q(x) と変形できます。情報理論において、ある事象の自己情報量は -log P(x) で定義されます。予測した確率 Q(x) の情報量から、本来の確率 P(x) の情報量を差し引くことで、近似によって生じる「余分な情報量」が求まります。
もしすべての事象において P(x) と Q(x) が完全に同一であれば、分数は 1 となり、log 1 の値は 0 になるため、KLダイバージェンス全体も 0 に収まります。
2. 外側にある P(x) とシグマの役割
対数の手前に掛けられている P(x) と、全体を合算するシグマ記号は、統計学における期待値の計算を表しています。
事象が実際に発生する頻度は、予測である Q(x) ではなく、現実の確率である P(x) に従います。そのため、生じる情報量の差に対して「真の発生確率 P(x)」を重みとして掛け合わせ、すべての事象 x について合計することで、平均的に発生する情報のズレ(期待値)を算出します。
式の覚え方
公式を記憶する際は、情報のズレの重み付け平均として捉える整理法が役立ちます。
- 分母と分子の配置:真実 P(x) を基準に、予測 Q(x) で割る(P / Q)
- 全体の枠組み:真の確率 P(x) で重み付けして合計する(Σ P × log)
「真実 P で重み付けを行い、log の中は真実 P を予測 Q で割る」という順序で確認することで、P と Q の配置を取り違えずに数式を再現できます。
KLダイバージェンスの利点と留意点
確率分布の差異を測定する指標としてKLダイバージェンスを採用する際には、確認できる明確な長所と配慮すべき点が存在します。
利点
- 機械学習における損失関数との親和性分類問題で標準的に用いられる交差エントロピー誤差は、KLダイバージェンスの第2項と直結しています。モデルの出力分布 Q を正解分布 P に近づける学習処理は、数理的にKLダイバージェンスを最小化する計算と等しくなります。
- 常に0以上の値をとる安定性イェンセンの不等式によって、どのような確率分布の組み合わせであっても計算結果は必ず 0 以上になる性質(ギブスの不等式)が証明されています。
留意点
- 非対称性(距離の公理を満たさない点)通常の幾何学的な距離とは異なり、P から見た Q の差異 D_{KL}(P || Q) と、Q から見た P の差異 D_{KL}(Q || P) の計算結果は一般に一致しません。基準をどちらに置くかによって数値が変動するため、厳密な意味での距離関数ではありません。
- 分母が0になる場合の計算不能リスクある事象 x について、真の確率 P(x) が存在するにもかかわらず、予測確率 Q(x) が 0 と見積もられていた場合、対数内部の分母が 0 となり値が無限大へ発散します。
まとめ
KLダイバージェンスの数式は、2つの確率分布の隔たりを情報量の差として測定するための計算式です。
- 真の確率 P(x) と予測確率 Q(x) の比率を対数で計算する
- 現実に発生する頻度である P(x) を重みとして掛けて総和をとる
- 2つの分布が完全に等しいときに 0 となり、それ以外では常に正の値をとる
- 基準の置き方によって値が変化するため、計算方向の非対称性を持つ
KLダイバージェンスに関する理解を確実なものにするためには、次の手順に沿って学習を進める方法を推奨します。
- コインの表裏の確率として P = (0.5, 0.5) と Q = (0.8, 0.2) を設定し、底を 2 とした対数を用いて手計算で数値を算出する。
- P と Q の立場を入れ替えて D_{KL}(Q || P) を計算し、両者の数値が一致しない非対称性を確認する。
- 式を変形して情報エントロピー H(P) と交差エントロピー H(P, Q) に分解し、損失関数との関連性を確認する。
- 連続型確率変数における積分の定義式を確認し、変分オートエンコーダー(VAE)などの生成モデルで潜在変数の分布を正規分布に近づける正則化項としての利用例へと学習範囲を広げる。
投稿者プロフィール