
強化学習の全体像とアルゴリズムの体系を初心者向けにわかりやすく解説
 山崎講師
こんにちは。ゆうせいです。
人工知能分野における重要な技術の一つに強化学習があります。強化学習は、コンピューターが試行錯誤を通じて最適な行動手順を身につける手法です。本記事では、強化学習の全体像を捉えるための基本要素と、代表的な手法の分類について順を追って解説します。
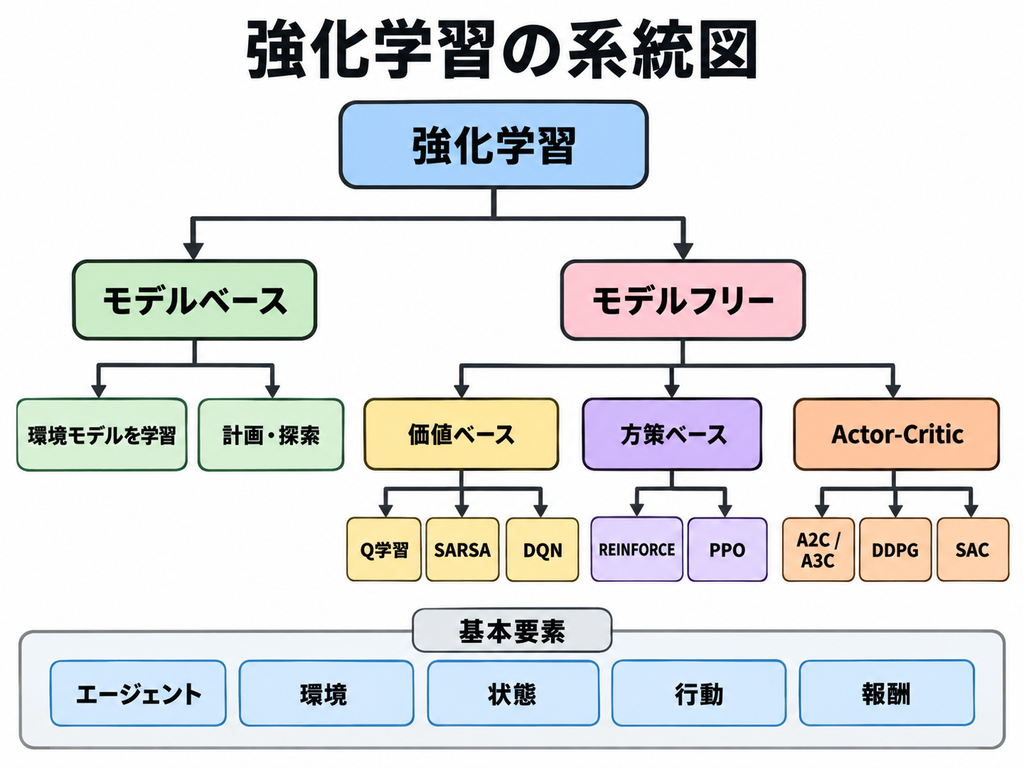
強化学習を構成する5つの基本要素
強化学習の仕組みを把握するためには、基盤となる5つの構成要素を押さえる必要があります。ゲームのプレイに例えると、それぞれの役割が明確になります。
- エージェント:行動を決定し、学習を行う主体です。ゲームで操作するキャラクターに相当します。
- 環境:エージェントが置かれている世界や状況全体を指します。ゲームのステージやルールの枠組みに相当します。
- 状態:ある時点における環境の具体的な様子です。画面内のキャラクターの位置や残りの体力などの情報に相当します。
- 行動:エージェントが各状態で選択できる動作です。コントローラーのボタン操作に相当します。
- 報酬:エージェントの行動に対して環境から与えられる評価値です。ゲームの得点やクリア時のボーナスに相当します。
エージェントは、得られる報酬の合計が最大になるような行動方針の獲得を目指します。
モデルベースとモデルフリーの違い
強化学習の手法は、環境の仕組み(環境モデル)を利用するかどうかによって、モデルベースとモデルフリーの2つに大別されます。
モデルベース
モデルベースは、環境の遷移確率や報酬のルールをあらかじめ知っている、あるいは自ら学習して予測しながら行動を決める手法です。
チェスや将棋のように、頭の中で盤面を何手先まで予測してシミュレーションする思考法に似ています。
- メリット:事前に予測を立てられるため、少ない試行回数で効率的に学習を進められます。
- デメリット:複雑な現実世界では精度の高い環境予測モデルを構築することが極めて難しく、計算量も膨大になります。
主なアプローチには「環境モデルを学習」して予測する方法と、得られたモデルを用いて最適な行動手順を導く「計画・探索」があります。
モデルフリー
モデルフリーは、環境モデルの予測を行わず、実際に試行錯誤を繰り返して得られた経験データのみをもとに行動方針を更新する手法です。
自転車の練習のように、物理学的な計算を頭で行うのではなく、実際に乗って転びながら体の動かし方を身につける感覚に近いです。
- メリット:環境の仕組みが複雑で予測が困難な問題であっても、直接的な経験を通じて柔軟に適用できます。
- デメリット:適切な行動を見つけるまでに数多くの試行錯誤を重ねる必要があり、大量の学習データが求められます。
実用的な場面ではモデルフリーが広く用いられており、主に3つのアプローチに枝分かれします。
モデルフリーにおける3つの主要アプローチ
モデルフリー手法は、価値ベース、方策ベース、そして両者を組み合わせたActor-Criticに分類されます。
1. 価値ベース
価値ベースは、ある状態や行動が将来的にどれだけの報酬をもたらすかという「価値」を数値化して評価し、価値が最も高くなる行動を選択する手法です。
テスト勉強に例えると、「この科目を3時間勉強すると80点取れる」という点数の予測表を作成し、最も高い点数が見込める科目を優先して勉強する判断基準に相当します。
代表的なアルゴリズムは以下の通りです。
- Q学習:行動ごとの価値を表すQ値を、試行錯誤を通じて直接更新していく基礎的な手法です。
- SARSA:実際にエージェントが選択した次の行動に基づいてQ値を更新する手法です。
- DQN(Deep Q-Network):Q値の推計にディープニューラルネットワークを導入し、画像などの複雑な状態情報をそのまま扱えるようにした手法です。
2. 方策ベース
方策ベースは、価値を経由せず、状況に応じた「行動の選択確率(方策)」を直接調整していく手法です。
スポーツの練習に例えると、得点計算を細かく分析するのではなく、「この角度でボールが来たら70%の確率で右へパスを出す」という体の反応そのものを繰り返し調整していく感覚に該当します。
代表的なアルゴリズムは以下の通りです。
- REINFORCE:方策勾配法と呼ばれる枠組みの基礎であり、行動の結果得られた累積報酬の大小に応じて行動確率を増減させる手法です。
- PPO(Proximal Policy Optimization):学習過程で方策が急激に変化して動作が不安定になるのを防ぐ制約を設けた、安定性の高い手法です。
3. Actor-Critic
Actor-Criticは、行動を選択する「Actor(行動者)」と、その行動の良し悪しを評価する「Critic(批評家)」の2つの役割を組み合わせた手法です。
漫才コンビに例えると、舞台上でネタを演じるボケ担当(Actor)と、客の反応を見ながら出来栄えを評価して改善点を伝えるツッコミ担当(Critic)が協力して芸を磨いていく関係です。
代表的なアルゴリズムは以下の通りです。
- A2C / A3C:Criticによる評価と基準値との差分(アドバンテージ)を利用して効率的に学習する手法です。複数の環境を並行して動かす仕組みを取り入れています。
- DDPG(Deep Deterministic Policy Gradient):連続的な値を取る行動空間(ロボットの関節角度やモーターの出力調整など)に対応した手法です。
- SAC(Soft Actor-Critic):報酬の最大化だけでなく、行動の多様性(エントロピー)も同時に高めることで、局所的な失敗にとらわれず探索を行える手法です。
まとめ
強化学習は、エージェントと環境の相互作用を基盤とし、予測モデルの有無(モデルベース / モデルフリー)や、何を学習の基準にするか(価値 / 方策 / 両者の併用)によって整理されます。
強化学習を体系的に身につけるための学習手順は以下の通りです。
- 基本要素(エージェント、環境、状態、行動、報酬)の相互関係を正確に理解します。
- 最もシンプルな価値ベースの手法であるQ学習の更新計算を手計算や単純なプログラムで実装します。
- 価値ベースと方策ベースのアプローチの違いを把握し、ディープラーニングと融合したDQNやPPOの仕組みを学びます。
- 連続値の制御や複合的な課題に対応するActor-Critic系の最新アルゴリズム(SACなど)へ応用範囲を広げます。
基礎から段階的にステップを踏むことで、複雑に見える強化学習のアルゴリズム群もそれぞれの意図と位置づけを明確に把握できます。
セイ・コンサルティング・グループでは新人エンジニア研修のアシスタント講師を募集しています。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。

