迷惑メールフィルタとベイズの定理:確率を用いた自動分類の仕組みと課題
 山崎講師
こんにちは。ゆうせいです。
毎日届く多数の電子メールの中から、広告や悪意のあるメールだけを自動的に専用のフォルダへ振り分ける技術が存在します。今回は、メールを判別する仕組みと、背景にある確率を計算する数学の理論について解説します。
条件付き確率とベイズの定理の基本
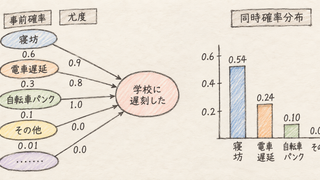
ある出来事が起きたという情報が与えられた上で、別の出来事が起きる確率を条件付き確率と呼びます。条件付き確率を用いて、新しい情報を得るたびに事象の確率を更新していく計算手法をベイズの定理と呼びます。
健康診断の検査結果を想像してください。ある病気にかかっている人が検査で陽性となる確率と、健康な人が誤って陽性となる確率が分かっているとします。検査で陽性という結果が出たとき、受診者が本当に病気にかかっている確率は、検査を受ける前の確率と検査の精度を組み合わせることで計算できます。ベイズの定理も健康診断の確率計算と同じように、手元にあるデータから原因となる事象の確率を導き出します。
迷惑メール判定における確率の応用
電子メールの振り分けシステムは、過去に受信したメールのデータを蓄積しています。受信したメールに特定の単語が含まれていた場合、システムは過去のデータとベイズの定理を用いて、該当のメールが迷惑メールである確率を計算します。
例えば「当選」という単語が含まれるメールを受信したとします。システムは、過去の迷惑メールの中に「当選」が含まれていた割合と、通常のメールに「当選」が含まれていた割合を比較します。「当選」という単語が含まれることによって迷惑メールである確率が一定の基準を超えた場合、システムは該当のメールを迷惑メールのフォルダへ移動させます。
ベイズフィルタのメリット
確率を用いた自動分類の手法には以下の長所があります。
- 受信者がメールを分類するたびにシステムが新しいデータを学習し、時間の経過とともに判定の精度が向上します。
- 単純な単語の有無だけでなく、複数の単語の組み合わせによる確率を計算するため、柔軟な分類が可能になります。
ベイズフィルタのデメリット
確率を用いた手法には、運用上の課題も存在します。
- 通常の業務連絡や友人からのメールに特定の単語が多く含まれていると、システムが誤って迷惑メールとして分類する危険性があります。
- 迷惑メールの送信者が確率の計算を回避するために、意図的に通常の単語を多用したり単語の綴りを変えたりした場合、システムによる検知が難しくなります。
ベイズの定理における数式の構造
特定の単語が含まれるという条件のもとで、メールが迷惑メールである確率を計算する際、計算式は分数の形をとります。迷惑メールであるという事象をA、特定の単語が含まれるという事象をBとした場合、計算式は以下のようになります。
$$P(A\vert{}B) = \frac{P(B\vert{}A)P(A)}{P(B)}$$
数式内のP(A)はメールが迷惑メールである元の確率を表し、P(B|A)は迷惑メールの中に特定の単語が含まれる確率を表します。これらの数値を掛け合わせ、特定の単語が出現する全体の確率P(B)で割ることにより、求める確率P(A|B)を算出します。
まとめ
ベイズの定理を用いた迷惑メールフィルタは、過去のデータを学習して確率を計算し、効率的な分類を実現します。一方で、誤分類の可能性や新しい手法への対応といった課題も抱えています。
確率や統計の仕組みについて理解を深めるためには、以下の順番で学習を進めることをお勧めします。
- 確率の基礎を学び、複数の事象が同時に起こる確率の計算方法を身につける
- 条件付き確率の概念を学習し、原因と結果の確率を逆算する考え方を理解する
- 統計学の入門書を読み、ベイズ推定の基本定理を習得する
- 簡単な単語リストを用意し、それぞれの出現確率から分類を行うプログラムを作成する
セイ・コンサルティング・グループでは新人エンジニア研修のアシスタント講師を募集しています。
投稿者プロフィール