Huber損失関数の仕組みと計算式:二乗誤差と絶対値誤差を組み合わせた損失関数の基礎
 山崎講師
こんにちは。ゆうせいです。
機械学習や回帰分析のモデルを構築する際、予測値と実際の値のずれを数値化して評価する尺度として損失関数が用いられます。その代表的な選択肢の1つにHuber損失(ヒューバーそんしつ)があります。
Huber損失は、代表的な損失関数である二乗誤差と絶対値誤差の双方の長所を組み合わせた設計を持ち、機械学習の実務において外れ値に対する頑健性を確保するために広く採用されています。
本記事では、Huber損失の概念、数式の構造、特徴となる利点と留意点、そして理解を深めるための学習順序について解説します。
損失関数の基本とHuber損失の位置づけ
回帰分析におけるモデル学習の目的は、予測値と実際の計測値との差である誤差を最小限に抑えることです。この誤差の大きさを計算してペナルティを与える関数を損失関数と呼びます。
的当てゲームによる比喩
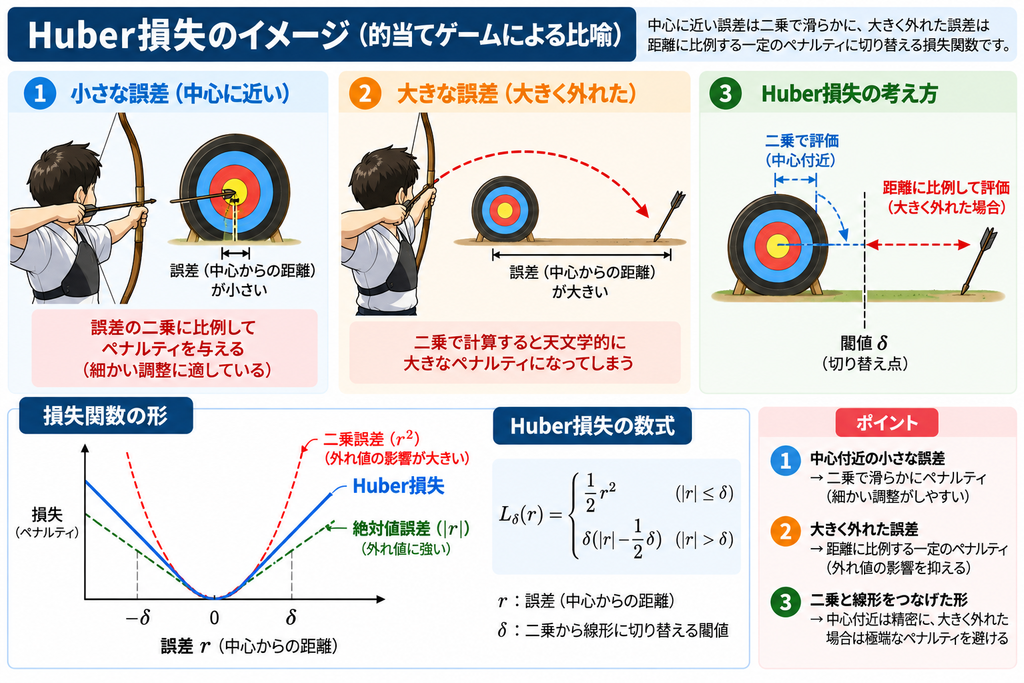
高校の弓道やアーチェリーにおける的当てを想定します。
中心を狙って矢を放ったとき、中心から外れた距離が誤差に相当します。
中心からわずかに数センチメートルずれた場合、その微小な誤差を細かく修正するために、外れた距離の二乗に比例したペナルティを与える評価方法が存在します。中心に近い位置での調整に適した手法です。
一方で、突風などの偶発的な要因で的を大きく外れ、数百メートル離れた場所に矢が落ちてしまった場合、距離の二乗で計算すると天文学的な大きさのペナルティが発生し、弓の引き方の調整全体が極端に崩れてしまいます。
Huber損失は、中心に近い小さな誤差に対しては距離の二乗で滑らかにペナルティを与え、大きく外れた誤差に対しては距離そのものに比例する一定のペナルティへと切り替える仕組みを持っています。
構成する要素と記号の整理
Huber損失の定義に用いられる記号の意味を整理します。
- y:実際の観測値(正解ラベル)
- f(x):モデルによる予測値
- e:誤差(e = y - f(x))
- δ(デルタ):二乗での計算と絶対値での計算を切り替える境目となる閾値(ハイパーパラメータ)
Huber損失の定義式と構造
Huber損失 L(e) は、誤差 e の絶対値の大きさが閾値 δ 以下であるか、あるいは δ を超えているかによって適用する計算式を条件分岐させます。

この関数は、境界点である |e| = δ において関数値とその傾き(一次導関数)が連続的につながるよう数学的に調整されています。
誤差が小さい領域での動作
誤差の絶対値が閾値 δ 以下の領域では、計算式は次の形をとります。

二乗誤差(Mean Squared Error)と同様に、誤差の大きさに応じて二乗でペナルティが増加します。この区間では関数全体が滑らかな曲線を描くため、勾配降下法などの最適化計算において微分値が誤差に比例して0へと滑らかに収束します。
誤差が大きい領域での動作
誤差の絶対値が閾値 δ を超える領域では、計算式は次の形をとります。

絶対値誤差(Mean Absolute Error)と同様に、誤差に対して直線(線形)でペナルティが増加します。後半の引き算部分は、境界値 |e| = δ において二乗誤差側の値と段差なく滑らかに接続するための補正項です。大きな外れ値が発生しても二乗のように急激に値が跳ね上がらないため、極端なデータに最適化処理が過剰に引っ張られる現象を防ぎます。
Huber損失の利点と留意点
Huber損失の導入には、工学的な利点と運用上の制約が存在します。
利点
- 外れ値に対する頑健性(ロバスト性)測定機器の異常値やノイズなど、極端に離れたデータが含まれていても、ペナルティが線形にとどまるためモデル全体の学習精度が保たれます。
- 中心付近における滑らかな勾配絶対値誤差では誤差が0となる中心点で関数が尖っており、数学的に微分不可能となりますが、Huber損失は誤差0の周辺が二乗誤差の滑らかな形状を持つため、勾配に基づく最適化アルゴリズムが安定して収束します。
留意点
- 閾値 δ の選定作業の発生二乗誤差と絶対値誤差を切り替える境界値 δ をあらかじめ人間側で決定(チューニング)する必要があります。データの単位やばらつきの大きさに応じて適切な値を探索する工数が生じます。
- 計算式の分岐による実装・計算の負荷単純な二乗誤差と比較して、条件分岐を伴うため数理的な取り扱いがやや複雑になり、解析的な解を直接得ることが難しくなります。
まとめ
Huber損失は、二乗誤差の滑らかな収束性と、絶対値誤差の外れ値に対する強さを両立させた損失関数です。
- 誤差が小さい区間では二乗の計算を用いて中心への安定した収束を図る
- 誤差が大きい区間では線形の計算に切り替えて外れ値の影響を低減する
- 閾値 δ によって二乗計算と線形計算の切り替え基準を制御する
Huber損失の学習を進める際は、次の段階に沿って理解を深める方法が有効です。
- 二乗誤差(MSE)と絶対値誤差(MAE)のグラフの形状と、それぞれの微分値(勾配)の違いを確認する。
- 誤差 e の値(例:0.5、1.0、2.0、5.0など)と特定の閾値(例:δ = 1.0)を設定し、手計算でHuber損失の値を算出して数値の変化を確認する。
- 閾値 δ の値を変化させたときに損失関数の形状がどのように推移するかを比較する。
- 正則化や分類問題における損失関数(クロスエントロピー誤差など)へと対象を広げ、解くべき問題に適した損失関数の選定手法を整理する。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 新人エンジニア研修講師2026年10月24日MAP推定の公式の覚え方と最尤推定に事前分布を加える計算手順
 新人エンジニア研修講師2026年10月24日最尤推定と対数尤度の公式の覚え方と積を対数で和に変える計算手順
 新人エンジニア研修講師2026年10月24日ベルヌーイ分布と二項分布の公式の覚え方と成功確率を用いた計算手順
 新人エンジニア研修講師2026年10月24日周辺化(周辺確率)の公式の覚え方と不要な変数を足し合わせて消す計算手順