統計検定2級 対策テキスト 第1回|試験の概要と出題範囲、データの種類と分布の見方
 山崎講師
こんにちは。ゆうせいです。
統計検定2級は、大学の基礎科目レベルの統計学を、どれだけ理解し、活用できるかを問う試験です。データ分析や機械学習を学ぶ前の土台として、受験を勧める企業も増えています。一方で、「出題範囲が広くて、どこから手を付ければよいか分かりません」という声もよく聞きます。
この連載は、公式の出題範囲表に沿って、全10回で2級の範囲をひととおり学べるように作った対策テキストです。各回は、解説、数値例、確認の問い、4択の確認問題の順に進みます。第1回の今回は、試験の概要と学習の進め方を確認したうえで、出題範囲表の最初の項目である「データソース」と「データの分布」を学びます。
この回で学ぶこと
- 試験の形式と、全10回の学習計画
- データの種類(質的変数と量的変数、4つの尺度)
- 度数分布表、ヒストグラム、累積相対度数
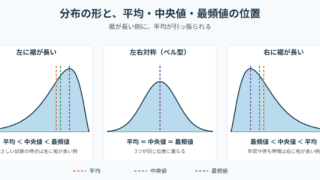
- 分布の形と、平均・中央値・最頻値の位置関係
- データの集め方と公的統計
1. 試験の概要
統計検定2級は、会場のパソコンで解答する CBT(Computer Based Testing)方式の試験です。公式サイトに掲載されている試験の概要は、次のとおりです。
- 出題形式:4〜5肢の選択問題
- 問題数:35問程度
- 試験時間:90分
- 合格水準:100点満点で60点以上
- 電卓:四則演算、百分率、平方根が計算できる普通の電卓を1台持ち込める。関数電卓は使えない
1問あたりに使える時間は、90分 ÷ 35問 = 約2分半です。計算に時間のかかる問題もあるので、「式を見てすぐに手が動く」状態まで練習しておくことが合格の条件になります。受験料や申し込みの方法は変わることがあるため、受験の前に公式サイトで確認してください。
出題範囲と全10回の対応
出題範囲は、3級と4級の内容に加えて、次の項目です。この連載では、右側に示した回で扱います。
- データソース、データの分布:第1回(今回)
- 1変数データ(中心、散らばり、標準化など):第2回
- 2変数以上のデータ(相関、クロス集計表、単回帰、時系列):第3回
- 推測のためのデータ収集法(標本調査、実験):第4回
- 確率、確率変数:第5回
- 確率分布:第6回
- 標本分布:第7回
- 推定:第8回
- 仮説検定(カイ二乗検定を含む):第9回
- 線形モデル(回帰分析、分散分析)と出力の読み方:第10回
前半(第1回から第4回)はデータの整理と集め方、中盤(第5回から第7回)は確率、後半(第8回から第10回)は推測です。後半の推定と検定は配点が大きい分野ですが、中盤の確率分布と標本分布を理解していないと解けません。順番どおりに進めることをおすすめします。
ここで確認
問い:60点以上で合格するには、35問のうち、およそ何問に正解すればよいでしょうか。配点はすべて同じと仮定します。
答え:35 × 0.6 = 21 なので、21問以上の正解が目安です。14問までは間違えられる計算になります。
2. データの種類
データを分析するときは、最初に「どの種類のデータか」を確認します。種類によって、使えるグラフや計算が変わるからです。
- 質的変数(カテゴリカルデータ):種類や区分を表す。例:血液型、性別、満足度(満足・普通・不満)
- 量的変数:数量を表す。例:身長、点数、来店回数
量的変数は、さらに2つに分かれます。
- 離散型:1人、2人のように、とびとびの値をとる。例:兄弟の数、不良品の個数
- 連続型:切れ目なく、どんな値でもとりうる。例:身長、時間、重さ
測り方の水準(尺度)では、次の4つに分けられます。下に行くほど、できる計算が増えます。
- 名義尺度:区別するだけ。例:血液型、郵便番号。数えることしかできない
- 順序尺度:順序に意味がある。例:満足度の5段階、順位。大小は比べられるが、差に意味はない
- 間隔尺度:差に意味がある。例:気温(摂氏)、西暦。足し算と引き算ができるが、「2倍」とは言えない
- 比例尺度:0 に「何もない」という意味があり、比にも意味がある。例:身長、重さ、金額
気温が 10度から 20度になっても「2倍暑い」とは言えませんが、重さが 10kg から 20kg になれば「2倍重い」と言えます。この違いが、間隔尺度と比例尺度の違いです。
ここで確認
問い:次のデータは、それぞれどの尺度でしょうか。(ア)マラソンの順位 (イ)背番号 (ウ)体重 (エ)試験の偏差値
答え:(ア)順序尺度、(イ)名義尺度、(ウ)比例尺度、(エ)間隔尺度です。背番号は数字ですが、区別のための記号なので名義尺度です。偏差値は差に意味がありますが、「偏差値 60 は 30 の2倍」とは言えないので間隔尺度です。
3. 度数分布表とヒストグラム
量的なデータの全体の姿をつかむには、度数分布表を作ります。値の範囲をいくつかの区間(階級)に分け、それぞれに入るデータの個数(度数)を数えた表です。
20人の試験の点数を、10点刻みの階級にまとめた例を示します。
- 40点以上50点未満:2人(相対度数 0.10、累積相対度数 0.10)
- 50点以上60点未満:5人(相対度数 0.25、累積相対度数 0.35)
- 60点以上70点未満:7人(相対度数 0.35、累積相対度数 0.70)
- 70点以上80点未満:4人(相対度数 0.20、累積相対度数 0.90)
- 80点以上90点未満:2人(相対度数 0.10、累積相対度数 1.00)
用語を整理します。
- 相対度数:度数を全体の数で割った値。5人 ÷ 20人 = 0.25
- 累積相対度数:その階級までの相対度数の合計。0.10 + 0.25 = 0.35
- 階級値:階級の真ん中の値。50点以上60点未満なら 55点
累積相対度数を使うと、中央値がどの階級にあるかが分かります。中央値は、小さい順に並べてちょうど真ん中の値です。累積相対度数が初めて 0.5 を超えるのは「60点以上70点未満」(0.70)なので、中央値はこの階級にあります。
度数分布表を棒の形で表したものがヒストグラムです。棒グラフと似ていますが、ヒストグラムは棒どうしをすき間なく並べ、棒の面積が度数に比例するように描きます。階級の幅が違う場合は、高さではなく面積で比べる点に注意してください。
出題範囲表には、幹葉図(みきはず)も挙がっています。数値を「幹」(上の位)と「葉」(下の位)に分けて並べた図で、ヒストグラムの形と、もとの値の両方を読み取れます。たとえば 52、55、58、61、63 は、幹 5 に葉 2、5、8、幹 6 に葉 1、3 と書きます。
ここで確認
問い:上の度数分布表で、70点以上の人の割合はいくつでしょうか。また、階級値を使って平均を求めると何点になるでしょうか。
答え:70点以上の割合は 0.20 + 0.10 = 0.30 です。70点未満までの累積相対度数 0.70 を 1 から引いても求められます。階級値を使った平均は、(45 × 2 + 55 × 5 + 65 × 7 + 75 × 4 + 85 × 2) ÷ 20 = 1290 ÷ 20 = 64.5点です。
4. 分布の形を読む
ヒストグラムを描いたら、分布の形を確認します。出題範囲表には、次の言葉が挙がっています。
- 対称、ベル型:左右が同じ形で、中央が高い
- 右に裾が長い:山が左に寄り、右側に長く尾を引く
- 左に裾が長い:山が右に寄り、左側に長く尾を引く
- 一様:どの階級もほぼ同じ高さ
- 単峰、多峰:山が1つ、山が2つ以上
分布の形は、平均、中央値、最頻値(最も度数が多い値)の位置関係を決めます。
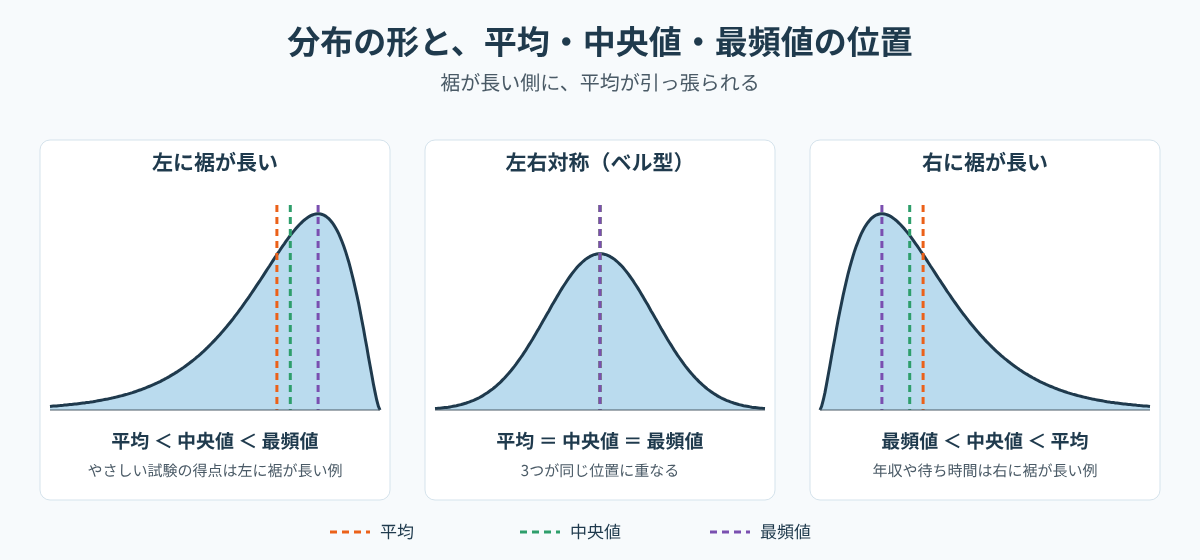
右に裾が長い分布では、「最頻値、中央値、平均」の順に大きくなります。少数の大きな値が、平均を右に引っ張るからです。5人の年収が 300万円、350万円、400万円、450万円、1500万円の場合、平均は 3000 ÷ 5 = 600万円ですが、中央値は 400万円です。5人のうち4人が平均より下にいます。
山が2つある多峰の分布を見たら、性質の違う2つの集団が混ざっている可能性を考えます。たとえば、男女を合わせた身長のデータです。
コラム なぜ平均は外れた値に引っ張られるのか
平均は、すべての値を足して個数で割ります。計算に全員の値を使うので、1つでも極端な値があると、その影響を受けます。一方、中央値は「真ん中の順位の値」です。いちばん大きい値が 1500万円でも 1億円でも、真ん中の人の値は変わりません。
シーソーにたとえると分かりやすくなります。平均は、シーソーがつり合う支点の位置です。遠くに1人が座ると、支点をそちらに大きく動かさないとつり合いません。中央値は、座っている人数が左右で同じになる位置です。遠くに座っても近くに座っても、1人は1人として数えます。
年収や貯蓄額のように右に裾が長いデータでは、「平均」と「ふつうの人の実感」がずれます。こうしたデータを要約するときは、平均だけでなく中央値もあわせて示すのが基本です。
問い:10人のうち9人の貯蓄が 100万円、1人の貯蓄が 9100万円のとき、平均と中央値はそれぞれいくらでしょうか。
答え:平均は (100 × 9 + 9100) ÷ 10 = 1000万円、中央値は 100万円です。平均の 1000万円は、10人のうち9人の実態を表していません。
ここで確認
問い:ある分布の平均が 52、中央値が 60 でした。この分布は、右と左のどちらに裾が長いと考えられるでしょうか。
答え:平均が中央値より小さいので、小さい側の値が平均を引き下げています。左に裾が長い分布だと考えられます。
5. データの集め方と公的統計
分析に使うデータの出どころを、データソースと呼びます。出題範囲表の最初の項目は、「身近な統計」と公的統計です。
国や自治体が作る統計を、公的統計と呼びます。代表的な例を挙げます。
- 国勢調査:日本に住むすべての人と世帯が対象。5年ごとに行う
- 労働力調査:就業の状況を毎月調べ、完全失業率などを公表する
- 家計調査:世帯の収入と支出を調べる
- 消費者物価指数:商品やサービスの価格の動きを、基準の時点を 100 とした指数で表す
調査の方法は、大きく2つに分かれます。
- 全数調査:対象の全員を調べる。国勢調査が代表例。正確だが、費用と時間がかかる
- 標本調査:対象の一部を選んで調べ、全体を推測する。労働力調査や家計調査が代表例
標本調査で全体を正しく推測するための選び方は、第4回で学びます。
ここで確認
問い:テレビの視聴率は、全数調査と標本調査のどちらで調べられているでしょうか。理由も答えてください。
答え:標本調査です。すべての世帯の視聴状況を調べるには費用と時間がかかりすぎるため、一部の世帯を選んで調べ、全体の視聴率を推測しています。
確認問題
問1
次の変数のうち、比例尺度のデータを1つ選んでください。
- 好きな色を番号で表した値
- 1か月に読んだ本の冊数
- 摂氏で測った最高気温
- 5段階で答えた満足度
問1の解答と解説
正解は 2 です。
- 1 は誤りです。色を区別するための番号なので、名義尺度です
- 2 が正解です。0冊は「読んでいない」ことを表し、4冊は2冊の2倍と言えるので、比例尺度です
- 3 は誤りです。摂氏の 0度は「温度がない」という意味ではなく、比に意味がないので、間隔尺度です
- 4 は誤りです。順序に意味はありますが、段階の間隔が等しいとは限らないので、順序尺度です
問2
右に裾が長い単峰の分布について、平均、中央値、最頻値の大小関係として、最も適切なものを1つ選んでください。
- 平均 < 中央値 < 最頻値
- 中央値 < 平均 < 最頻値
- 最頻値 < 平均 < 中央値
- 最頻値 < 中央値 < 平均
問2の解答と解説
正解は 4 です。
- 1 は誤りです。左に裾が長い分布での大小関係です
- 2 と 3 は誤りです。中央値は、平均と最頻値の間に来るのが一般的です
- 4 が正解です。右側の大きな値が平均を引き上げるため、平均が最も大きくなります。山の頂上にあたる最頻値が最も小さくなります
講師向けの補足
- 尺度の分類は、暗記させるよりも「この計算はできるか」を問うほうが定着します。「背番号の平均に意味はあるか」「気温の比に意味はあるか」と問いかけてください
- ヒストグラムと棒グラフの違いは、初学者が混同しやすい点です。階級の幅が違う例を1つ見せ、「高さではなく面積で比べる」ことを確認します
- 平均と中央値の違いは、年収の例を受講者に計算してもらうと実感できます。「あなたの会社の平均年収は、何人目の人の値に近いでしょうか」と問うと、議論が広がります
- 初回に全10回の地図を示し、「後半の推定と検定のために、前半と中盤がある」と伝えておくと、途中で目的を見失いにくくなります
まとめ
- 統計検定2級は、CBT方式、35問程度、90分、60点以上で合格
- データは質的変数と量的変数に分かれ、尺度は名義、順序、間隔、比例の4つ
- 度数分布表では、相対度数と累積相対度数を使って割合や中央値の位置を読み取る
- 右に裾が長い分布では、最頻値、中央値、平均の順に大きくなる
- 公的統計には全数調査と標本調査があり、国勢調査は全数調査の代表例
次回は、1変数データの要約を学びます。平均や標準偏差の計算、箱ひげ図、標準化、ジニ係数など、計算問題としてよく出る内容です。
統計検定は、一般財団法人統計質保証推進協会の登録商標です。この記事の例題と問題は、公表されている出題範囲表をもとに独自に作成したもので、過去の試験問題ではありません。
投稿者プロフィール