ソフトマックス関数がなぜネイピア数eを使うのか:確率分布と情報理論の視点
 山崎講師
こんにちは。ゆうせいです。
ディープラーニングで分類問題を学ぶ際、必ず登場するのがソフトマックス関数です。その式を見ると、ネイピア数e(およそ2.718)を使った指数が入っています。なぜわざわざeの指数なのか、という疑問は自然なものです。eではなく、他の底(例えば2や10)を使ってはいけないのでしょうか。本記事では、その理由を四つの視点から解説します。
- 微分と勾配の計算を簡潔にできる
- 指数族や最大エントロピーの表現と相性がよい
- 自然対数を使う交差エントロピーと組み合わせやすい
- max-shiftやlog-sum-expによって数値的に安定して計算できる
ソフトマックス関数の式をおさらい
まず、ソフトマックス関数を改めて示します。

K個の入力 x_1, x_2, ..., x_K を受け取り、合計が1になる確率分布に変換します。
ここでの疑問は明快です。なぜ e^{x_k} なのか。例えば 2^{x_k} ではダメなのか。結論から言うと、技術的には他の底でも分類はできます。しかし、eを選ぶことで、数学的に深い理由と計算上の利点が生まれるのです。
理由1:微分計算が美しくなる
ソフトマックス関数を使った学習では、誤差逆伝播を行う際に関数の微分が必要になります。
e^x は微分してもe^x のままという極めて特殊な性質を持っています。

一方、2^x を微分するとどうなるでしょうか。

微分後に ln 2 という係数が付きます。このような係数は計算を複雑にします。
ソフトマックス関数の微分も実際に計算すると、eの指数があるおかげで、計算が比較的シンプルになります。誤差逆伝播のアルゴリズムでは、この微分を何度も繰り返すため、余分な係数がないことは処理速度に直結します。
理由2:確率分布として最も「自然な」選択
統計学に「最大エントロピーの原理」という考え方があります。簡潔に述べると、制約条件の下で、最も情報量が大きい(不確定性が高い)確率分布を選ぶべき、という原理です。
数学的には、以下の事実が知られています。ネイピア数e を使った指数族の分布(ボルツマン分布)が、与えられた平均値という制約の下で、最大エントロピーを実現します。

Z は正規化定数、E(x) はエネルギー関数です。
分類問題では、複数のクラスの平均スコアが与えられたとき、それらの値だけを満たす確率分布の中で、最も「偏らない」ものを選ぶのが理にかなっています。その最も「偏らない」分布を与えるのが、eの指数を使ったソフトマックス関数なのです。
言い換えると、eは単なる「便利な数字」ではなく、確率論から自然に浮かび上がる数なのです。
理由3:情報理論との深い関係
情報理論の世界では、確率の自然対数 ln P(x) がよく登場します。
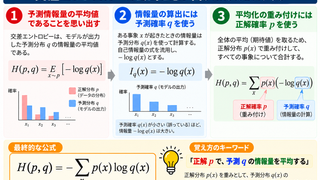
交差エントロピー損失は、以下のように書かれます。

ここで ln は自然対数(底がe)です。試験や教材では log と書かれることもありますが、深層学習の文脈では底がe の対数を指すことがほとんどです。
なぜ自然対数なのか。それは、情報理論の公式では、自然対数を使うと、各種の性質(加法性、微分可能性、極限の性質)がすべて美しく成立するからです。
ソフトマックス関数の出力 y_k に対して、損失関数で -ln y_k が登場するとき、両者がeの指数を使っていると、計算グラフ全体が数学的に調和します。片方がeの指数で、もう片方が底10の対数だったら、計算が複雑になり、数値的な不安定性も増すのです。
理由4:数値安定性の実装との関係
実装時には、「log-sumexp trick」という数値計算テクニックが頻出します。
ソフトマックスの出力を計算する際、もし x_k の値が非常に大きい場合、e^{x_k} は大きすぎて浮動小数点数でオーバーフロー(数値がコンピュータの表現上限を超える)してしまいます。
これを防ぐため、以下の変形を使います。

ここで m は x_1, x_2, ..., x_K の最大値です。分子分母の両辺から同じ値を引いているので、結果は変わりません。しかし、数値計算上は、各 e の指数の引数が小さくなり、オーバーフロー/アンダーフローを避けられます。
この変形が成り立つのは、e^{a-b} = e^a / e^b という指数法則があるからです。これは底がeだからこそ成立する性質です。底が2だったら、この式の形式は同じですが、計算ライブラリ全体での数値安定性の実装が異なってくるのです。
実は、ここに深い理由が隠れています。機械学習の数値計算では、e の指数と自然対数が対になって、数値安定性を保つための様々な工夫に使われます。この対称性があるからこそ、e が「標準」なのです。
他の底を使ったらどうなるか
理論的には、底2を使った「ソフトマックス関数」を定義することもできます。

x_k の値が小さい場合、この関数も合計が1になる確率分布を与えます。分類精度も大きくは変わらないでしょう。
ただし、損失関数を計算する際に、底2の対数を使わなければ理論的に一貫性がなくなります。さらに、微分や数値安定性の実装で、エレガントさを失い、計算コストが増えます。
つまり、底2でも「動く」コードは書けますが、「美しく、安定した」システムにはならない、ということです。
視覚的な理解
ソフトマックスの出力を具体例で見てみます。入力が [1, 2, 3] のとき、
e^1 = 2.72, e^2 = 7.39, e^3 = 20.09
合計は30.2になり、出力は [0.09, 0.24, 0.67] になります。
もし底2を使った場合、
2^1 = 2, 2^2 = 4, 2^3 = 8
合計は14になり、出力は [0.14, 0.29, 0.57] になります。
同じ入力に対して、底が変わると出力の確率分布形が変わります。eを使った場合は、最大値(3)との差が大きい入力ほど、相対的に確率が落ちる傾向が強くなります(勾配が急)。これが、ディープラーニングの学習を安定させるのに適した形になっているのです。
グラフで見るソフトマックス関数
ここまで、入力 [1, 2, 3] を例にして、底がeの場合と底が2の場合を比較しました。
今度は、入力値を少しずつ変化させてグラフで確認してみましょう。
2クラス分類を考え、2つのクラスのスコアを
[0, d]
とします。
d は、2つのクラスの「スコアの差」です。
底eのソフトマックスでは、スコアがdであるクラスの確率は次のようになります。

一方、底を2にすると、

となります。
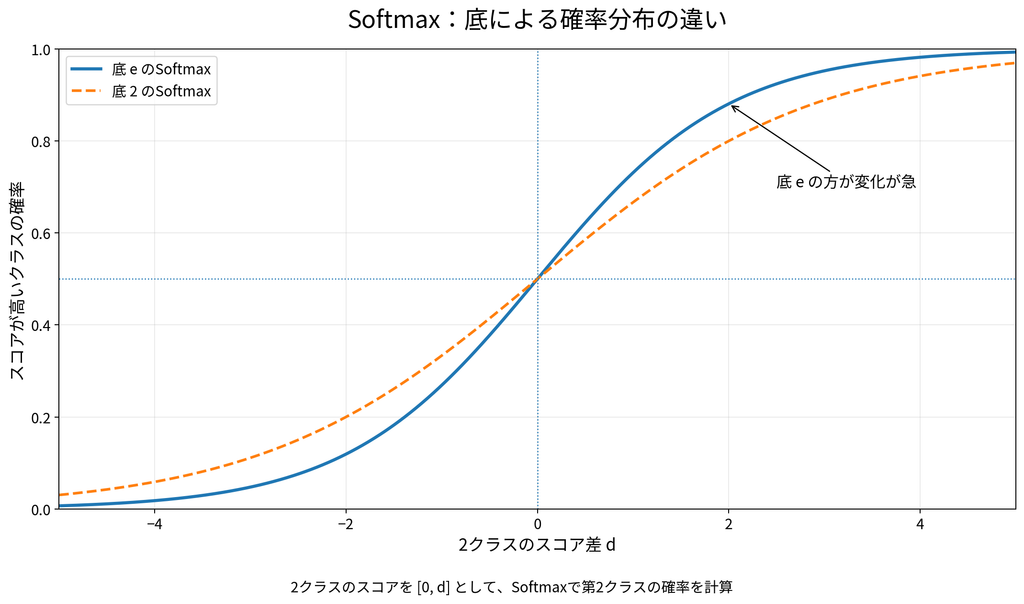
d=0 のとき、2つのクラスのスコアは同じなので、どちらの場合も確率は0.5です。
d がプラスになると、スコアの高いクラスの確率が上昇します。
また、底eの方が底2よりも曲線の変化が急になっています。
つまり、同じスコア差であっても、底によって「どの程度自信を持った確率に変換するか」が変わります。
ただし、ここで重要なのは、
eだけがソフトマックスを実現できるわけではない
ということです。
2や10などの他の正の底を使っても、確率分布を作ることはできます。
それでもeが標準的に使われている最大の理由は、微分や自然対数との関係が非常にシンプルになるからです。
言い換えれば、
eは唯一可能な数字ではなく、数学的に最も自然で扱いやすい数字
なのです。
練習問題
問題1
ソフトマックス関数の主な役割は何でしょうか?
解答
複数のスコアを、
合計が1になる確率分布
に変換することです。
例えば、ニューラルネットワークが
[1, 2, 3]
という3つのスコアを出力した場合、ソフトマックス関数を使うことで、
「クラスAである確率」
「クラスBである確率」
「クラスCである確率」
のように解釈できる値へ変換できます。
問題2
入力が [1, 2, 3] のとき、最も高い確率になるのはどの入力でしょうか?
解答
3です。
ソフトマックス関数では、入力値が大きいほど指数関数によって大きな値に変換されるためです。
ただし、3がそのまま確率になるわけではありません。
すべての指数値の合計で割ることで、最終的な確率が求められます。
問題3
ソフトマックス関数でeを使う大きな数学上の利点は何でしょうか?
解答
eの指数関数は、微分しても形が変わりません。

ニューラルネットワークでは、誤差逆伝播によって何度も微分を行います。
そのため、微分後も同じ形になるeの指数関数は非常に扱いやすいという利点があります。
問題4
ソフトマックス関数では、必ずeを使わなければならないでしょうか?
解答
いいえ。
例えば、底2を使って

と定義しても、合計が1になる確率分布を作ることができます。
ただし、eを使うと微分や自然対数との関係がシンプルになるため、数学・統計学・機械学習ではeを使う形が標準になっています。
問題5
2クラスのスコアが [0, 0] のとき、ソフトマックス後の確率はいくつになるでしょうか?
解答
[0.5, 0.5]
です。
2つのスコアが同じなので、
e^0 = 1
となり、
1 ÷ (1+1) = 0.5
です。
どちらのクラスにも同じ確率が割り当てられます。
問題6
2クラスのスコアが [0, 2] の場合、スコア2のクラスの方が高い確率になるのはなぜでしょうか?
解答
指数関数によって、入力値の差が拡大されるからです。
底eの場合、
e^0 = 1
e^2 ≒ 7.39
となります。
したがって、スコア2のクラスの確率は、

約0.88となります。
単に「2は0より大きい」というだけでなく、その差を指数関数で強調してから確率へ変換しているのがソフトマックス関数の特徴です。
問題7
ソフトマックス関数の計算前に、すべてのスコアから最大値を引いても結果が変わらないのはなぜでしょうか?
例えば、
[1001, 1002, 1003]
を
[-2, -1, 0]
として計算しても、ソフトマックスの結果は同じです。
解答
すべての指数値に共通する倍率が、分子と分母で打ち消されるためです。
最大値をmとすると、

は、

となります。
分子と分母に共通する 1/e^m が打ち消されるため、結果は元のソフトマックスと同じです。
この方法によって、大きすぎる指数値を計算せずに済み、オーバーフローを防ぐことができます。
理解度チェック
最後に、次の問いを考えてみてください。
「ソフトマックス関数でeを使う理由を一言で説明するとしたら?」
一つの答えは、
「eを使うと、指数関数・微分・対数が最も自然につながるから」
です。
ソフトマックス関数にeが登場するのは、単なる決まりごとではありません。
ニューラルネットワークの学習で重要となる
指数関数
↓
確率
↓
対数
↓
微分
↓
誤差逆伝播
という一連の計算を、シンプルな数学でつなげる役割をeが果たしているのです。
情報理論から見た必然性
最後に、最も根本的な視点を示します。
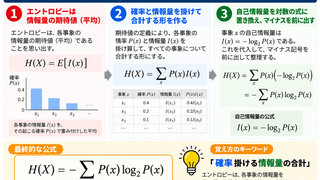
確率分布 P(x) に対して、その「情報量」を測る指標をエントロピーといいます。

ここで log は底がeの自然対数です。
「与えられたデータの平均値という制約の下で、このエントロピーを最大にする確率分布は何か」という最適化問題を解くと、ボルツマン分布 P(x) ∝ e^{λx} という形が現れます。
つまり、ネイピア数eは、情報理論の最適性条件から自然に湧き出してくる定数なのです。分類問題でソフトマックスを使うのは、情報理論の第一原理から導かれた選択と言えるのです。
まとめ
ソフトマックス関数がネイピア数eの指数を使う理由は、単なる慣習ではなく、以下の四つの層から支えられています。
微分計算がシンプルになる数学的性質。確率分布としての最大エントロピー性。交差エントロピー損失との情報理論的な調和。数値安定性の実装との一貫性。
さらに根底には、情報理論から自然に導かれるボルツマン分布という最適性の理論があります。
ディープラーニングの一見すると「使い方」の問題に見える話題も、実は数学と物理学の深い原理に根ざしているという事実は、学習を続ける上での知的な充実感につながるでしょう。
次のステップとして、指数族分布とボルツマン分布の関係を学んだり、具体的な実装で log-sumexp trick がどのように使われているかを確認したりすることをお勧めします。その学習を通じて、理論と実装の結びつきがより深く理解できるようになるでしょう。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。