オプティマイザの歴史を物語で学ぶ|勾配降下法からモーメンタム、AdaGrad、RMSProp、Adam、AdamW、Muonまで
 山崎講師
こんにちは。ゆうせいです。
ディープラーニングの研修でオプティマイザ(最適化手法)を扱うと、SGD、モーメンタム、AdaGrad、RMSProp、Adam、AdamW と、似た名前の手法が並びます。受講者から「結局どれを使えばよいのか」「式が少しずつ違うのはなぜか」と質問されることも多いのではないでしょうか。
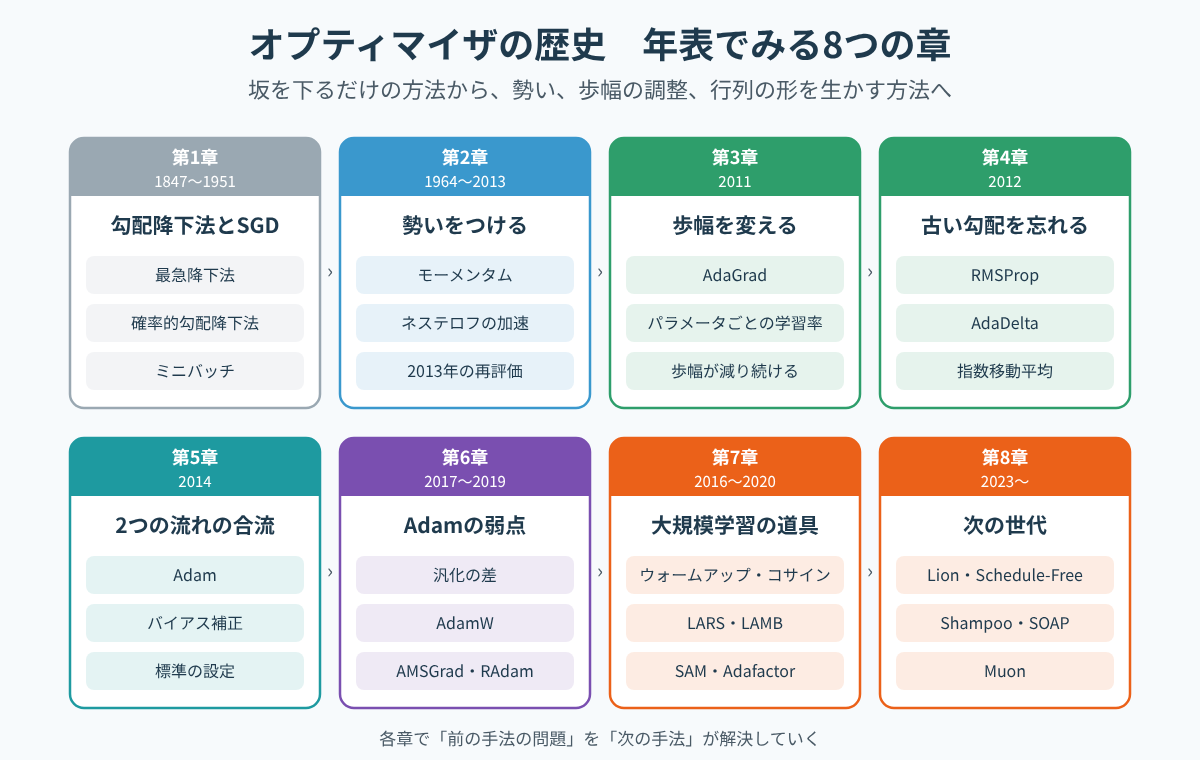
オプティマイザの式は、ばらばらに覚えようとすると大変です。しかし、「前の手法が抱えていた問題を、次の手法が式のどこを変えて解決したか」という流れで並べると、1本の物語として理解できます。今回は、オプティマイザの歴史を、その始まりから2026年の最新の動向まで、物語の形でたどります。各章の終わりには、受講者の理解を確かめる問いを用意しました。E資格の学習や、ディープラーニング研修の最適化の単元に活用してください。
序章 オプティマイザとは何か
ニューラルネットワークの学習は、予測と正解のずれを表す値(損失)が小さくなるように、重み(パラメータ)を少しずつ直していく作業です。誤差逆伝播法は、それぞれの重みについて「増やすと損失がどれだけ増えるか」を表す勾配を計算します。その勾配を使って、重みを実際にどれだけ動かすかを決める係が、オプティマイザです。
霧の中で山を下る登山者にたとえられます。周りは見えませんが、足元の傾き(勾配)だけは分かります。どの向きに、どれくらいの歩幅で進めば、早く安全に谷底(損失が最小になる場所)へ着けるでしょうか。歩幅にあたる値を、学習率と呼びます。
オプティマイザの歴史は、この「歩き方」の工夫の歴史です。登場する工夫は、大きく3つに分けられます。
- 勢いを使う:過去に進んだ向きを覚えておき、同じ向きには加速する
- 歩幅を調整する:パラメータごとに、適切な歩幅を自動で決める
- 行列の形を生かす:重みを1つずつばらばらに扱わず、層の重みを行列としてまとめて扱う
第1章 勾配降下法と SGD(1847〜1951)
最も急な坂を下る
物語は、コンピュータが生まれる100年前の1847年に始まります。フランスの数学者オーギュスタン=ルイ・コーシーは、関数の値が最も急に減る向きに少しずつ進むことで、最小値を探す方法を発表しました。勾配降下法(最急降下法)です。

各記号の意味は次のとおりです。
- w_t:t 回目の更新の前の重み
- g_t:その時点の勾配
- η(イータ):学習率。1回にどれだけ重みを動かすかを決める値
数値で確認します。損失が L = w² で表されるとすると、勾配は 2w です。w = 1 から始めて、学習率を 0.1 とすると、重みは 1 - 0.1 × 2 = 0.8 になります。繰り返すと 0.8 → 0.64 → 0.512 と、最小値の 0 に近づいていきます。
学習率が大きすぎる場合も確認します。学習率を 1.1 にすると、重みは 1 - 1.1 × 2 = -1.2 になり、谷底を飛び越えて反対側のより高い場所に着いてしまいます。繰り返すと -1.2 → 1.44 → -1.728 と、どんどん遠ざかります。この状態を発散と呼びます。反対に、学習率が小さすぎると、いつまでたっても谷底に着きません。学習率の決め方は、最初から現在まで続く課題です。
SGD:一部のデータで少しずつ進む
勾配降下法を機械学習に使うとき、正確な勾配を求めるには、すべての学習データを使って計算する必要があります。データが何百万件もあると、1歩進むだけで膨大な計算がかかります。
1951年、ハーバート・ロビンスとサットン・モンローは、ばらつきを含む観測値を使って少しずつ答えに近づく方法を発表しました。この考え方が、確率的勾配降下法(SGD)の土台になりました。SGD は、すべてのデータではなく、ランダムに選んだ一部のデータ(ミニバッチ)だけで勾配を計算し、すぐに重みを更新します。
1歩ごとの向きは正確ではなく、少しふらつきます。しかし、1歩にかかる計算が大幅に少ないため、同じ時間でずっと多くの歩数を進められます。全員に聞き取り調査をしてから方針を決めるのではなく、数十人に聞いたらすぐに動き、また次の数十人に聞く進め方です。
残された問題
SGD には、次の問題がありました。
- 細長い谷で振動する:ある方向には急で、別の方向にはなだらかな形の谷では、急な方向に行ったり来たりを繰り返し、なだらかな方向にはなかなか進めない
- 学習率の調整が難しい:大きすぎると発散し、小さすぎると進まない
- すべてのパラメータに同じ学習率を使う:パラメータごとに適切な歩幅が違っても、区別できない
ここで確認
問い:SGD は、すべてのデータを使う勾配降下法と比べて、何が優れているのでしょうか。
答え:一部のデータだけで勾配を計算するため、1回の更新にかかる計算が少なく、同じ時間で多くの回数の更新を行える点です。
第2章 勢いをつける:モーメンタム(1964〜2013)
転がるボールのように
細長い谷での振動を抑えるために考えられたのが、モーメンタム(運動量)です。1964年、ソビエト連邦の数学者ボリス・ポリャクが発表しました。
登山者の代わりに、坂を転がるボールを想像してください。ボールは、それまでの勢いを保ったまま進みます。行ったり来たりする方向の動きは打ち消し合い、ずっと同じ向きに下っている方向には、どんどん加速します。


各記号の意味は次のとおりです。
- v_t:速度。過去の勾配を積み重ねたもの
- β(ベータ):過去の速度をどれだけ残すかを決める値。0.9 がよく使われる
数値で確認します。β = 0.9 で、勾配が毎回同じ向きに 1 だとします。速度は 1 → 1.9 → 2.71 と増えていき、最終的には 10 に近づきます。同じ向きの勾配が続くと、歩幅が最大で10倍になるのです。
反対に、勾配の符号が毎回 +1、-1 と入れ替わる場合、速度は互いに打ち消し合い、大きさは約 0.53 に収まります。往復する方向の動きは約半分に抑えられます。
ネステロフの加速
モーメンタムには、勢いが付きすぎて谷底を行き過ぎるという弱点があります。1983年、ユーリ・ネステロフは、「今いる場所」ではなく「勢いで進んだ先の場所」の勾配を使う方法を発表しました。進む先の様子を先に見て、行き過ぎそうならブレーキをかける考え方です。ネステロフの加速勾配法(NAG)と呼ばれます。
2013年の再評価
モーメンタムは、古くからニューラルネットワークの学習に使われていましたが、その重要性が改めて示されたのは2013年です。イリヤ・サツケバーらは、重みの初期値とモーメンタムの設定を適切に選べば、それまで特別な方法が必要だと考えられていた深いネットワークも、SGD で学習できることを示しました。現在でも、画像認識の CNN の学習では、モーメンタム付きの SGD が広く使われています。
残された問題
モーメンタムは「進む向き」を改善しましたが、学習率はすべてのパラメータで共通のままでした。頻繁に更新されるパラメータと、めったに更新されないパラメータに、同じ歩幅を使うことになります。
ここで確認
問い:モーメンタムは、SGD のどのような問題を解決したのでしょうか。
答え:細長い谷で振動して進まない問題です。過去の勾配を積み重ねた速度を使うことで、往復する方向の動きを打ち消し、同じ向きが続く方向には加速して進めるようにしました。
第3章 歩幅をパラメータごとに変える:AdaGrad(2011)
めったに出てこない特徴を大切にする
2011年、ジョン・ドゥーチらは、パラメータごとに学習率を自動で変える AdaGrad を発表しました。
文章を扱うモデルを考えます。「です」のようによく出てくる単語に関係するパラメータは、頻繁に更新されます。一方、専門用語のようにめったに出てこない単語に関係するパラメータは、まれにしか更新されません。まれな機会には、大きく学習させたいところです。
AdaGrad は、パラメータごとに、過去の勾配の2乗を足し合わせて記録します。そして、その合計の平方根で学習率を割ります。


各記号の意味は次のとおりです。
- G_t:過去の勾配の2乗の合計。パラメータごとに記録する
- ε(イプシロン):0 で割ることを防ぐための、ごく小さな値
これまでに大きな勾配を多く受け取ったパラメータは、G が大きくなるため歩幅が小さくなります。あまり更新されてこなかったパラメータは、G が小さいため歩幅が大きく保たれます。よく歩いた道は慎重に、あまり歩いていない道は大胆に進む方法です。
残された問題:歩幅が減り続ける
数値で確認します。学習率を 0.1 とし、勾配が毎回 1 だとします。G は 1、2、3 と増えていくので、歩幅は 0.1 ÷ √1 = 0.1、0.1 ÷ √2 ≒ 0.071、0.1 ÷ √3 ≒ 0.058 と小さくなります。100回目には 0.1 ÷ √100 = 0.01 です。
G は足し算しかしないため、増える一方です。学習が長く続くと、歩幅が小さくなりすぎて、谷底に着く前に学習が実質的に止まってしまいます。ディープラーニングのように何万回も更新を繰り返す学習では、大きな問題でした。
ここで確認
問い:AdaGrad の長所と短所を、それぞれ1つずつ挙げてください。
答え:長所は、パラメータごとに学習率を自動で調整し、あまり更新されないパラメータを大きく学習させられることです。短所は、過去の勾配の2乗を足し続けるため、学習率が小さくなり続け、学習が途中で進まなくなることです。
第4章 古い勾配を忘れる:RMSProp と AdaDelta(2012)
足し続けるのをやめる
AdaGrad の問題への答えは、「古い記録を少しずつ忘れる」ことでした。2012年、ジェフリー・ヒントンは、オンライン講義の中で RMSProp を紹介しました。論文としてではなく、講義のスライドで発表された手法として知られています。同じ年には、マシュー・ザイラーが、同じ考え方に基づく AdaDelta を発表しています。
RMSProp は、勾配の2乗を足し続ける代わりに、指数移動平均を使います。


指数移動平均は、新しい値を少し取り入れ、古い値を少しずつ薄めていく平均の取り方です。β = 0.9 なら、古い記録を 9割残し、新しい勾配の2乗を1割加えます。最近の勾配ほど強く反映され、ずっと前の勾配の影響は消えていきます。
数値で確認します。β = 0.9 で、勾配が毎回 1 だとします。v は 0.1 → 0.19 → 0.271 と増えていき、最終的には 1 に近づいて止まります。AdaGrad の G のように増え続けることはないので、歩幅も小さくなり続けません。
残された問題
RMSProp には、2つの課題が残りました。
- 勢いがない:歩幅は調整できるが、第2章のモーメンタムのような、進む向きの勢いは持っていない
- 最初の値が偏る:v を 0 から始めるため、学習の最初のうちは、v が本来の値よりずっと小さくなる。上の例でも、本来 1 であるべき値が、1回目は 0.1 になっている
ここで確認
問い:RMSProp は、AdaGrad のどのような問題を、どのような方法で解決したのでしょうか。
答え:学習率が小さくなり続けて学習が止まる問題です。勾配の2乗を足し続ける代わりに指数移動平均を使い、古い勾配の影響を少しずつ忘れるようにしました。
第5章 2つの流れの合流:Adam(2014)
勢いと歩幅の調整を組み合わせる
2014年、ディーデリク・キングマとジミー・バーは、Adam を発表しました。Adam は、第2章の「勢い」の流れと、第3章・第4章の「歩幅の調整」の流れを1つにまとめた手法です。名前は Adaptive Moment Estimation(適応的なモーメントの推定)に由来します。
Adam は、2つの指数移動平均を記録します。


各記号の意味は次のとおりです。
- m_t:勾配の移動平均。モーメンタムにあたり、進む向きの勢いを表す
- v_t:勾配の2乗の移動平均。RMSProp と同じで、歩幅の調整に使う
- β1、β2:それぞれの移動平均で、過去をどれだけ残すかを決める値。標準の設定は β1 = 0.9、β2 = 0.999
バイアス補正:最初の偏りを直す
Adam のもう1つの工夫が、第4章で残った「最初の値が偏る」問題への対策です。m と v は 0 から始まるため、最初のうちは本来より小さな値になります。そこで、回数 t に応じた値で割って、偏りを補正します。


数値で確認します。1回目の更新(t = 1)で、勾配が g = 2 だったとします。
- m = 0.1 × 2 = 0.2、v = 0.001 × 2² = 0.004
- 補正後は、m を 1 - 0.9 = 0.1 で割って 2、v を 1 - 0.999 = 0.001 で割って 4
- 更新の大きさは、η × 2 ÷ √4 = η × 1
補正後の値は、勾配そのもの(2)と勾配の2乗(4)に戻っています。そして、更新の大きさは学習率 η と同じになりました。勾配が 2 でも 200 でも、1回目の更新の大きさはほぼ η です。Adam では、学習率が「1回の更新で重みが動く大きさの目安」になるため、設定が分かりやすくなります。
補正をしない場合、0.2 ÷ √0.004 ≒ 3.16 となり、更新が約3倍に大きくなってしまいます。バイアス補正は、学習の最初に大きく動きすぎることを防いでいます。
標準のオプティマイザになる
Adam は、学習率 0.001、β1 = 0.9、β2 = 0.999 という標準の設定のままでも、多くの問題でうまく働きました。細かい調整をしなくても使えることから、ディープラーニングで最も広く使われるオプティマイザになりました。
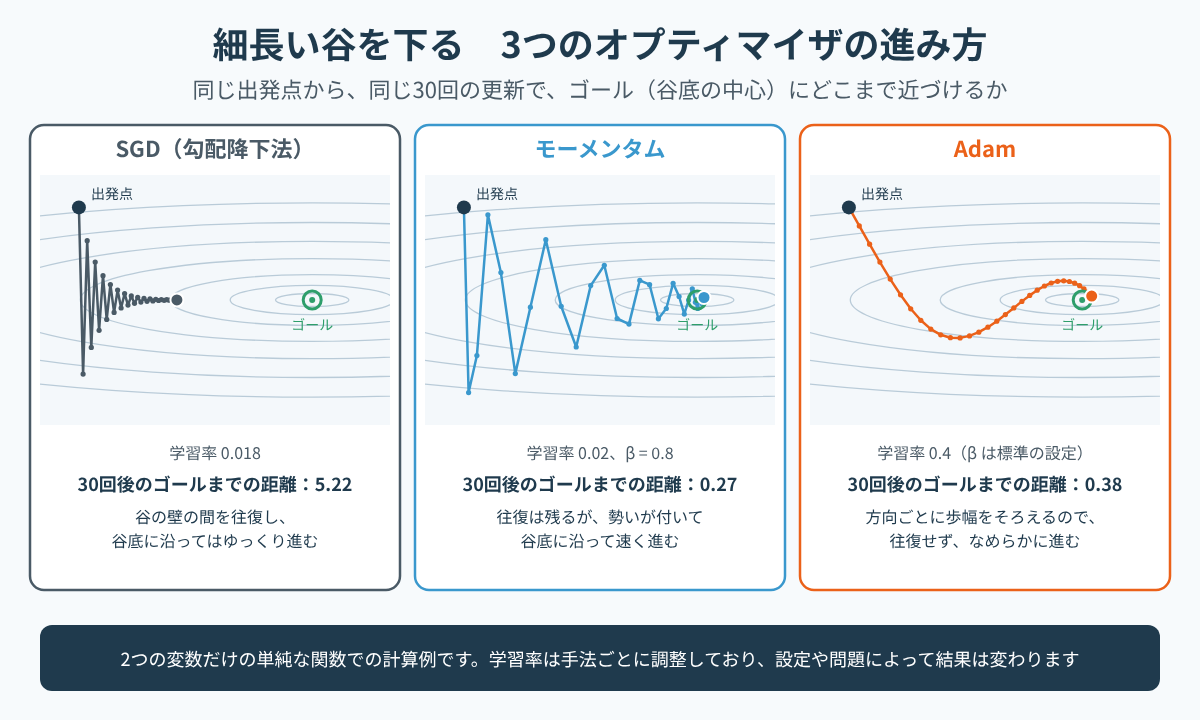
図は、細長い谷の形をした単純な関数で、3つの手法の進み方を計算した結果です。SGD は、30回の更新の後もゴールから 5.22 離れています。モーメンタムは 0.27、Adam は 0.38 まで近づきました。
この例では、モーメンタムと Adam の差はわずかで、モーメンタムのほうが少し近づいています。Adam は、どの問題でも一番速い手法というわけではありません。Adam の利点は、パラメータによって勾配の大きさが大きく違う問題でも、学習率を細かく調整せずに、安定して学習を進められることにあります。
ここで確認
問い:Adam は、それまでのどの手法の、どの考え方を組み合わせたものでしょうか。
答え:モーメンタムの「過去の勾配で勢いをつける」考え方と、RMSProp の「勾配の2乗の移動平均でパラメータごとに歩幅を調整する」考え方です。さらに、移動平均の最初の偏りを直すバイアス補正を加えています。
第6章 Adam の弱点と AdamW(2017〜2019)
SGD のほうが良い場合がある
広く使われるようになると、Adam の弱点も報告されるようになりました。2017年には、画像認識などの課題で、Adam で学習したモデルは、モーメンタム付きの SGD で学習したモデルよりも、未知のデータに対する精度(汎化性能)が低くなる場合があることが指摘されました。2018年には、Adam が最適な値に収束しない例があることが示され、その対策として AMSGrad が提案されています。
重み減衰が正しく効いていなかった
大きな前進になったのが、2017年にイリヤ・ロシチロフとフランク・フッターが発表した AdamW です。
過学習を防ぐ方法の1つに、重み減衰があります。更新のたびに重みを少しずつ 0 に近づけ、重みが大きくなりすぎるのを防ぐ方法です。それまでの実装では、重み減衰を「損失に重みの2乗を足す」形(L2 正則化)で行っていました。SGD では、この2つは同じ結果になります。
ところが、Adam では同じになりません。重みを小さくするための項が勾配に混ざると、その項も勾配の2乗の移動平均で割られてしまいます。その結果、勾配の大きいパラメータほど、重み減衰が弱く効くことになります。意図した強さで重みを減らせていなかったのです。
AdamW は、重み減衰を勾配に混ぜず、Adam の更新とは別に行います。

λ(ラムダ)は、重み減衰の強さです。数値で確認すると、w = 1、η = 0.001、λ = 0.01 のとき、重み減衰による変化は 0.001 × 0.01 × 1 = 0.00001 です。勾配の大きさに関係なく、重みそのものに比例した量だけ、毎回小さくなります。
AdamW は、Transformer の学習で広く使われるようになり、現在の大規模言語モデルの学習でも標準的な選択肢になっています。
学習の最初が不安定
Adam には、学習の最初に不安定になりやすいという性質もありました。最初の数回は、勾配の2乗の移動平均がごく少ないデータから計算されるため、歩幅の調整が当てになりません。2019年の RAdam は、この問題を分析し、最初のうちは歩幅の調整を控えめにする方法を示しました。実務では、次の章で紹介するウォームアップが広く使われています。
ここで確認
問い:AdamW は、Adam のどのような問題を解決したのでしょうか。
答え:重み減衰を L2 正則化として勾配に混ぜると、パラメータごとの歩幅の調整の影響を受けて、意図した強さで効かなくなる問題です。AdamW は、重み減衰を Adam の更新から切り離して別に行うことで解決しました。
第7章 大規模な学習を支える道具(2016〜2020)
学習率の予定表
オプティマイザと並んで重要なのが、学習率を時間とともにどう変えるかという予定表(スケジュール)です。
- ウォームアップ:学習の最初に、学習率を小さな値から徐々に上げていく方法。2017年の Transformer の論文で使われ、広く普及した。自動車を発進させるときに、いきなりアクセルを踏み込まないのと同じ考え方
- コサイン減衰:学習率を、コサイン曲線に沿ってなめらかに下げていく方法。2016年に提案された
コサイン減衰は、次の式で表されます。

T は全体の更新回数、η_max は最大の学習率です。t = 0 のとき、cos 0 = 1 なので、学習率は η_max です。t が T の半分のとき、cos(π/2) = 0 なので、学習率は η_max の半分です。t = T のとき、cos π = -1 なので、学習率は 0 になります。最初は大きく進み、終わりに近づくほど細かく調整する形です。
現在の大規模な学習では、「ウォームアップで上げて、コサイン減衰で下げる」組み合わせがよく使われます。
大きなバッチで学習する
学習を速くするために、多数の GPU を使い、1回の更新に使うデータの数(バッチサイズ)を大きくする方法が広まりました。しかし、バッチサイズを大きくすると、学習が不安定になりやすくなります。層によって、重みの大きさと勾配の大きさの比率が大きく違うためです。
2017年の LARS は、層ごとに学習率を調整することで、大きなバッチでも安定して学習できるようにしました。2019年の LAMB は、同じ考え方を Adam に取り入れたものです。
平らな谷を探す、メモリを節約する
同じ時期には、別の観点からの工夫も生まれています。
- SAM(2020年):損失が小さいだけでなく、周りも含めて損失が小さい「平らな谷」を探す方法。平らな谷にある重みは、未知のデータに対しても精度が落ちにくいと考えられている
- Adafactor(2018年):Adam は、パラメータごとに m と v の2つの値を記録するため、パラメータ数の2倍のメモリを追加で使う。Adafactor は、v の記録を行と列の統計に分けて持つことで、メモリを節約する
ここで確認
問い:ウォームアップは、何のために行うのでしょうか。
答え:学習の最初は、勾配の統計が安定しておらず、大きな学習率で更新すると学習が不安定になるためです。学習率を小さな値から徐々に上げることで、最初の不安定さを避けます。
第8章 次の世代:調整を減らす、行列の形を生かす(2023〜)
設定を減らす工夫
Adam と AdamW の登場から約10年、多くの新しい手法が提案されましたが、標準の座は長く変わりませんでした。2023年以降、いくつかの方向で新しい動きが出ています。
1つ目は、人が調整する設定を減らす方向です。
- Lion(2023年):Google の研究者が、プログラムによる探索で発見した手法。更新の向きの符号(プラスかマイナスか)だけを使うため計算が単純で、記録する値も Adam より少ない
- 学習率を自動で決める手法(2023年):D-Adaptation や Prodigy は、学習率を人が指定しなくても、学習の途中で適切な大きさを推定する
- Schedule-Free(2024年):第7章の学習率の予定表を使わずに学習する手法。あらかじめ全体の更新回数を決めなくてもよくなる
公平に比べる場ができた
オプティマイザの研究には、「新しい手法の論文は、自分の手法に有利な条件で比較しがち」という長年の課題がありました。そこで、業界団体の MLCommons は、同じハードウェアと複数の課題で、学習の速さを公平に比べるベンチマーク AlgoPerf を作りました。
2024年に結果が発表された最初の競技会では、設定の調整が認められる部門で Distributed Shampoo が、調整なしで動かす部門で Schedule-Free AdamW が、それぞれ1位になりました。
行列の形を生かす
2つ目は、重みを行列として扱う方向です。Adam は、パラメータを1つずつばらばらに扱い、それぞれの歩幅を調整します。しかし、ニューラルネットワークの層の重みは、もともと行列の形をしています。行と列の関係を生かせば、より良い向きに進めるはずです。
この考え方の源流は、勾配だけでなく、損失の曲がり具合(2階微分)も使うニュートン法にあります。曲がり具合まで使うと、少ない回数で谷底に着けますが、パラメータ数の2乗の大きさの行列が必要になり、そのままではディープラーニングには使えません。そこで、層ごとに近似して計算量を抑える K-FAC(2015年)や Shampoo(2018年)が提案されました。AlgoPerf で1位になったのは、この Shampoo を大規模に動かせるようにした実装です。2024年には、Shampoo の考え方と Adam を組み合わせた SOAP も発表されています。
Muon
2024年、ケラー・ジョーダンらが発表した Muon は、行列の形を生かす手法の中でも、特に単純な仕組みで注目を集めました。
Muon は、モーメンタムで勢いを付けた更新の行列に、直交化という操作を行います。特異値分解の記事で紹介した A = UΣV^T を思い出してください。Σ は、各方向にどれだけ伸ばすかを表す特異値を並べた行列でした。Muon は、更新の行列の特異値をすべて 1 にそろえます。つまり、「回す」部分の U と V^T だけを残し、「伸ばす」部分を取り除きます。
勾配の行列は、少数の方向だけが極端に大きくなりがちです。特異値をそろえることで、目立たない方向にも同じ大きさで更新が行われます。Adam が「パラメータごとに歩幅をそろえる」手法だとすれば、Muon は「行列の方向ごとに歩幅をそろえる」手法と言えます。特異値分解を毎回正確に計算すると時間がかかるため、実際には、行列の掛け算を数回繰り返す近似の計算(ニュートン・シュルツ反復)を使います。
Muon は、層の重みのような行列の形をしたパラメータに使い、それ以外のパラメータには AdamW を使うのが一般的です。2025年には、中国の Moonshot AI が、Muon を改良した手法で、1兆パラメータ規模の言語モデル Kimi K2 を学習させたことを報告しました。2026年には、大規模な言語モデルの学習で、Muon や SOAP が AdamW を上回ったとする比較の報告も出ています。
残された問題
新しい手法にも課題があります。Muon や SOAP は、1回の更新にかかる計算が AdamW より大きく、分散した計算機で効率よく動かす工夫が必要です。また、どの手法が優れているかは、モデルの種類、規模、バッチサイズなどの条件によって変わります。2026年の時点の調査でも、AdamW に代わる唯一の手法が決まったわけではないと整理されています。
ここで確認
問い:Adam と Muon は、どちらも「歩幅をそろえる」手法と考えられます。そろえる対象は、それぞれ何でしょうか。
答え:Adam は、パラメータ1つ1つについて歩幅をそろえます。Muon は、重みの行列を特異値分解したときの方向ごとに、更新の大きさ(特異値)をそろえます。
終章 物語を貫くパターン
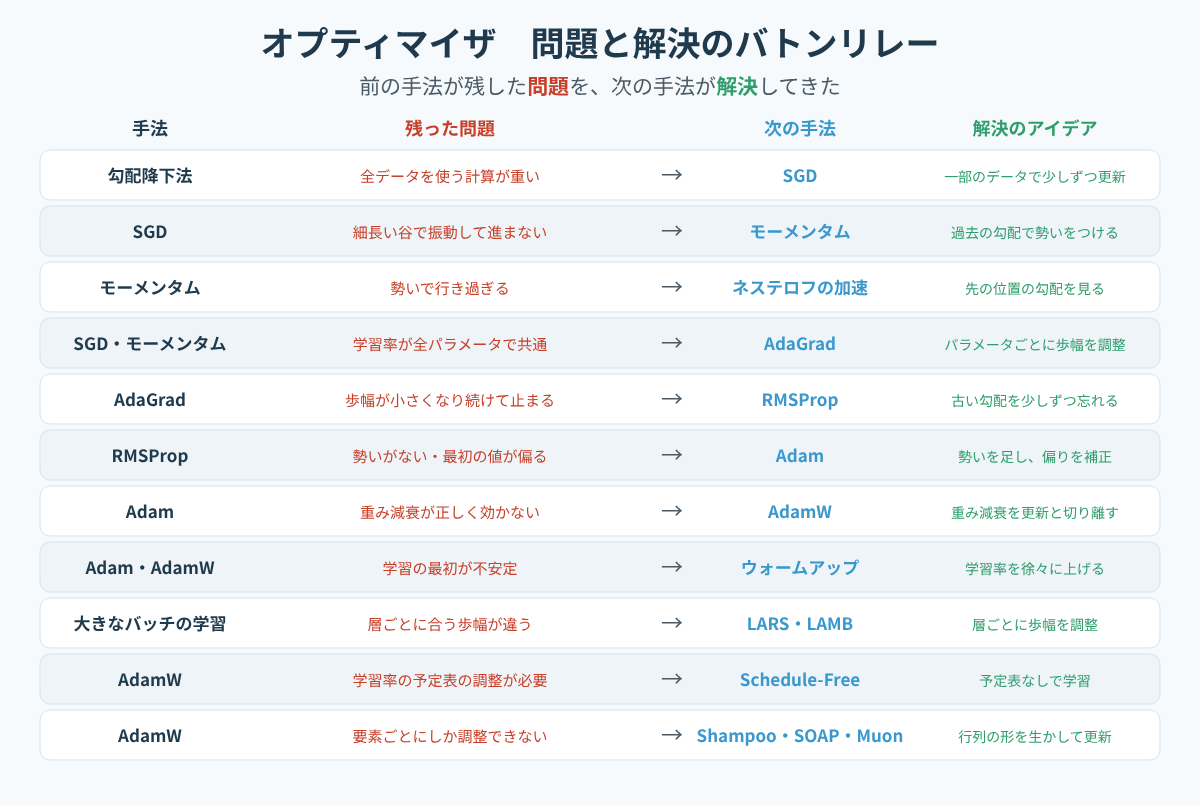
170年以上にわたるオプティマイザの歴史を振り返ると、いくつかのパターンが見えてきます。
3つの流れ
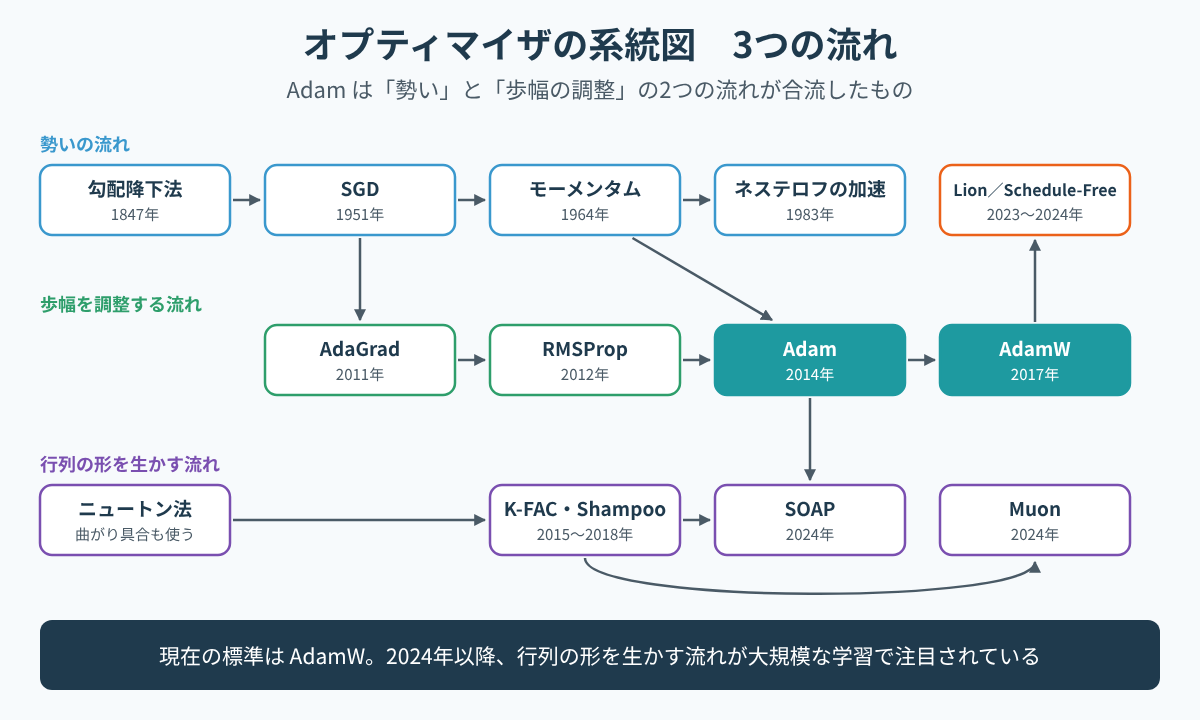
1つ目のパターンは、手法が3つの流れに整理できることです。
- 勢いの流れ:勾配降下法、SGD、モーメンタム、ネステロフの加速
- 歩幅を調整する流れ:AdaGrad、RMSProp
- 行列の形を生かす流れ:ニュートン法、K-FAC、Shampoo、SOAP、Muon
Adam は、最初の2つの流れが合流したものです。新しい手法に出会ったときは、「どの流れに属するのか」「どの流れを組み合わせたのか」を考えると、位置付けが分かりやすくなります。
式の1か所を変えて問題を解決してきた
2つ目のパターンは、新しい手法が、前の手法の式の1か所だけを変えていることです。
- SGD に、速度の項を足すとモーメンタム
- SGD の学習率を、勾配の2乗の合計の平方根で割ると AdaGrad
- AdaGrad の合計を、移動平均に変えると RMSProp
- RMSProp に、勢いとバイアス補正を足すと Adam
- Adam の重み減衰を、更新から切り離すと AdamW
研修では、式を1つずつ別々に覚えさせるのではなく、「前の式のどこが変わったか」を受講者に見つけてもらうと、理解が深まります。
人が調整する部分を減らしてきた
3つ目のパターンは、人が調整する部分が、少しずつ減ってきたことです。パラメータごとの歩幅は AdaGrad 以降に自動になり、標準の設定で動く Adam が普及し、学習率そのものや予定表を自動にする手法も登場しました。一方で、すべての問題で最も優れた手法は見つかっていません。問題に合わせて手法を選び、試して確かめる姿勢は、現在も必要です。
研修で聞かれたときの目安
受講者から「どれを使えばよいですか」と聞かれたときの、一般的な目安を示します。
- 迷ったら AdamW から始める。Transformer を使うモデルでは標準的な選択肢になっている
- 画像認識の CNN では、モーメンタム付きの SGD も有力な選択肢になる
- 学習率は、最も結果に影響する設定なので、複数の値を試す
- 大きなモデルでは、ウォームアップとコサイン減衰を組み合わせる
- 新しい手法を試すときは、公式の実装と推奨の設定を確認し、AdamW と同じ条件で比べる
確認問題
オプティマイザについて、正しい説明を1つ選んでください。
- Adam は、勢いの仕組みと、パラメータごとの歩幅の調整を組み合わせている
- AdaGrad は、学習が進むほど、パラメータごとの学習率が大きくなっていく
- モーメンタムは、過去の勾配を使わず、現在の勾配だけで更新を決めている
- AdamW は、Adam から重み減衰を完全に取り除いて、計算を速くしたものである
解答と解説
正解は 1 です。
- 1 は正しい説明です。Adam は、勾配の移動平均(勢い)と、勾配の2乗の移動平均(歩幅の調整)の両方を使います
- 2 は誤りです。AdaGrad は、勾配の2乗を足し続けるため、学習が進むほど学習率が小さくなっていきます
- 3 は誤りです。モーメンタムは、過去の勾配を積み重ねた速度を使って更新します
- 4 は誤りです。AdamW は、重み減衰を取り除いたのではなく、Adam の更新から切り離して、意図した強さで効くようにしたものです
研修で使うときの進め方
講師向けに、この物語を研修で使う進め方の一例を示します。
- 霧の中で山を下るたとえで、勾配、学習率、オプティマイザの役割を確認する
- 年表の図を示し、8つの章の全体像を先に見せる
- 勾配降下法の数値例(1 → 0.8 → 0.64)と、学習率が大きすぎる例(1 → -1.2 → 1.44)を、受講者に手で計算してもらう
- モーメンタムの速度(1 → 1.9 → 2.71)と、AdaGrad の歩幅(0.1 → 0.071 → 0.058)を計算し、「増えるもの」と「減るもの」を対比する
- Adam の1回目の更新を計算し、バイアス補正によって更新の大きさが学習率と同じになることを確かめる
- 細長い谷を下る図で、3つの手法の進み方の違いを確認する
- 系統図と、問題と解決のバトンリレーの図で、全体のつながりを振り返る
- グループワークとして、「SGD の式から出発して、1か所ずつ変えながら AdamW の式までたどる」作業をしてもらう
Python の演習と組み合わせる場合は、同じ小さなネットワークを SGD、モーメンタム付き SGD、Adam、AdamW で学習させ、損失の下がり方をグラフで比べる実験がおすすめです。学習率を10倍、10分の1に変えたときの違いも、あわせて確認させてください。
まとめ
- オプティマイザは、勾配を使って重みをどれだけ動かすかを決める係で、その出発点は1847年の勾配降下法にある
- SGD は一部のデータで少しずつ更新して計算を軽くし、モーメンタムは過去の勾配で勢いを付けて振動を抑えた
- AdaGrad はパラメータごとに歩幅を調整し、RMSProp は古い勾配を忘れることで歩幅が減り続ける問題を解決した
- Adam は勢いと歩幅の調整を組み合わせ、バイアス補正を加えて、最も広く使われる手法になった
- AdamW は重み減衰を更新から切り離し、ウォームアップやコサイン減衰とともに、大規模な学習の標準的な構成になった
- 現在は、学習率や予定表の調整を減らす手法と、Shampoo、SOAP、Muon のように行列の形を生かす手法の研究が進んでいる
次の学習ステップとしては、表計算ソフトや Python で、2つの変数だけの関数に対して、SGD、モーメンタム、Adam の更新を数回分、自分の手で計算してみる流れをおすすめします。式の中のそれぞれの項が何をしているかを、数値の動きとして確かめられます。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 山崎講師2026年11月15日機械学習の歴史を物語で学ぶ|最小二乗法からパーセプトロン、決定木、SVM、ランダムフォレスト、勾配ブースティング、表形式基盤モデルまで
 山崎講師2026年11月15日オプティマイザの歴史を物語で学ぶ|勾配降下法からモーメンタム、AdaGrad、RMSProp、Adam、AdamW、Muonまで
 山崎講師2026年11月15日ディープラーニングの歴史を物語で学ぶ|パーセプトロンから誤差逆伝播法、2度の冬、AlexNet、Transformer、基盤モデルまで
 山崎講師2026年11月15日コンピュータビジョンの歴史を物語で学ぶ|猫の脳の実験からAlexNet、ResNet、YOLO、ViT、CLIP、SAM、ロボットの目まで