モメンタムの仕組みと更新式の覚え方:物理の慣性を応用した勾配降下法の基礎
 山崎講師
こんにちは。ゆうせいです。
機械学習や深層学習のモデルを訓練する際、損失関数を最小化するための最適化手法として勾配降下法が広く用いられています。基本的な勾配降下法では、谷底に向かう途中で振動が生じたり、平坦な領域で学習が停滞したりする課題があります。こうした課題を緩和するために提案された手法がモメンタム(Momentum)です。
本記事では、物理の慣性という概念を基にしたモメンタムの仕組みと、その更新式の構成要素について解説します。
モメンタムとは何か
モメンタムは、通常の勾配降下法に過去の移動量を考慮する仕組みを加えた最適化手法です。
物理の慣性による比喩
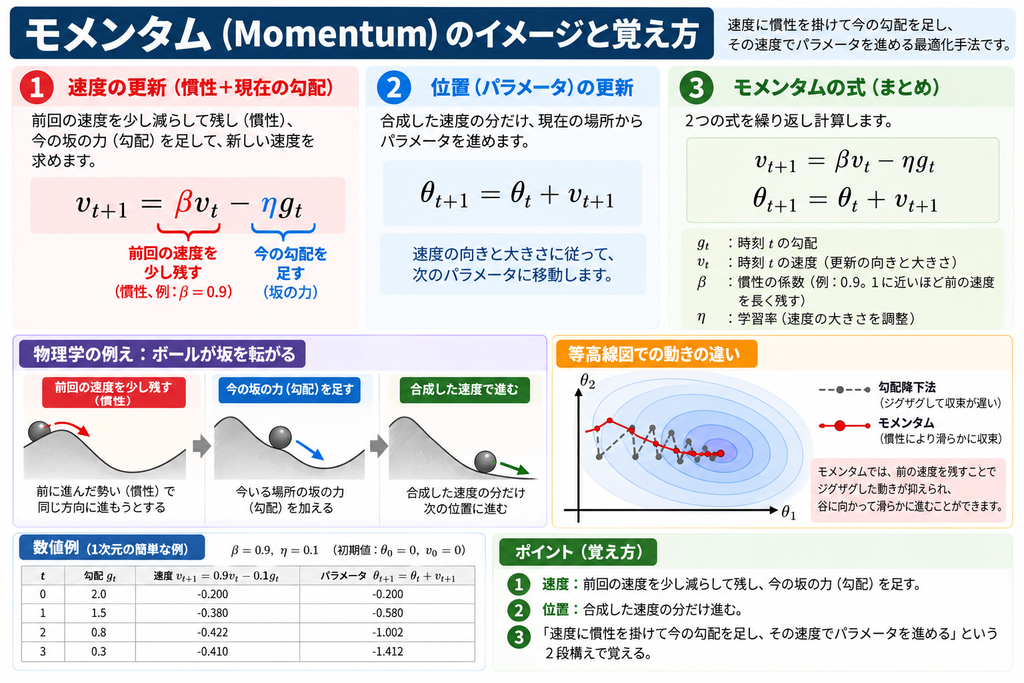
モメンタムの挙動は、すり鉢状の斜面を転がる球に例えることができます。
通常の勾配降下法では、現在の地点の傾きのみを見て一歩ずつ進むため、傾斜が急な方向には大きく動き、緩やかな方向には少ししか進みません。斜面の谷底に向かって進む際、左右の壁の間を行き来するようなジグザグの動きが発生しやすくなります。
一方、モメンタムを適用した更新では、球が斜面を勢いよく転がり落ちるときのように、過去の進行方向への勢い(慣性)が維持されます。左右の振動は打ち消し合い、一貫して下に向かう勢いが増すため、効率的に谷底へ進むことができます。
モメンタムの更新式
モメンタムにおけるパラメータの更新は、速度を表す変数を用いて2段階で計算されます。
更新式の定義
時刻tにおける損失関数の勾配を 


速度の更新式:

パラメータの更新式:

※文献によっては勾配の項にマイナスを含めて 

更新式を構成する要素
- 速度変数 v:過去のステップから引き継いだ移動方向と大きさを保持する変数です。
- モメンタム係数 γ:過去の速度をどれだけ維持するかを決定するハイパーパラメータです。通常は0.9前後の値が設定されます。値が0の場合は通常の勾配降下法と一致します。
- 勾配の反映:現在の地点における傾きに学習率を乗じた値が、速度ベクトルに加算されます。
モメンタムのメリットとデメリット
モメンタムの導入に伴う利点と注意点は以下の通りです。
メリット
- 振動の抑制:急峻な谷底に向かう際、互い違いに発生する勾配の成分が相殺され、進行方向への前進が滑らかになります。
- 平坦な領域の走破:勾配が極めて小さいプラトー(平坦面)に差し掛かっても、過去の速度が維持されているため、停滞せずに進み続けることができます。
- 局所解の脱出:運動エネルギーを持つため、浅い局所的最適解(ローカルミニマ)を飛び越えて、より深い最適解へ到達できる確率が高まります。
デメリット
- ハイパーパラメータの増加:学習率に加えてモメンタム係数も適切に調整する必要があります。
- 最小値の通過(オーバーシュート):勢いがつきすぎた場合、本来停止すべき大域的最適解を通り過ぎてしまい、収束までに余分なステップを要することがあります。
まとめ
モメンタムは、現在の勾配のみに頼る標準的な勾配降下法に対し、過去の速度履歴を組み合わせることで最適化の安定性と収束速度を高める手法です。
理解を深めるための学習ステップは以下の通りです。
- 2変数の二次関数など単純な関数を用意し、勾配降下法とモメンタムのパラメータ更新軌道を比較して確認する。
- モメンタムの弱点であるオーバーシュートを抑制するために改良された、Nesterovの加速勾配法(NAG)の数式を確認する。
- 学習率を次元ごとに自動調整するAdaGradやRMSprop、さらにモメンタムと組み合わせたAdamへと理解を拡張する。
投稿者プロフィール