AdaGradの仕組みと更新式の覚え方:勾配の二乗和を用いた学習率の自動調整
 山崎講師
こんにちは。ゆうせいです。
人工知能や深層学習のモデルを訓練する際、計算結果の誤差を小さくするためにパラメータの値を少しずつ書き換えていく最適化手法が使われます。その代表的なアルゴリズムの1つがAdaGrad(アダグレード)です。
正式名称をAdaptive Gradient Algorithmと呼び、名前が表す通り、データの傾き(勾配)に合わせてパラメータごとに学習の歩幅を自動調整する仕組みを持っています。
数式にはギリシャ文字や平方根が含まれるため、暗記しようとすると難しく思える場合があります。しかし、式の構造を部品ごとに分解し、どのような計算を行っているかを順に追うことで、数式の形を自然に整理できます。
本記事では、前提知識を持たない方に向けて、AdaGradの基本概念から更新式の仕組み、覚え方、利点と留意点、そして理解を深める学習の手順を解説します。
AdaGradの基本概念
AdaGradは、モデルが持つ膨大なパラメータを更新する際、過去の勾配の大きさを記録しておき、よく動いたパラメータは歩幅を狭く、あまり動いていないパラメータは歩幅を広く維持する手法です。
従来の基本的な勾配降下法では、すべてのパラメータに対して一定の学習率を掛けて進めていました。AdaGradはパラメータごとに異なる倍率を掛けて更新幅を個別に変更します。
雪道を踏み固める比喩
高校の通学路にある積雪の深い道路を歩く場面を想定します。目的地に向かって雪道を進む状況を考えます。
何度も人が通って雪が踏み固められた道は、すでに十分に足場が定まっているため、勢いをつけて進む必要はありません。少しずつ慎重に足を進めることで、転倒を防ぎます。
反対に、誰も通っていない新雪の深い道は、まだ開拓が進んでいません。しっかり足を大きく踏み出して進路を切り開く必要があります。
AdaGradは、過去に大きな傾きが繰り返し観測されたパラメータの道筋には慎重な歩幅を割り当て、傾きが小さく更新が滞っていたパラメータの道筋には大きな歩幅を割り当てる調整を自動で行う仕組みです。
構成する記号の整理
数式を読み解くために使用する記号の意味を整理します。
- θ:更新対象となるモデルの重みパラメータ
- g:現在のステップにおける損失関数の傾き(勾配)
- G:過去から現在までに発生した勾配の二乗をすべて足し合わせた累積値
- η:あらかじめ人間が設定する基準の学習率
- ε:分母が0になる計算エラーを防ぐための極めて小さな定数(例:1e-8)
- t:現在の更新回数(ステップ数)
AdaGradの更新式と構造の分解
AdaGradのパラメータ更新は、2段階の計算手順で進行します。
第1段階で過去の勾配の大きさを蓄積し、第2段階でその蓄積量を用いてパラメータを更新します。
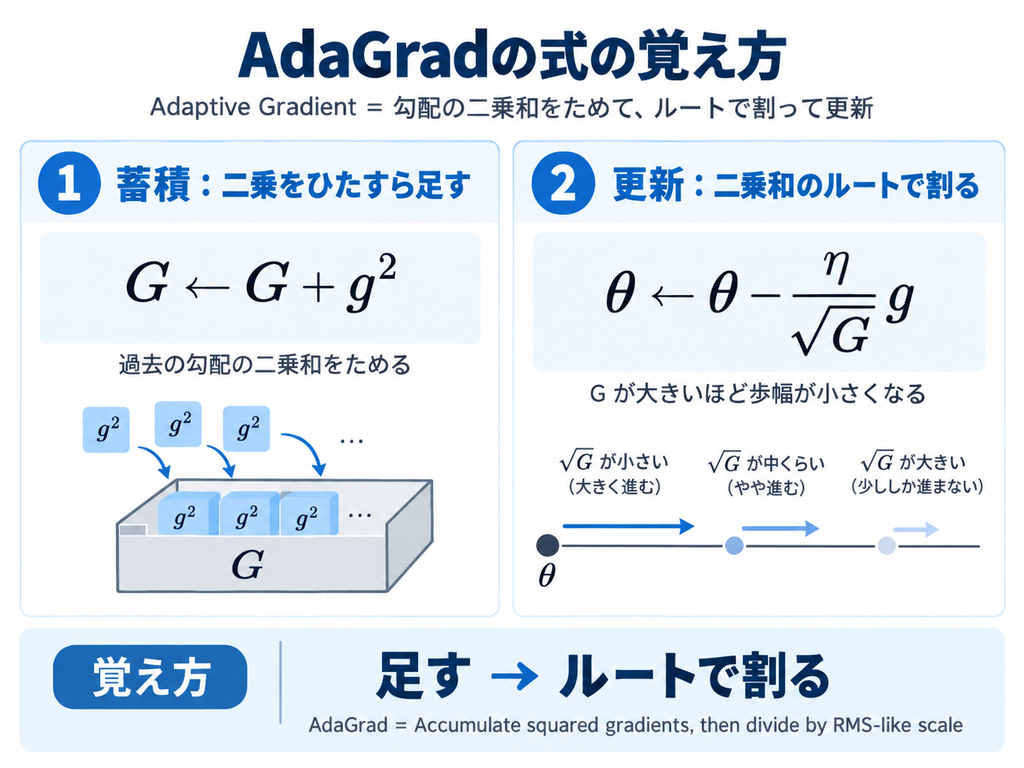
1. 勾配の二乗和を蓄積する式
最初の段階では、過去の累積値 G に、現在のステップで計算された勾配 g の二乗を加算します。

勾配の正負に関係なく移動の激しさを測るため、勾配を二乗してから足し合わせます。更新回数が重なるにつれて、G の値は常に増加していきます。
2. パラメータを更新する式
第2段階では、計算した累積値 G を用いて重みパラメータ θ を更新します。

この計算式は、基本の勾配降下法の学習率 η の部分を修正した形状をしています。
分母に G の平方根が配置されている点が特徴です。
過去に急勾配が続いて G の値が大きくなったパラメータは、分母が大きくなるため、実質的な学習率が小さくなります。
過去の勾配が小さく G の値があまり増えていないパラメータは、分母が小さいまま保たれるため、学習率があまり下がりません。
定数の ε は、最初のステップなどで G が 0 であった場合にゼロ除算となる現象を防ぐために添えられています。
式の覚え方
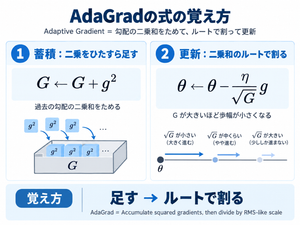
AdaGradの式を記憶する際は、次の2つの段階を順序立てて捉える整理法が役立ちます。
- 蓄積:二乗をひたすら足し算する(G = G + gの二乗)
- 更新:二乗和のルートで基準学習率を割る(η / ルートG)
名前のAdaptive Gradientが示す通り、「過去の勾配(Gradient)の二乗和を蓄積し、そのルートで割って適応的(Adaptive)に歩幅を落とす」という言葉の意味と式の配置を結びつけることで、分母に平方根が置かれる理由を迷わずに導き出せます。
AdaGradの特徴
AdaGradをモデルの学習に採用する際には、いくつかの利点と留意点が存在します。
利点
- パラメータごとの歩幅の自動最適化出現頻度が低く勾配がまれにしか発生しない特徴量に対しても、分母が小さな状態を保つため、学習の遅れが生じにくくなります。自然言語処理のような、単語の出現頻度に偏りがあるデータに対して適した挙動を示します。
- 手動調整の負担軽減学習の進行に伴って学習率が自然に小さくなっていくため、学習率を段階的に減衰させるスケジュール設定の調整を軽減できます。
留意点
- 長期的な学習における停滞二乗した正の数値を足し続けるため、G の値は単調に増加し続けます。学習のステップ数が多くなると分母が極端に巨大化し、実質的な学習率がほぼ0になって重みの更新が途中で停止してしまう現象が起こります。
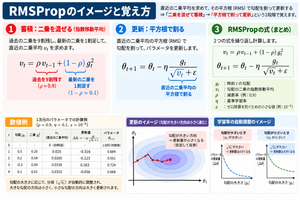
- 単調減少による柔軟性の低下一度歩幅が縮小してしまうと、その後に大きな歩幅が必要な局面が現れても、歩幅を再び広げることができません。この学習停止の課題を改善するために、過去の情報を割り引いて蓄積するRMSPropという手法が後に開発されました。
まとめ
AdaGradの公式は、パラメータごとの更新頻度に応じて歩幅を自律的に整えるための計算式です。
- 過去の勾配の二乗をすべて足し合わせて累積値を求める
- 累積値の平方根を分母に置き、基準となる学習率を割って歩幅を決める
- 頻繁に更新されるパラメータは慎重に進め、更新が少ないパラメータは積極的に進める
AdaGradに関する理解を確実なものにするためには、次の手順に沿って学習を進める方法を推奨します。
- 基本的な最急降下法(SGD)の更新式を確認し、学習率が全パラメータで一律である場合の課題を把握する。
- 勾配 g = 1.0 が3回連続で発生した場合と、g = 0.1 が3回連続で発生した場合を想定し、手計算で G の値と更新幅の減少度合いを計算して比較する。
- 学習の長期化に伴って分母が肥大化する問題を解消するために、過去の勾配を指数移動平均で減衰させる手法であるRMSPropの式を確認し、改良の要点を整理する。
- AdaGradの適応的学習率の考え方と、勾配の勢いを維持するモメンタムの考え方を組み合わせた発展アルゴリズムであるAdamの更新式へと学習範囲を広げる。
投稿者プロフィール