交差エントロピー誤差の公式の覚え方:正解分布と予測分布から理解する情報理論
 山崎講師
こんにちは。ゆうせいです。
機械学習の分類問題などで頻繁に利用される交差エントロピーは、数式の記号が多く、正解と予測のどちらを対数に入れるべきか迷いやすい概念です。確率の分布が持つ意味を整理して数式の構造を把握すると、無理なく記憶に定着させることができます。数学的な前提知識を持たない初心者の方に向けて、交差エントロピーの公式の導き方と覚え方を順を追って解説します。
交差エントロピーとは何か
交差エントロピーとは、正解となる確率の分布に対して、モデルが立てた予測の確率分布がどれくらい離れているかを測る尺度です。
英語の単語テストに例えた直感的理解
高校生が受ける英単語のテストを例に考えてみます。
先生が用意した正解の解答用紙を「正解分布 p」と呼びます。一方で、生徒が自分の勘や知識を頼りに書いた解答用紙を「予測分布 q」と呼びます。
生徒が正解を正確に言い当てていれば、先生の模範解答と生徒の答えは一致するため、生じる違和感や追加で学ぶべき分量は少なくなります。しかし、生徒の予測が正解から外れているほど、模範解答に照らし合わせたときのズレは大きくなり、先生側から見た確認の手間は増大します。
このように、実際の正解基準に基づいて、予測された情報の大きさを見積もる計算が交差エントロピーの役割です。
交差エントロピーの公式とその構造
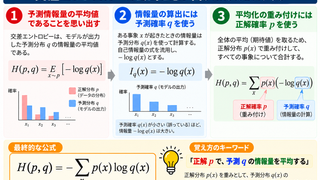
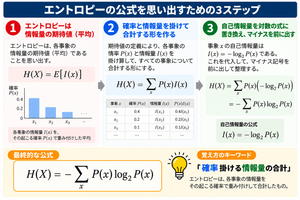
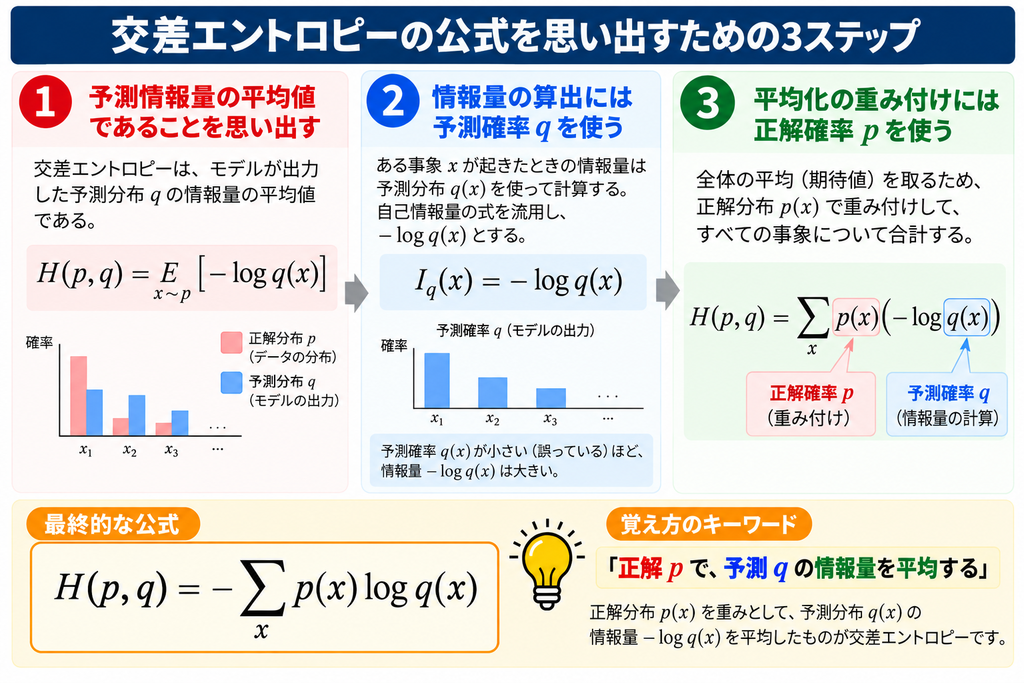
取り得る事象が n 種類存在し、事象 i における正解の確率を p(x_{i})、予測の確率を q(x_{i}) と表すとき、交差エントロピー H(p, q) は以下の式で定義されます。

この式を丸暗記しようとすると、p と q の位置関係を取り違えやすくなります。公式を構成する要素を2つの段階に分解して確認します。
1. 予測分布が持つ情報量
まず、予測側である q がその事象にどれほどの驚きを持っているかを表す情報量を計算します。事象が起きる確率の逆数に対数を取ったものが自己情報量です。

予測確率 q(x_{i}) が低い事象ほど、その事象に対して予測側が感じる情報量は大きくなります。
2. 正解分布による重み付け平均
算出した予測側の情報量に対して、現実にその事象がどの程度の割合で起きるかを表す正解の確率 p(x_{i}) を掛け合わせます。
高校数学の期待値(平均値)の計算と同じ仕組みです。それぞれの事象について以下の手順を実行します。
- 予測側が感じる情報量を計算します。
- 実際に起きる確率である正解確率を掛けます。
- すべての事象について足し合わせます。
言葉の通りに式を組み立てると、以下の形になります。

マイナスの符号を全体の前に出すことで、一般的に教科書へ記載されている標準的な交差エントロピーの公式が得られます。対数の内側に入るのは予測の確率 q であり、手前に掛ける重みは正解の確率 p です。
公式を思い出すための3ステップ
試験や実装時に公式を正確に再現する手順は以下の通りです。
- ステップ1:交差エントロピーは予測情報量の平均値であるという前提を想起します。
- ステップ2:情報量の算出には予測確率 q を使用するため、対数の中に q を配置します。
- ステップ3:平均化の重み付けには正解確率 p を使用するため、対数の外側に p を掛けてシグマでまとめます。
「正解 p で、予測 q の情報量を平均する」という言葉を基準にしておくと、記号の配置を誤る事態を防ぐことができます。
交差エントロピーを評価関数として使う利点と注意点
交差エントロピーを機械学習の損失関数として利用する際の性質を、客観的な観点から整理します。
利点
- 予測確率が正解から大きく外れているときに値が急激に大きくなるため、勾配消失を起こしにくく、効率的なモデルの学習が可能です。
- 正解と予測が完全に一致したときに通常のエントロピーと等しくなり、数学的に明確な下限値が存在します。
注意点
- 予測確率 q に 0 が含まれると、対数の定義上、値が負の無限大へ発散するため、プログラム上では微小な数値を加えるなどの数値安定化処理が必要です。
- ラベルの誤りなど正解データそのものに不備が存在する場合、誤った分布を基準に学習が進行します。
まとめ
交差エントロピーの公式は、予測分布 q から得られる情報量を、正解分布 p の確率によって平均化した期待値の計算式です。「対数の中が予測 q、手前の重みが正解 p」という役割分担を把握することで、記号の配置を迷わずに導き出せます。
次の学習段階として、正解分布と予測分布の純粋な隔たりを定量化するカルバック・ライブラー情報量(KLダイバージェンス)の計算を確認し、交差エントロピーとの引き算の関係を理解していくと、情報理論と機械学習の接点をより体系的に深めることができます。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。