混合ガウスモデルの名前の由来と複数の釣鐘型分布を足し合わせる仕組みを初心者向けに解説
 山崎講師
混合ガウスモデルの名前の由来と複数の釣鐘型分布を足し合わせる仕組みを初心者向けに解説
こんにちは。ゆうせいです。
統計学や機械学習の領域では、集めたデータを分析して背後にある規則性を見つけ出す手法が研究されています。身長の測定値やテストの点数のように、自然界や社会で観測される多くのデータは、中央が高く左右対称になだらかに広がる特定の分布に従う傾向があります。しかし、実際のデータには複数の集まりが混ざり合っているケースも少なくありません。そうした複雑なデータのばらつきを捉える代表的な統計手法が混合ガウスモデルです。今回は、混合ガウスモデルという名称の由来や計算の仕組み、長所と短所について解説します。
混合ガウスモデルという名称の由来
混合ガウスモデルは、英語の Gaussian Mixture Model を日本語へ翻訳した用語です。頭文字をとって GMM と省略して呼ばれることもあります。
構成する単語を分解して確認すると、仕組みと目的が分かります。
ガウス分布(正規分布)の意味
ガウスという名称は、この分布の数学的な性質を詳細に研究した18〜19世紀のドイツの数学者カール・フリードリヒ・ガウスに由来しています。ガウス分布は一般に正規分布とも呼ばれ、グラフに描くと左右対称の釣鐘型(ベルの形)を描く確率分布です。平均値付近にデータが最も多く集まり、平均から離れるにつれて出現頻度が徐々に減っていく性質を持っています。
混合(Mixture)の意味
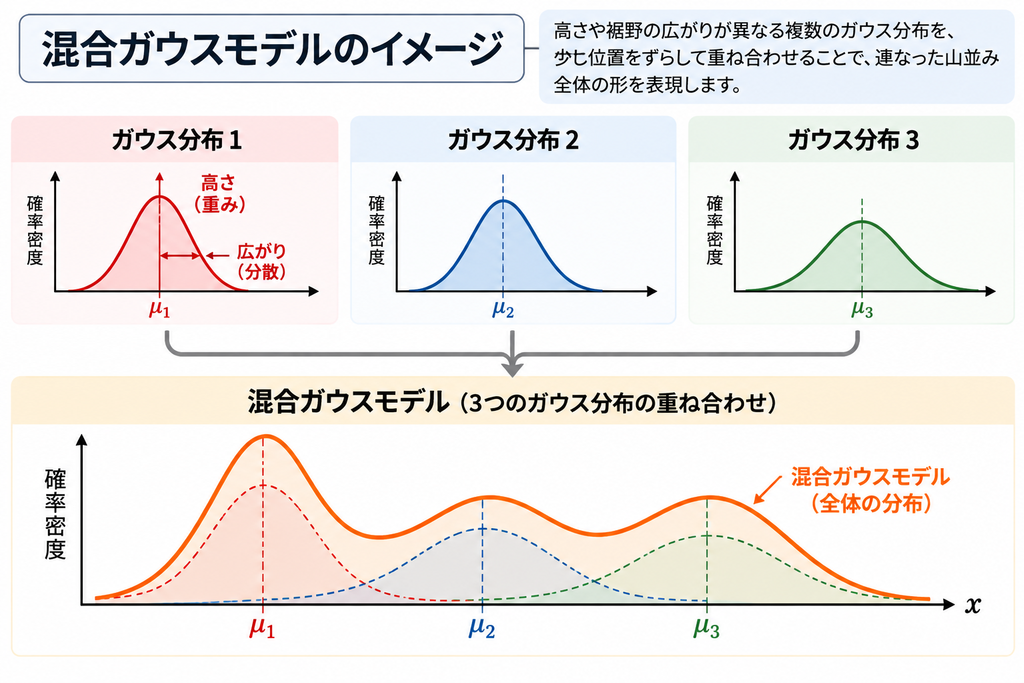
混合という単語は、複数の異なる要素を混ぜ合わせる状態を表します。1つのガウス分布だけでは表現しきれない複雑な形状のデータを表すために、複数のガウス分布に重みをつけて重ね合わせる(合成する)操作を意味します。
複数のガウス分布を足し合わせて1つの分布として表現する数理モデルであることから、混合ガウスモデルと命名されました。
山並みの模型の比喩で理解する分布の合成
混合ガウスモデルの考え方を理解するために、砂場で山を作る作業を例に考えてみます。
通常のガウス分布は、きれいな円錐状のきれいな山を1つだけ盛った状態に相当します。頂上が1箇所にあり、裾野が四方へ均等に広がっています。例えば、成年男性だけの身長データを集めた場合、平均値を中心とした1つの山として綺麗に表現できます。
しかし、男女両方の身長データをまとめて集めた場合、男性の平均値付近と女性の平均値付近にそれぞれ頂上が現れ、2つのコブを持つ山並みが形成されます。このような2つの頂上を持つ山を、1つの山用の型枠だけで無理に再現しようとすると、裾野が不自然に広がって実態と合わなくなってしまいます。
混合ガウスモデルは、高さや裾野の広がりが異なる複数の山を別々に用意し、少し位置をずらして重ね合わせることで、連なった山並み全体の立体的な起伏を表現する手法に相当します。
混合ガウスモデルの数式表現
混合ガウスモデルでは、データ x が観測される確率密度を、K 個のガウス分布の重み付き線形結合として計算します。
各ガウス分布 k には、全体のどれくらいの割合を占めるかを表す混合係数 pi_{k} が割り当てられます。すべての混合係数の和は 1 になります。
データ x の確率密度関数を表す式

数式内の N(x | mu_{k}, Sigma_{k}) は、平均ベクトル mu_{k} と共分散行列 Sigma_{k} を持つ k 番目の多次元ガウス分布を表します。d 次元の空間における多次元ガウス分布の数式は次のように定義されます。
多次元ガウス分布の確率密度関数

各成分の平均、分散、混合係数のパラメータ推定には、観測されない潜在変数(どのデータがどの山から発生したか)を補いながら反復計算を行う EMアルゴリズム(期待値最大化法)が広く用いられます。
混合ガウスモデルのメリット
混合ガウスモデルを採用することによって確認されている具体的な長所には、以下の項目が挙げられます。
- 柔軟な分布形状の表現:1つの分布では扱えない多峰性(複数の頂点を持つ形状)や歪みのある非対称なデータのばらつきを、滑らかな確率密度として精密に再現できます。
- 確率的な所属度合いの算出:データをグループ分けするクラスタリングにおいて、特定のグループに100%所属させるのではなく、「グループAに70%、グループBに30%の確率で属する」といった曖昧さを含めた評価(ソフトクラスタリング)が可能です。
- クラスタの形状の自由度:グループごとの広がり方を共分散行列で個別に設定できるため、球状だけでなく楕円形に引き伸ばされた方向性のある集団も適切に捉えられます。
混合ガウスモデルのデメリット
一方で、混合ガウスモデルを運用する際には以下のような短所も存在します。
- 初期値依存性と局所最適解:EMアルゴリズムを用いてパラメータを最適化する際、パラメータの初期値の選び方によって計算結果が変動し、大域的な最適値ではなく局所解に収束する場合があります。
- コンポーネント数の事前決定:合成するガウス分布の数 K をあらかじめ人間が指定する必要があり、適切な K の値を決定するために情報量規準(AICやBIC)を用いた試行錯誤の計算が必要になります。
- 特異点問題と過学習:1つのガウス分布の分散パラメータが極端に小さくなり、1点のみに集約されて確率密度が無限大へ発散してしまう現象(特異点)が発生することがあります。
まとめと次の学習ステップ
混合ガウスモデルは、数学者ガウスに由来する釣鐘型のガウス分布を複数混ぜ合わせて(混合して)複雑なデータの確率分布を表現する構成に由来して命名されました。複数のグループが混在するデータに対して、確率的な視点を取り入れた柔軟なモデル化を可能にしています。
混合ガウスモデルの理解を深めるための学習ステップは以下の通りです。
- 1変数の正規分布の平均と分散の意味を復習し、グラフの広がり方がどのように決まるかを確認する。
- データを排他的にグループ分けする代表的な手法である k-means 法のアルゴリズムを学ぶ。
- k-means 法の考え方を確率的に拡張した EMアルゴリズムの Eステップ(負担率の計算)と Mステップ(パラメータの更新)の反復計算手順を追跡する。
- 赤池情報量規準(AIC)やベイズ情報量規準(BIC)を用いて、適切な混合数 K を統計的に選択する評価手法へと学習を進める。
基礎となるガウス分布の性質と混合の手順を段階的に確認していくことで、パターン認識や音声認識、画像処理における領域分割など、多様な分野で使われる確率モデルの基礎を体系的に把握できるようになります。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。