統計検定2級 対策テキスト 第4回|データ収集法(標本調査・無作為抽出・観察研究と実験研究・フィッシャーの3原則)
 山崎講師
こんにちは。ゆうせいです。
統計検定2級 対策テキスト(全10回)の第4回です。今回は、出題範囲表の「推測のためのデータ収集法」を学びます。計算はほとんどありませんが、用語の意味と使い分けを問う問題が出ます。どれほど高度な分析をしても、データの集め方が偏っていれば、結論は信頼できません。後半の推定と検定の前提になる大切な回です。
この回で学ぶこと
- 母集団と標本、標本誤差と非標本誤差
- 標本の抽出法(単純無作為、系統、層化、集落、多段)
- 観察研究と実験研究の違い、交絡
- 実験計画の基本(フィッシャーの3原則)
1. 母集団と標本
調べたい対象の全体を母集団、母集団から選んだ一部を標本と呼びます。標本を調べて、母集団の性質を推測するのが標本調査です。
- 母集団:日本の有権者の全員
- 標本:電話で回答を得た 2000人
- 標本の大きさ(サンプルサイズ):2000
標本調査の結果には、2種類の誤差が含まれます。
- 標本誤差:全員ではなく一部を調べたために生じる誤差。無作為に選べば、大きさを確率で評価できる。標本を大きくすると小さくなる
- 非標本誤差:それ以外の原因で生じる誤差。回答しない人がいる(無回答)、質問の仕方が答えを誘導する、嘘の回答、入力のミスなど。標本を大きくしても小さくならない
標本を選ぶもとになる名簿(抽出枠)が母集団と食い違っている場合にも、偏りが生じます。固定電話の番号だけを名簿にすると、固定電話を持たない人は最初から選ばれません。
ここで確認
問い:インターネットで回答を募集したアンケートに、10万人が回答しました。標本が大きいので、結果は日本全体の意見を正しく表していると言えるでしょうか。
答え:言えません。自分から回答した人だけの集まりで、無作為に選ばれていないからです。その話題に強い関心を持つ人に偏っている可能性があります。偏りは、標本を大きくしても小さくなりません。
2. 標本の抽出法
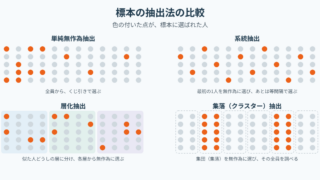
母集団の縮図になるように標本を選ぶ基本は、無作為抽出です。母集団のどの人も、同じ確率で選ばれるようにします。「適当に選ぶ」こととは違い、乱数やくじを使って、選ぶ人の意思が入らないようにします。
出題範囲表には、次の抽出法が挙がっています。
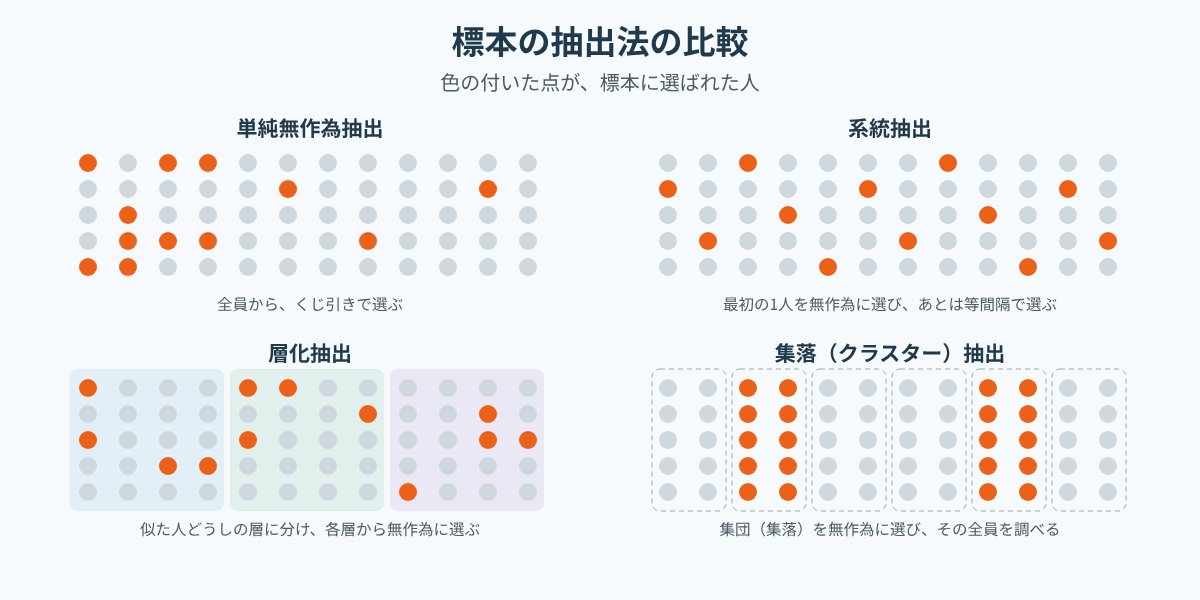
- 単純無作為抽出:母集団の全員に番号を付け、乱数で選ぶ。最も基本的な方法。全員の名簿が必要
- 系統抽出:最初の1人だけを無作為に選び、あとは等間隔で選ぶ。手間が少ない。名簿の並びに周期があると偏る
- 層化抽出:性別や年代など、性質の似た人どうしの層に分け、それぞれの層から無作為に選ぶ。層の中が似ているほど、精度が上がる
- 集落(クラスター)抽出:母集団を学校や地区などの集落に分け、集落を無作為に選んで、選んだ集落の全員を調べる。費用を抑えられるが、精度は下がりやすい
- 多段抽出:市区町村を選び、その中から世帯を選ぶ、というように、段階を分けて選ぶ。全国規模の調査でよく使う
数値で確かめます。
- 系統抽出:10000人の名簿から 200人を選ぶ場合、間隔は 10000 ÷ 200 = 50 です。1番から50番までの中から1人を無作為に選び、そこから50人おきに選びます
- 層化抽出(比例配分):男性 6000人、女性 4000人の母集団から 500人を選ぶ場合、母集団の構成比に合わせて、男性 300人、女性 200人を選びます
層化抽出と集落抽出は、混同しやすい組み合わせです。
- 層化抽出:すべての層から選ぶ。層の中は似た人どうし、層と層は違うほうがよい
- 集落抽出:一部の集落だけを選ぶ。集落の中はばらばらで、集落と集落は似ているほうがよい
ここで確認
問い:ある県の高校生の意識調査で、県内の高校から10校を無作為に選び、選んだ高校の2年生全員に回答してもらいました。この抽出法の名前を答えてください。
答え:集落(クラスター)抽出です。高校という集団を単位に選び、選んだ集団の全員を調べています。選んだ高校の中から、さらに一部の生徒を無作為に選ぶ場合は、二段抽出になります。
コラム 240万人の調査が外れ、5万人の調査が当たった話
1936年のアメリカ大統領選挙は、標本の選び方の大切さを示す有名な例です。
ある雑誌社は、約1000万人に調査票を送り、約240万人から回答を得ました。集計の結果は、共和党のランドン候補の勝利でした。一方、世論調査を始めたばかりのギャラップは、約5万人という、はるかに小さな標本で、民主党のルーズベルト候補の勝利を予測します。結果は、ルーズベルトの圧勝でした。
雑誌社の調査が外れた理由は、主に2つあると言われています。
- 名簿の偏り:調査票の送り先を、雑誌の購読者、電話の加入者、自動車の所有者の名簿から選んだ。当時、電話や自動車を持っていたのは裕福な層で、共和党の支持者が多かった
- 無回答の偏り:回答を返したのは約4分の1で、現職に不満を持つ人ほど、熱心に回答した
この出来事は、「標本は、大きさよりも選び方が大切である」という教訓として、今も語り継がれています。
問い:240万人の調査が外れた原因は、標本誤差と非標本誤差のどちらでしょうか。
答え:非標本誤差です。名簿の偏りと無回答の偏りが原因で、標本を大きくしても解消されません。
3. 観察研究と実験研究
データを集める研究は、大きく2つに分けられます。
- 観察研究:対象に手を加えず、ありのままの状態を観察する。例:喫煙者と非喫煙者の健康状態を追跡して比べる
- 実験研究:研究者が対象に処理を割り当て、結果を比べる。例:無作為に2つのグループに分け、一方に新薬を、もう一方に偽薬を与える
観察研究の弱点は、交絡です。コーヒーをよく飲む人に心臓の病気が多い、というデータがあったとします。コーヒーをよく飲む人は、喫煙者の割合も高いかもしれません。この場合、喫煙が、コーヒーと病気の両方に関係する第3の変数(交絡因子)になっており、コーヒーの影響と喫煙の影響を区別できません。第3回で学んだ見かけの相関と同じ問題です。
実験研究では、対象を無作為にグループに分けることで、喫煙の習慣、年齢、体質など、あらゆる要因が、グループの間で平均的に同じになります。そのため、結果に差が出れば、処理の効果だと判断できます。
実験でよく使う用語を整理します。
- 処理群:調べたい処理を受けるグループ
- 対照群:処理を受けない(または標準の処理を受ける)グループ。比較の基準になる
- 無作為割り付け:どちらのグループに入れるかを、乱数で決めること
- 偽薬(プラセボ):有効成分を含まない薬。「薬を飲んだ」という思い込みの効果を除くために使う
- 盲検化:どちらのグループかを、本人や評価する人に知らせないこと
実験は因果関係を調べる強力な方法ですが、倫理の面や費用の面で行えない場合もあります。喫煙の害を調べるために、人に喫煙を強制することはできません。その場合は観察研究を行い、交絡の影響を分析で調整します。
ここで確認
問い:新しい学習アプリの効果を調べるために、希望者にアプリを使ってもらい、使わなかった人と成績を比べました。この比較の問題点を挙げてください。
答え:アプリを使うかどうかを本人が選んでいるため、もともと学習意欲の高い人が処理群に集まっている可能性があります。成績の差が、アプリの効果なのか、意欲の差なのかを区別できません。無作為に割り付けることで、この問題を避けられます。
4. フィッシャーの3原則
信頼できる実験を計画するための基本として、イギリスの統計学者フィッシャーがまとめた3つの原則があります。
- 反復(繰り返し):同じ条件の実験を、複数回行う。1回だけでは、差が処理の効果なのか、偶然のばらつきなのかを区別できない。繰り返すことで、ばらつきの大きさを見積もれる
- 無作為化:処理を、実験の単位に無作為に割り当てる。研究者が気付いていない要因の影響が、特定の処理に偏るのを防ぐ
- 局所管理(ブロック化):条件の似た実験の単位をまとめてブロックを作り、ブロックの中で処理を比べる。ブロックの間の違いを、処理の比較から取り除ける
3種類の肥料 A、B、C の効果を、畑で比べる実験を考えます。
- 反復:それぞれの肥料を、1区画ではなく4区画ずつで試す
- 局所管理:畑は、場所によって日当たりや水はけが違う。条件の似た区画を3つずつまとめて、4つのブロックを作る
- 無作為化:それぞれのブロックの中で、3つの区画に A、B、C のどれを割り当てるかを、乱数で決める
ブロックごとに、すべての処理を1回ずつ無作為に割り当てる方法を、乱塊法(らんかいほう)と呼びます。実験のデータを分析する分散分析は、第10回で学びます。
ここで確認
問い:2種類の教え方の効果を比べる実験で、午前のクラスに方法Aを、午後のクラスに方法Bを割り当てました。フィッシャーの3原則のうち、どの原則が守られていないでしょうか。
答え:無作為化が守られていません。教え方の違いと、時間帯の違いが重なっているので、成績に差が出ても、どちらの影響かを区別できません。また、クラスが1つずつでは、反復も不足しています。
確認問題
問1
層化抽出の説明として、最も適切なものを1つ選んでください。
- 名簿から最初の1人を無作為に選び、その後は一定の間隔で選んでいく
- 母集団を集団に分け、無作為に選んだ集団に属する全員を調査する
- 母集団を性質の似た層に分け、すべての層からそれぞれ無作為に選ぶ
- 地域を無作為に選び、選んだ地域の中からさらに世帯を無作為に選ぶ
問1の解答と解説
正解は 3 です。
- 1 は誤りです。系統抽出の説明です
- 2 は誤りです。集落(クラスター)抽出の説明です
- 3 が正解です。層化抽出では、すべての層から標本を選びます
- 4 は誤りです。二段抽出(多段抽出)の説明です
問2
観察研究と実験研究について、正しい説明を1つ選んでください。
- 実験研究では、処理を無作為に割り付けることで、交絡の影響を抑えられる
- 観察研究では、標本を十分に大きくすれば、交絡の影響を取り除ける
- 実験研究は、対照群を置かないほうが、処理の効果を正確に測定できる
- 観察研究は、研究者が対象者に処理を割り当てて、結果を比べる研究である
問2の解答と解説
正解は 1 です。
- 1 が正解です。無作為に割り付けると、処理以外の要因がグループの間で平均的にそろいます
- 2 は誤りです。交絡は偏りの問題なので、標本を大きくしても取り除けません
- 3 は誤りです。対照群がなければ、処理をしなかった場合と比べられません
- 4 は誤りです。処理を割り当てるのは実験研究です。観察研究は、対象に手を加えずに観察します
講師向けの補足
- 抽出法は、受講者自身を母集団にして実演すると定着します。出席番号で系統抽出を行う、部署を層にして層化抽出を行う、などです
- 層化抽出と集落抽出の違いは、必ず混同されます。「層化はすべての層から選ぶ、集落は一部の集落だけを選ぶ」という対比を、図とあわせて繰り返してください
- 交絡の説明は、第3回の見かけの相関とつなげると理解が深まります。「この比較は公平か」と問いかける習慣を付けてもらいます
- フィッシャーの3原則は、名前の暗記で終わりがちです。「この原則を守らないと、何が起こるか」を、畑や教室の例で考えてもらいましょう
まとめ
- 標本誤差は標本を大きくすると小さくなる。非標本誤差は小さくならない
- 抽出法は、単純無作為、系統、層化、集落、多段を区別する
- 層化抽出はすべての層から選び、集落抽出は選んだ集落の全員を調べる
- 観察研究には交絡の問題がある。実験研究は、無作為割り付けによって交絡を抑える
- フィッシャーの3原則は、反復、無作為化、局所管理
次回からは、確率の分野に入ります。条件付き確率、ベイズの定理、確率変数の期待値と分散を学びます。
統計検定は、一般財団法人統計質保証推進協会の登録商標です。この記事の例題と問題は、公表されている出題範囲表をもとに独自に作成したもので、過去の試験問題ではありません。
投稿者プロフィール