
画像認識アルゴリズムの系統図と代表的手法の基礎知識
 山崎講師
こんにちは。ゆうせいです。
コンピューターが写真や映像に何が写っているかを判断する技術を画像認識と呼びます。人間は目から入った光の情報を脳で瞬時に処理して周囲の物体を把握しますが、コンピューターにとっては画像も単なる数値の並びです。そのため、画像内の形状や色合いといった情報をどのように整理して分類するかが長年研究されてきました。
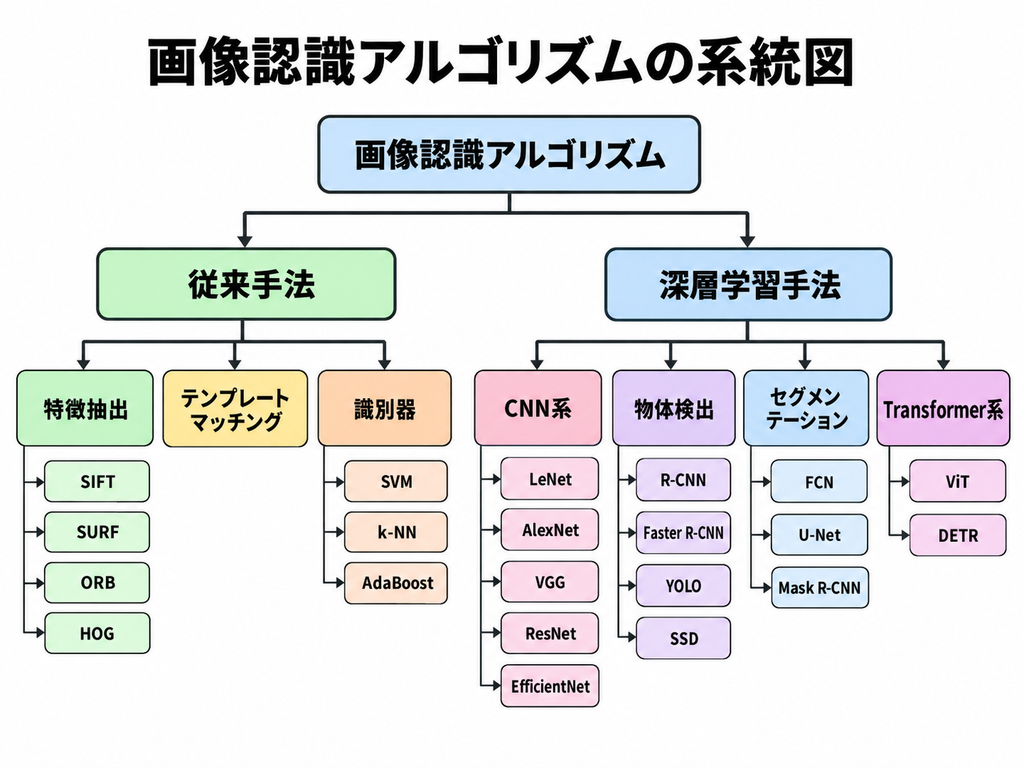
提示された系統図では、画像認識の技術が従来手法と深層学習手法の2つに大きく分類され、それぞれの目的や役割に応じたアルゴリズムが体系化されています。本稿では、各分類におけるアルゴリズムの役割、仕組み、長所や課題を整理して解説します。
画像認識における2大分類
画像認識の歴史は、人間が計算規則を設計した時代と、コンピューター自身が規則を学習する時代に分かれます。
従来手法は、輪郭や明暗の差など、画像の中から着目すべき基準を人間が数学的に設計してコンピューターに教え込む手法です。例えるなら、美術のデッサンにおいて指導者が輪郭線の引き方や陰影の付け方の型を細かく指定し、生徒がその型通りに測って対象を見分けるやり方にあたります。
深層学習手法は、大量の画像データを多層のニューラルネットワークに入力し、どの部分に着目すべきかという特徴の抽出規則自体をコンピューターに自動で獲得させる手法です。こちらは、膨大な数の名画を鑑賞する中で、鑑賞者自身が独自の感覚と基準を養って作品の様式を見分けられるようになる過程に似ています。
従来手法の構成とアルゴリズム
従来手法は、画像から目印となる情報を取り出す工程、あらかじめ用意した見本と照らし合わせる工程、取り出した情報から種類を判別する工程に分かれます。
特徴抽出
画像の中から回転や拡大縮小の影響を受けにくい目印を取り出す技術です。
- SIFT:画像の回転や拡大縮小に対して頑健な特徴点を取り出す手法です。
- SURF:SIFTの計算処理を近似計算によって高速化した手法です。
- ORB:特許の制約を受けずに高速な計算を行えるように設計された手法です。
- HOG:画像の局所的な明るさの傾き方向をヒストグラム化し、人や物体の輪郭形状を抽出する手法です。
- メリット:計算手順が明確に定義されているため、どのような基準で特徴が取り出されたのかを追跡できます。
- デメリット:天候や照明の変化、物体の複雑な変形に対して人間が設計した規則のみで対応することには限界があります。
テンプレートマッチング
探したい対象の見本画像を準備し、入力画像の上を少しずつずらしながら重ね合わせて一致度を測定する手法です。
- メリット:見本画像と類似した対象を探す場合、事前の学習処理を必要とせずに実装できます。
- デメリット:対象の大きさが変わったり角度が傾いたりすると、一致度が低下して検出に失敗しやすくなります。
識別器
抽出された数値データを受け取り、どのグループに属するかを境界線によって判断する仕組みです。
- SVM:2つのグループの境界線と最も近いデータとの距離を最大化するように境界を決定する手法です。
- k-NN:新しいデータの周辺にある既知のデータのうち、距離が近いk個の多数決で分類を決める手法です。
- AdaBoost:精度の低い単純な判定器を複数組み合わせ、徐々に判定精度を高める手法です。
- メリット:データの次元数が限定されている場合、安定した分類結果を出力できます。
- デメリット:入力となる特徴量の品質が分類精度に直結するため、特徴抽出の段階で有効な情報が欠落していると正しく判別できません。
深層学習手法の発展と目的別アプローチ
深層学習手法は、画像全体の分類だけでなく、位置の特定や領域の分割など、用途に応じて構造が進化してきました。
CNN系(画像全体の分類)
畳み込みニューラルネットワークと呼ばれ、局所的な特徴を抽出する畳み込み層と、位置のずれを許容するプーリング層を重ねた構造を持ちます。
- 構成モデル:LeNet、AlexNet、VGG、ResNet、EfficientNet
- メリット:画像の縦横の空間的なつながりを保持したまま学習でき、従来手法を上回る識別性能を発揮します。
- デメリット:層を深く積み重ねるにつれて計算量が増大し、大規模な計算資源が必要になります。
物体検出(位置の特定と分類)
画像の中に存在する物体の位置を四角い枠で囲み、その枠の中に何があるかを同時に予測する技術です。
- 構成モデル:R-CNN、Faster R-CNN、YOLO、SSD
- メリット:1枚の画像の中に複数の物体が混在していても、それぞれの位置と種類を同時に把握できます。
- デメリット:領域の候補を探す処理と分類処理を両立させる必要があり、モデルの構造が複雑になります。
セグメンテーション(画素単位の領域抽出)
画像の四角い枠ではなく、画素(ピクセル)の1粒ごとにどの物体に該当するかを塗り分ける技術です。
- 構成モデル:FCN、U-Net、Mask R-CNN
- メリット:医療用画像の臓器輪郭や自動運転における走行可能領域など、境界形状を精密に抽出できます。
- デメリット:すべての画素に対して正解ラベルを付与した教師データを用意する作業コストが非常に大きくなります。
Transformer系(広範囲の関係性の把握)
自然言語処理で使われていた自己注意機構を画像分野に応用した構造です。画像を格子状の小さな板に分割し、それぞれの板の相互関係を計算します。
- 構成モデル:ViT、DETR
- メリット:画像全体の離れた場所にある要素同士の関係性を同時に捉えることができます。
- デメリット:十分な精度を達成するために、CNN系よりもさらに大量の学習データを必要とします。
まとめ
画像認識の技術は、人間が輪郭や特徴を設計していた従来手法から、データから直接パターンを抽出する深層学習手法へと発展してきました。さらに深層学習の中核も、全体の分類を行うCNNから、位置を捉える物体検出、画素を塗り分けるセグメンテーション、大域的な相関を捉えるTransformerへと適用範囲が広がっています。
画像認識を実践的に学ぶためのステップとして、まずはSVMなどの識別器を用いた基本的な数値分類の挙動を確認し、次に畳み込みニューラルネットワークによる手書き文字や身近な物体の画像分類を実装した上で、物体検出や領域分割といった発展的なモデルの構築へと学習を進めることを推奨します。
セイ・コンサルティング・グループでは新人エンジニア研修のアシスタント講師を募集しています。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。

