
Excelの近似曲線からディープラーニングへ データ予測の仕組みと発展
 山崎講師
こんにちは。ゆうせいです。
表計算ソフトのExcelでは、散布図などのグラフに点在するデータから傾向を捉えるために「近似曲線」を追加する機能が用意されています。散らばった点の間を縫うように線を1本引く作業は、未知の数値を予測するための基礎的なアプローチです。
この記事では、Excelで利用できる代表的な近似曲線の特徴やメリット・デメリットを整理したうえで、これらの数式モデルが抱える限界と、その限界を解消するために登場したディープラーニング(深層学習)への繋がりについて解説します。
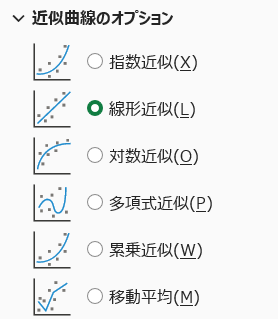
Excelで選択できる近似曲線の種類と特徴
Excelのオプションには、データの散らばり方に応じて複数の近似モデルが用意されています。
線形近似
線形近似は、データ全体に直線を当てはめる手法です。数学的には一次方程式 y = ax + b で表されます。
身近な例えを用いると、定規をデータ群の真ん中に当ててまっすぐ線を引くような操作にあたります。
- メリット:計算手順が簡潔であり、傾き a と切片 b の意味を直感的に把握できます。
- デメリット:直線的な関係性しか表現できないため、急激な増減を含むデータには適合しません。
多項式近似
多項式近似は、曲がりくねった曲線を用いてデータを表現する手法です。方程式 
針金を曲げて複数の山や谷に沿わせる作業に似ています。
- メリット:山や谷が複数ある複雑な変化を柔軟に追従できます。
- デメリット:次数を上げすぎると、手元のデータの点だけを無理に通ろうとして極端な形状になり、データが存在しない区間の予測精度が低下します。
指数近似・対数近似・累乗近似
これらは、急激な変化や頭打ちになる傾向を捉えるための曲線です。
- 指数近似:時間が進むにつれて増え方が加速度的に大きくなる現象(細菌の増殖や複利の増加など)に適しています。
- 対数近似:初期は急激に変化し、次第に緩やかになって平らへ近づく現象(学習の習熟度や音の知覚など)に適しています。
- 累乗近似:二つの数値の比率が常に一定の累乗関係を保ちながら増加する現象に適しています。
メリット:一定のペースではなく、加速または減速を伴う自然現象や経済活動の推移を正確に追従できます。
デメリット:0以下の数値や負の値を計算に含められない場合があり、扱えるデータ範囲に制限が生じます。
移動平均
移動平均は、数式による関数ではなく、一定期間ごとの平均値を順に繋ぎ合わせた折れ線です。
株価チャートのように小刻みなブレが大きいデータから、細かな雑音を取り除いて大まかな流れを見る用途で使われます。
- メリット:複雑な数式を決定することなく、局所的な変動を滑らかにして傾向を視覚化できます。
- デメリット:過去のデータの平均値をつなぐ仕組みであるため、将来の未知の値を予測する数式としては機能しません。
Excelの近似曲線が抱える限界
Excelの近似曲線は手軽で視覚的にもわかりやすい一方、複雑な実社会の課題を解く際には明確な制約が存在します。
- 扱える入力(変数)が基本的に1つに限られる点:Excelの近似曲線は横軸 x と縦軸 y の2つの関係性のみを扱います。気温、天候、曜日、価格など複数の要素が絡み合う現象をそのまま1本の曲線で表すことは困難です。
- 人間があらかじめ数式の形を決めなければならない点:線形、指数、多項式といった数式の骨組みを人間が指定する必要があります。データの背後にある仕組みが未知である場合、適切な形状を選択できません。
- 高次元データへの非対応:画像データや音声データのように、数千から数万の数値が組み合わさった対象に対して曲線を当てはめることは構造上不可能です。
限界を超える技術としてのディープラーニング
Excelの近似曲線における制約を克服する技術として発展したのが、人工知能分野のディープラーニングです。
ディープラーニングは、人間の脳の神経細胞(ニューロン)のネットワークを模した数式モデルです。複数の計算層を何重にも積み重ねることで、従来の単一の数式では表現できなかった極めて複雑な関係性を捉えます。
Excelの近似曲線が「1枚の硬い板や針金を曲げて点に合わせる作業」だとすれば、ディープラーニングは「無数の関節を持つ網を広げて、多面的なデータの隙間にぴったり吸着させる作業」に例えられます。
- メリット:人間が数式の形状を指定しなくても、膨大なデータから自律的に最適な変換規則を組み立てます。また、数百から数千種類の異なる要素を同時に入力として扱えます。
- デメリット:計算プロセスが高度に複雑化しているため、なぜその予測結果に至ったのかという途中計算の根拠を人間が読み解くことが困難になります。また、正常に機能させるために膨大なデータ量と高い計算処理能力を必要とします。
まとめ
Excelの近似曲線は、データ分析の第一歩としてデータの傾向を直感的に掴むために有用なツールです。線形近似や多項式近似などの基本モデルを理解することは、将来の予測や関係性の把握に向けた土台となります。
データ分析の学習を進める際は、次の順序で理解を深める方法が合理的です。
- Excelの散布図を作成し、線形近似および多項式近似を用いて手元のデータの傾向を数値化する。
- 重回帰分析を学び、2つ以上の要素(入力変数)から数値を予測する計算手順を確認する。
- 機械学習の基礎として、手動の関数当てはめとアルゴリズムによる自動最適化の相違点を把握する。
- ディープラーニングの構造を学び、多層のネットワークが複雑なデータパターンを変換する仕組みへと視野を広げる。
段階的に手法を拡張していくことで、基礎的な回帰分析と最新の人工知能技術が同じ「データからパターンを見つけ出す試み」の延長線上にあることを整理できます。
セイ・コンサルティング・グループでは新人エンジニア研修のアシスタント講師を募集しています。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。

