k-means法の目的関数と更新式:仕組みと導出の整理
 山崎講師
こんにちは。ゆうせいです。
データを似た者同士のグループに分ける手法は、機械学習の領域でクラスタリングと呼ばれます。クラスタリングの代表的な手法であるk-means法は、単純な規則を繰り返すことでデータを分類します。分類の手順そのものは直感的ですが、背景にある目的関数や更新式の数学的な意味を把握しておくと、アルゴリズムの挙動を体系的に理解できます。
k-means法がどのような基準でグループを決定し、どのように計算を更新していくのかを順番に確認していきます。
k-means法の全体像と専門用語の整理
k-means法は、あらかじめ指定したk個のグループ(クラスタ)にデータを分割するアルゴリズムです。処理は、各データへのグループの割り当てと、グループの中心(重心)の更新という2つの操作を交互に繰り返すことで進みます。
この手法を理解するために、2つの基本的な概念を整理します。
クラスタと重心
クラスタとは、似た特徴を持つデータの集まりを指します。重心は、その集まりの真ん中に位置する代表点です。
学校のクラス分けを例に挙げます。体育館に散らばった生徒たちを3つの班に分ける場面を想定します。各班のリーダーが立つ場所が重心であり、生徒たち各自が一番近くにいるリーダーの元へ集まってできた集団がクラスタに相当します。
目的関数
目的関数とは、アルゴリズムが目指すべき達成度を数値で表した基準式です。k-means法では、各データと所属するグループの重心との距離の二乗を足し合わせた値が目的関数になります。
再び体育館の例で考えます。各生徒と班長との間の移動距離を合計した値が目的関数の値です。この合計距離が小さくなればなるほど、全員が近くの班長のもとに綺麗にまとまっている状態を意味します。k-means法の目的は、この合計値を最小化することです。
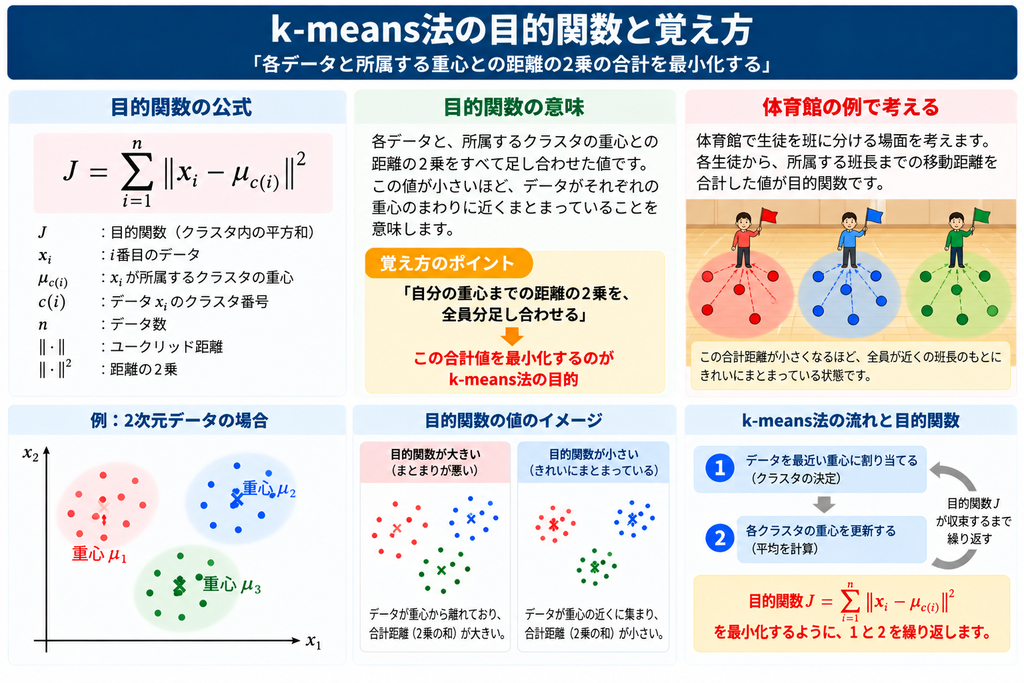
k-means法の目的関数
データ点の数をN、クラスタの数をKとします。i番目のデータ点を $x_{i}$ 、k番目のクラスタの重心を $\mu_{k}$ と表します。また、データ点 $x_{i}$ がクラスタkに所属している場合に1をとり、それ以外の場合に0をとる指標を $r_{ik}$ と定義します。
このとき、k-means法の目的関数Jは次の式で表されます。

この式は、それぞれの生徒から自分が所属する班長までの距離の二乗を、全生徒分足し合わせる計算を表しています。値が0に近づくほど、各グループのまとまりが強くなります。
2段階の更新式とその導出
k-means法は、目的関数Jの値を小さくするために、所属の決定(ステップ1)と重心の再計算(ステップ2)を繰り返します。
ステップ1:クラスタへの割り当て(rの最適化)
重心 $\mu_{k}$ の位置を固定したまま、生徒側が動く操作です。各データ点 $x_{i}$ に対し、最も距離が近い重心を持つクラスタへ割り当てます。
数式による更新条件は以下の通りです。

それぞれの生徒が、周囲を見渡して最も近い班長のところへ並び直す操作に相当します。最短距離の班長を選ぶため、この操作によって目的関数Jの値は減少するか、少なくとも変化しません。
ステップ2:重心の更新(μの最適化)
生徒の所属 $r_{ik}$ を固定したまま、班長側が動く操作です。各クラスタkに所属するデータ点の平均座標を計算し、その位置へ重心 $\mu_{k}$ を移動させます。
クラスタkに割り当てられたデータ数を $N_{k}$ と置くと、更新式は次の分数式で表されます。

班長が、自分の班に集まった生徒全員の位置の平均値(中心地点)へ移動する操作に相当します。数学的には、二次関数の頂点を求めるのと同様に、目的関数Jを $\mu_{k}$ で偏微分して0と置くことでこの平均値の式が導かれます。
k-means法のメリット
客観的に確認できるk-means法の利点は以下の点です。
- 計算処理の簡潔さ 計算内容が距離の算出と平均値の計算のみで構成されているため、大量のデータを扱う際にも高速に処理できます。
- 直感的な解釈性 データを重心を中心とした球状のグループに分けるという規則が明確であり、処理の結果を直感的に把握できます。
- 収束の保証 ステップ1とステップ2を実行するたびに目的関数Jの値が減少または維持されるため、有限回の更新で必ず計算が収束します。
k-means法のデメリット
一方で、アルゴリズムの仕様上生じる課題や制約は以下の点です。
- クラスタ数の事前決定が必要 グループ数kの値を人間が事前に指定しなければならず、適切なkの値を見極めるための追加検証が求められます。
- 初期値への依存性 最初にランダム配置される重心の位置によって、最終的に得られるクラスタ分けの結果が大きく変わる性質があります。全体としての最小値ではなく、局所的な安定状態(局所解)に陥る場合があります。
- 非球状のデータに対する脆弱性 ユークリッド距離に基づく重心からの距離を基準とするため、細長い形状やドーナツ状に広がる分布のデータを正しく分割できません。
まとめと次の学習ステップ
k-means法は、データと重心の距離の二乗和である目的関数Jを最小化するために、所属の割り当てと重心の平均値更新を交互に繰り返す枠組みです。この「割り当てと重心更新の繰り返し」という構造は、より発展的な機械学習アルゴリズムでも共通して使われる基礎概念です。
理解を深めるための学習ステップは以下の通りです。
- 初期値の選び方を改善したk-means++法のアルゴリズムを調べる
- 適切なクラスタ数kを決定するエルボー法やシルエット分析の評価基準を学ぶ
- 確率的に所属を決定するソフトクラスタリング(混合ガウスモデルとEMアルゴリズム)の枠組みを確認する
数式の背景にある物理的なイメージと最小化の仕組みを結びつけておくことで、より高度な分類手法へスムーズに応用できます。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 山崎講師2026年10月28日研修講師のための発信者情報開示請求入門 中傷されたときの判断手順と現実的なコスト
 新人エンジニア研修講師2026年10月28日tanh関数とその微分の覚え方:基本定義と1引く二乗の公式を再現する手順
 新人エンジニア研修講師2026年10月28日シグモイド関数とその微分の覚え方:基本定義と公式を素早く再現する手順
 新人エンジニア研修講師2026年10月28日適合率・再現率・F値の公式の覚え方:分母の違いから整理する評価指標の基本