KLダイバージェンスの数式の意味と覚え方:初心者向け解説
 山崎講師
こんにちは。ゆうせいです。
機械学習や統計学を学んでいると、KLダイバージェンス(カルバック・ライブラー情報量)という概念が登場します。KLダイバージェンスは、2つの確率分布がどれくらい似ているか、あるいは離れているかを測る指標です。数式を見ると複雑に感じられますが、意味を分割して理解することで、丸暗記に頼らずに覚えることができます。本記事では、KLダイバージェンスの数式の構造と覚え方を解説します。
KLダイバージェンスの数式と専門用語
まず、KLダイバージェンスの基本となる数式を確認します。離散型確率分布の場合、数式は以下のようになります。

式に含まれる記号には、それぞれ専門的な意味があります。
- P(x)は、基準となる真の確率分布を表します。実際に起きる現象の確率です。
- Q(x)は、比較対象となる推定した確率分布を表します。予測やモデルによって導き出された確率です。
- logは対数関数を表し、情報量を計算する際に用いられます。
- シグマ記号は、すべての事象xについて計算結果を足し合わせることを意味します。確率の期待値を求める操作に相当します。
数式の意味:高校生向けの比喩で解説
専門用語を並べただけではイメージしにくいため、高校の学園祭における模擬店の売上予測を例に考えてみます。
あるクラスが学園祭で、たこ焼き、焼きそば、クレープの3種類を販売すると想定します。
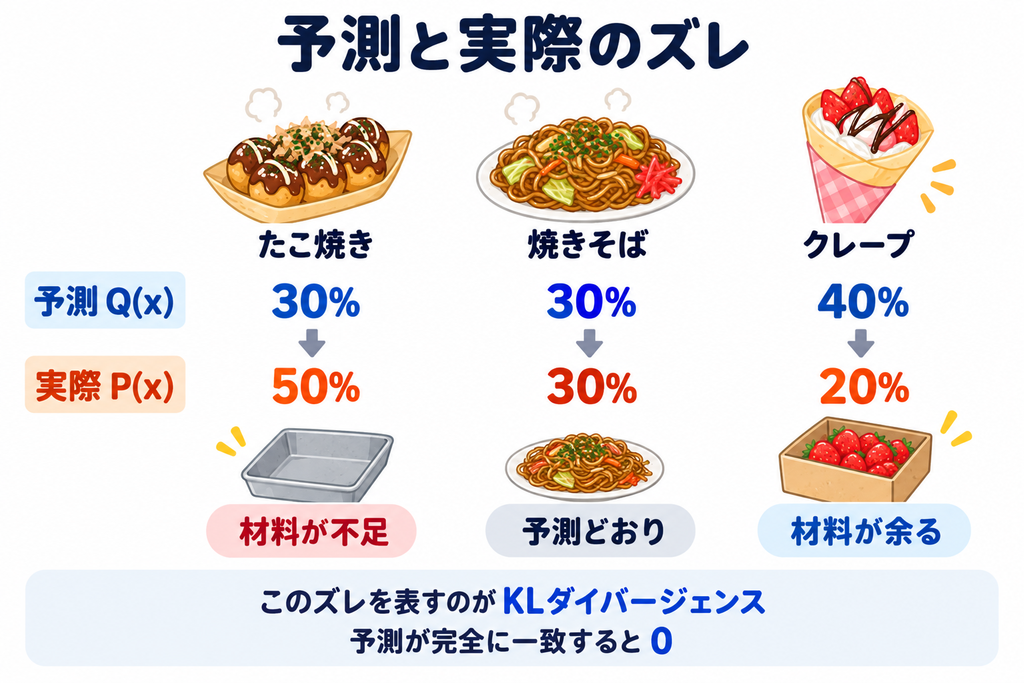
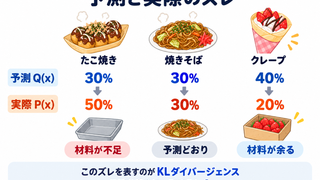
P(x)を、当日実際に売れた商品の割合とします。たとえば、たこ焼きが50%、焼きそばが30%、クレープが20%という割合が真の確率分布P(x)です。
一方、Q(x)を、学園祭の準備段階でクラスの生徒たちが予測した売上の割合とします。生徒たちは、たこ焼き30%、焼きそば30%、クレープ40%売れると予測して材料を仕入れました。生徒たちの予測が推定した確率分布Q(x)です。
当日の実際の売上割合P(x)と、予測した売上割合Q(x)の間にはズレがあります。予測に反してクレープの材料が余り、たこ焼きの材料が不足する状態です。KLダイバージェンスは、生徒たちが予測Q(x)に基づいて準備を行った際に、実際の売上P(x)に直面してどれくらい無駄な手間や驚きが発生したかを数値化したものです。予測が完全に的中していればズレは生じず、KLダイバージェンスの値はゼロになります。
数式の仕組みと覚え方
KLダイバージェンスの数式を覚える際は、数式を2つの部分に分けて捉える方法が効果的です。
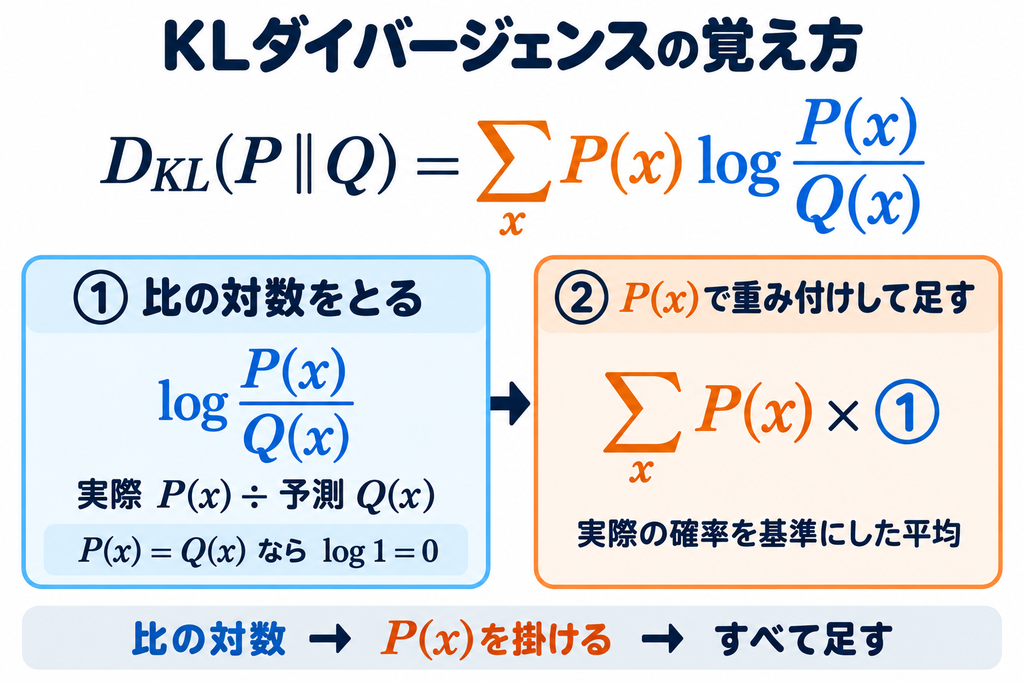
最初に、数式の右側にある分数と対数の部分に注目します。分子に真の確率分布P(x)、分母に推定した確率分布Q(x)を配置して割り算を行っています。P(x)とQ(x)の値が一致している場合、割り算の結果は1になります。対数関数logの性質として、真数が1のときは値が0になります。つまり、予測と現実が完全に一致していれば、対数部分の計算結果は0になります。
次に、数式の左側にあるP(x)とシグマ記号に注目します。対数部分で計算した予測と現実のズレに対して、実際の確率であるP(x)を掛け合わせ、すべてのパターンについて足し算を行います。数式全体は、現実に起こる確率P(x)を基準にして、予測とのズレの平均値(期待値)を計算している状態を表しています。
覚える際の手順としては、まず予測と現実の比率を対数にする部分を思い出し、その後、実際の確率P(x)の視点で平均をとるためにシグマ記号とP(x)を掛け合わせる、という順序で組み立てると記憶に定着しやすくなります。
KLダイバージェンスのメリットとデメリット
KLダイバージェンスを利用する際の特徴を以下にまとめます。
メリット
- 機械学習において、人工知能の予測モデルが実際のデータにどれくらい近づいているかを評価する指標として優れている点。
- 分布の違いをひとつの数値として明確に定量化できるため、モデルの改善度合いを測る尺度として活用できる点。
デメリット
- P(x)からQ(x)を見た場合の値と、Q(x)からP(x)を見た場合の値が異なる点。距離のように双方向で同じ値にならないため、対称性が求められる場面では扱いにくい性質があります。
- 確率分布Q(x)の中に確率がゼロになる事象が存在すると、計算過程で分母がゼロになったりゼロの対数をとる状態になり、計算が成立しなくなる点。
まとめと今後の学習ステップ
KLダイバージェンスの数式は、実際の確率分布P(x)と予測した確率分布Q(x)のズレを、実際の事象が起こる確率を基準にして平均化したものです。それぞれの記号が持つ役割を理解することで、数式の形を自然に導き出すことができます。
KLダイバージェンスをさらに深く理解するためには、以下のステップで学習を進めることを推奨します。
- 情報量の定義であるマイナス対数の概念について学習し、確率と情報量の関係を把握する。
- 期待値の計算方法を復習し、確率分布を掛け合わせてシグマ記号で足し合わせる操作に慣れる。
- 簡単なサイコロやコインの確率分布を設定し、真の分布と偏った予測分布を用いて、手作業でKLダイバージェンスの値を計算する。
- 交差エントロピーやエントロピーといった関連する概念との数式的なつながりを確認する。
一つひとつの概念を積み上げることで、複雑な数式もスムーズに扱えるようになります。着実に学習を進めていってください。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 新人エンジニア研修講師2026年10月14日GAN(敵対的生成ネットワーク)の数式の意味と覚え方:初心者向け解説
 新人エンジニア研修講師2026年10月14日KLダイバージェンスの数式の意味と覚え方:初心者向け解説
 新人エンジニア研修講師2026年10月14日ベイズの定理で分母に周辺確率が来る理由:初心者向け解説
- 新人エンジニア研修講師2026年10月14日周辺確率の名称の由来と表の余白から生まれた計算の仕組み