RMSPropの仕組みと更新式の覚え方:指数移動平均を用いた学習率調整の基礎
 山崎講師
こんにちは。ゆうせいです。
ニューラルネットワークをはじめとする深層学習のモデルを訓練する際、パラメータを効率的に調整するための手法として最適化アルゴリズムが使われます。その代表的な手法の1つがRMSProp(アールエムエスプロップ)です。
基本的な勾配降下法を改良したAdaGradという手法の課題を克服するために提案された経緯があり、多くの深層学習フレームワークで標準機能として実装されています。
計算式には複数の記号や添字が含まれるため難解に見えがちですが、式の構造を部品ごとに分解して確認することで、各処理が果たす役割と数式の形を体系的に理解できます。
本記事では、初心者の方に向けてRMSPropの基本概念から更新式の仕組み、覚え方、利点と留意点、そして理解を深める学習の手順を解説します。
RMSPropの基本概念
RMSPropは、ニューラルネットワークの重みを更新する際、過去の勾配の大きさに応じてパラメータごとに学習の歩幅(学習率)を自動調整するアルゴリズムです。
正式名称の「Root Mean Square Propagation」が示す通り、勾配の二乗平均の平方根を利用して更新量を調整します。
谷底を目指す歩幅の調整による比喩
高校の部活動で行うクロスカントリー走やハイキングの場面を想定します。
霧が濃い山の中で、最も標高が低い谷底を目指して下山する状況を考えます。
急な崖のように勾配が険しい方向へ進むとき、大股で勢いよく進むと谷底を飛び越えて反対側の斜面に激しく衝突してしまいます。反対に、傾斜がほとんどない平坦な道では、小股のまま進んでいるとなかなか前に進みません。
RMSPropは、「直近で急な坂道が続いている方向に対しては歩幅を狭くし、緩やかな坂道が続いている方向に対しては歩幅を広く維持する」という調整を自動で行う仕組みです。これにより、左右への激しい揺れを抑えながら、谷底に向かって効率的に進むことができます。
構成する記号の整理
数式を読み解くために使用する記号の意味を整理します。
- θ:更新対象となるモデルの重みパラメータ
- g:現在のステップにおける損失関数の傾き(勾配)
- v:過去から現在に至る勾配の二乗の移動平均
- β(または α):過去の情報をどれくらい残すかを決める減衰率(通常は0.9などの値が設定されます)
- η:基準となる学習率
- ε:分母が0になることを防ぐための微小な定数(例:1e-8)
- t:現在の更新回数(ステップ数)
RMSPropの更新式と構造の分解
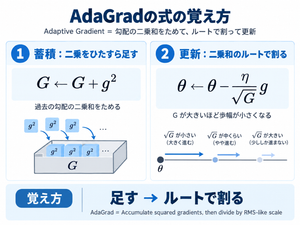
RMSPropのパラメータ更新は、2段階の計算手順で行われます。
第1段階で過去の勾配の大きさを蓄積し、第2段階でその蓄積量を使ってパラメータを移動させます。
1. 勾配の二乗平均を更新する式
最初の段階では、現在のステップにおける勾配 g の二乗を、過去の蓄積値 v と混ぜ合わせます。

この式は、統計学で「指数移動平均」と呼ばれる計算方式です。
右辺の第1項である β v_{t-1} は、過去の履歴を β の割合(例:90%)だけ引き継ぐことを意味します。
右辺の第2項である (1 - β) g_{t}^{2} は、最新の勾配の二乗を残り(例:10%)の割合だけ取り入れることを意味します。
過去の値を少しずつ割り引いて減衰させながら新しい値を足し合わせるため、大昔の極端な勾配の影響が薄れ、直近の坂の険しさが v に反映されます。
2. パラメータを更新する式
第2段階では、計算した v を用いて重みパラメータ θ を更新します。

この式は、基本の勾配降下法(θ = θ - η g)の学習率 η の部分を修正した形をしています。
分母にあるルート計算部分は、勾配の二乗平均の平方根(Root Mean Square)です。
直近で勾配 g が大きかった方向は v も大きくなるため、分母が大きくなり、実質的な学習率が小さく抑えられます。
直近で勾配 g が小さかった方向は v が小さくなるため、分母が小さくなり、歩幅が縮まらずに進み続けることができます。
足されている ε は、v が 0 になったときに 0 で割る計算エラーを避けるための安全装置です。
式の覚え方
RMSPropの式を記憶する際は、次の2つの段階を順序立てて捉える方法が効果的です。
- 蓄積:二乗を混ぜる(過去を9割残し、最新の二乗を1割足す)
- 更新:平方根で割る(基準学習率を直近の二乗平均のルートで割って進む)
「直近の二乗平均を求めて、その平方根(RMS)で勾配を割って更新する」という言葉の流れと対応づけることで、分母に平方根が配置される理由と全体の構成を正確に整理できます。

RMSPropの利点と留意点
RMSPropを最適化アルゴリズムとして採用する際には、事実に基づく利点と留意すべき点が存在します。
利点
- 学習の停滞(学習率の極端な低下)の防止先行手法であるAdaGradは過去の勾配の二乗を単純にすべて加算していくため、学習が進むにつれて分母が無限に増大し、最終的に学習率がほぼ0になって更新が止まる問題がありました。RMSPropは古い情報を指数関数的に忘却させるため、長時間の学習でも適切な歩幅が維持されます。
- 振動の抑制による収束の加速急勾配の方向への過剰な跳ね返りを抑え、緩やかな方向へ着実に進むことができるため、狭い谷のような形状をした損失面において効率的に最適解へ近づきます。
留意点
- ハイパーパラメータの追加基本の学習率 η に加えて、減衰率 β や微小値 ε をあらかじめ設定する必要が生じます。
- 運動量(モメンタム)の未考慮勾配の大きさに基づいた歩幅の調整は行いますが、進行方向への加速をつける機能(モメンタム)は単体では備わっていません。この機能とRMSPropを組み合わせた手法が、現在広く使われているAdamというアルゴリズムです。
まとめ
RMSPropの公式は、急な坂道での跳ね返りを防ぎ、平坦な道での進行を促すための合理的な工夫に基づいています。
- 過去の二乗勾配を指数移動平均で減衰させながら蓄積する
- 蓄積した値の平方根で学習率を割ることで、パラメータごとに歩幅を最適化する
- AdaGradの学習停止問題を解決し、長期的なパラメータ調整を可能にする
RMSPropに関する理解を確実なものにするためには、次の順序に沿って学習を進める方法が有効です。
- 基本的な最急降下法(SGD)の更新式を確認し、学習率が固定されている場合の挙動を把握する。
- AdaGradの式を調べ、単純な二乗和の蓄積とRMSPropの指数移動平均との数式上の相違点を確認する。
- 勾配 g = 2.0 や g = 0.1 などの数値例、減衰率 β = 0.9 を設定し、手計算で2ステップ分のパラメータ更新を追う。
- RMSPropの考え方にモメンタムの仕組みを統合した発展アルゴリズムであるAdamの更新式へと学習対象を広げる。
投稿者プロフィール