
機械学習の系統図 全体像を一枚で捉える
 山崎講師
こんにちは。ゆうせいです。
機械学習を学び始めた人が最初に困るのは、用語の多さです。
教師あり学習、クラスタリング、ランダムフォレスト、強化学習、Transformer。次々と新しい名前が出てきますが、それぞれがどういう関係にあるのかが分かりません。
地図を持たずに知らない街を歩いているようなものです。
この記事では、機械学習の全体像を系統図として整理します。何がどこに属するのか、なぜそう分類されるのか。ここが分かれば、新しい手法を学ぶときも「あの枝の話だな」と位置づけられるようになります。
結論
系統図を読むときの要点は、三つです。
| 要点 | 内容 |
|---|---|
| 系統図は一つではない | 学習の仕方、解く課題、モデルの構造。分類軸が複数ある |
| 枝は排他ではない | 一つの手法が複数の枝に属することがある |
| 最上位は包含関係 | AIの中に機械学習があり、その中にディープラーニングがある |
特に二番目を強調しておきます。
生物の分類と違い、機械学習の分類は厳密な階層ではありません。ニューラルネットワークは教師あり学習でも教師なし学習でも使えます。
系統図は、理解を助ける整理の道具であって、絶対的な区分ではありません。この点を最初に伝えておかないと、受講者は「どちらが正しいのですか」という答えのない質問に囚われます。
以下、階層を上から順に見ていきます。
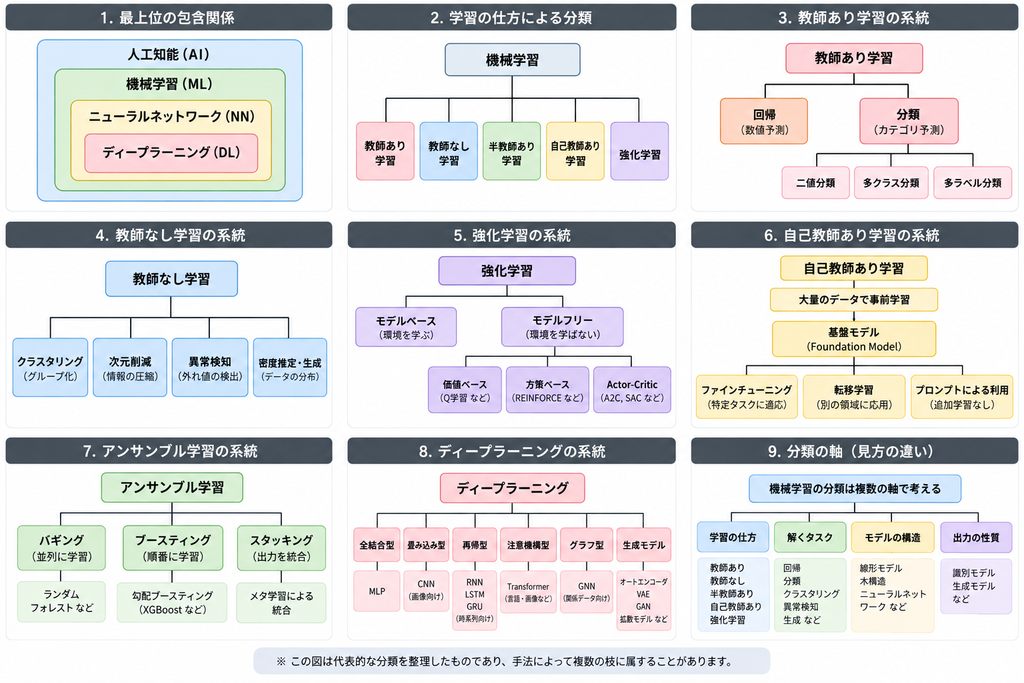
1 最上位の包含関係
まず、最も大きな枠組みからです。
三重の入れ子
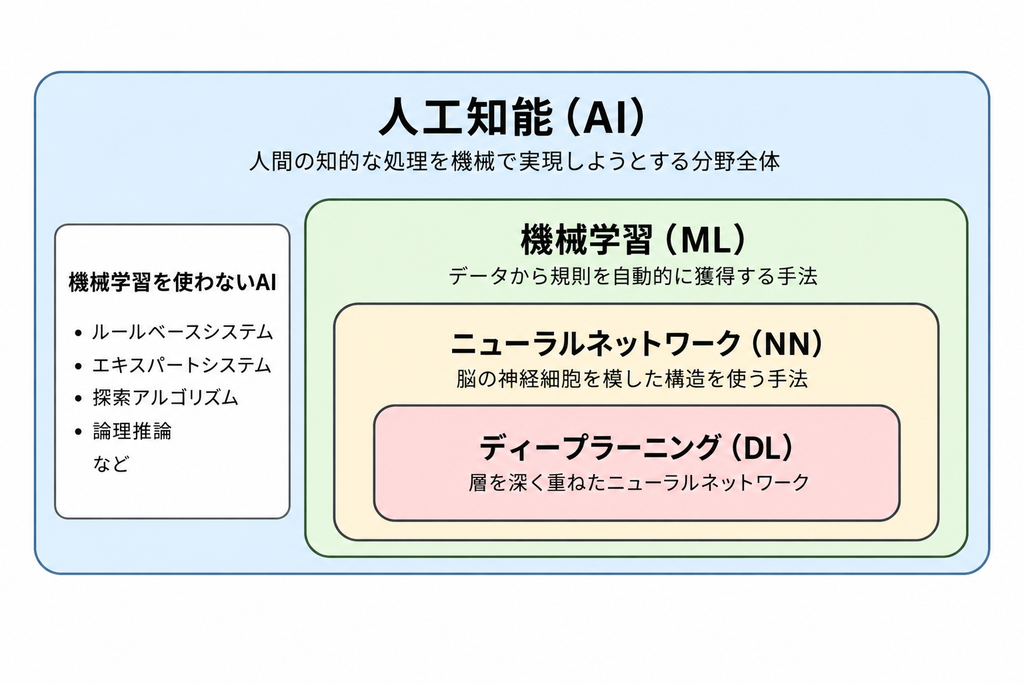
外側ほど広い概念です。
それぞれの定義
| 用語 | 内容 |
|---|---|
| 人工知能 | 人間の知的な処理を機械で実現しようとする分野全体 |
| 機械学習 | データから規則を自動的に獲得する手法 |
| ニューラルネットワーク | 脳の神経細胞を模した構造を使う手法 |
| ディープラーニング | 層を深く重ねたニューラルネットワーク |
機械学習でないAIもある
見落とされやすい点です。
人工知能には、機械学習を使わない手法もあります。
| 手法 | 内容 |
|---|---|
| ルールベースシステム | 人間が書いた条件分岐で判断する |
| エキスパートシステム | 専門家の知識をルール化して推論する |
| 探索アルゴリズム | 幅優先探索、深さ優先探索、A*など |
| 論理推論 | 述語論理による導出 |
1980年代の第二次AIブームを支えたのは、エキスパートシステムでした。データから学習するのではなく、人間が知識を書き下ろす方式です。
現在のAIブームでは機械学習が中心ですが、AIと機械学習は同義ではありません。
何が違うのか
決定的な違いは、規則を誰が作るかです。
従来のプログラムでは、人間が規則を書きます。「この条件ならこう動く」と明示します。
機械学習では、データから規則を導きます。人間が書くのは、学習の枠組みだけです。
料理の比喩
レシピを書くのが従来のプログラムです。「小麦粉100グラム、卵1個、180度で20分」と手順を指定します。
機械学習は違います。おいしいケーキと、そうでないケーキを大量に見せて、「何が違うのかを自分で見つけなさい」と指示します。
分量や温度は、機械が見つけ出します。
確認問題1
次のうち、機械学習に該当しないものを選んでください。
ア 迷惑メールを過去の事例から判別する仕組み
イ 「件名に特定の単語が含まれていたら迷惑メールとする」というルール
ウ 画像から猫を検出する仕組み
エ 購買履歴から商品を推薦する仕組み
解答 イ
解説します。
イは、人間が条件を書いたルールベースの処理です。データから規則を獲得していないため、機械学習ではありません。
ア、ウ、エはいずれも、データから規則を学習しています。
補足します。実務のシステムでは、両者が併用されることが珍しくありません。
明らかな条件はルールで処理し、判断が難しい部分を機械学習に任せる。この組み合わせは現実的な設計です。
2 学習の仕方による分類
最も基本的な分類軸です。系統図と言えば、まずこれを指します。
大枠
機械学習
 ├ 教師あり学習
 ├ 教師なし学習
 ├ 半教師あり学習
 ├ 自己教師あり学習
 └ 強化学習
伝統的には、最初の三つのうち教師あり、教師なし、強化学習の三分類で説明されてきました。近年は自己教師あり学習の重要性が増しており、独立して扱われることが多くなっています。
違いは何で決まるか
正解データの有無と与え方で決まります。
| 種類 | 正解データ | たとえ |
|---|---|---|
| 教師あり学習 | すべてに付いている | 答え付きの問題集で勉強する |
| 教師なし学習 | ない | 資料を渡されて自分で整理する |
| 半教師あり学習 | 一部だけ付いている | 答えが数問だけある問題集 |
| 自己教師あり学習 | データ自身から作る | 文章の一部を隠して当てる練習 |
| 強化学習 | 行動の結果として報酬が返る | 試行錯誤で自転車に乗る |
なぜこの区分が重要なのか
実務では、使えるデータの種類が手法を決めるためです。
正解ラベルを付ける作業には、人手と時間がかかります。医療画像に「がんかどうか」のラベルを付けるには、専門医の判断が必要です。
ラベルが用意できないなら、教師あり学習は選べません。系統図の枝を選ぶ前に、データの状況を確認する。この順序が実務の出発点です。
確認問題2
次の状況で、どの学習方法が適しているか答えてください。
(1) 過去10年分の住宅の面積と価格のデータがあり、新しい物件の価格を予測したい
(2) 顧客の購買履歴があるが、分類のラベルはない。似た傾向の顧客をまとめたい
(3) ゲームのルールだけが与えられており、勝つ手順を見つけたい
解答を示します。
(1) 教師あり学習です。面積が入力、価格が正解として与えられています。
(2) 教師なし学習です。正解ラベルがなく、データの構造を自分で見つける必要があります。
(3) 強化学習です。正解手順は与えられておらず、試行の結果として得られる勝敗から学びます。
補足します。(2)のように「グループに分けたい」という要求は、教師なし学習の典型です。
ただし、あらかじめ「優良顧客」「休眠顧客」といった区分が決まっていて、過去の分類実績があるなら、教師あり学習になります。同じ「顧客を分ける」でも、ラベルの有無で枝が変わります。
3 教師あり学習の系統
最も使われる領域です。細かく見ていきます。
二つのタスク
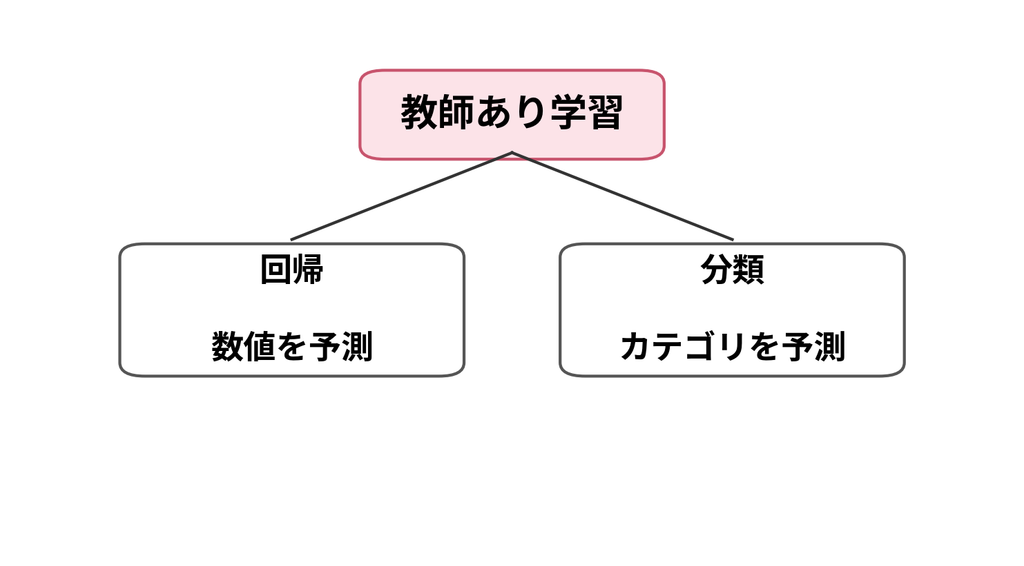
出力が連続値なら回帰、離散値なら分類です。
| タスク | 出力 | 例 |
|---|---|---|
| 回帰 | 実数値 | 売上予測、株価予測、気温予測 |
| 分類 | クラス | 迷惑メール判定、画像認識、疾病診断 |
境界が曖昧な場合
「明日の売上が100万円を超えるか」という問いは分類です。「明日の売上はいくらか」は回帰です。
同じデータでも、問いの立て方でタスクが変わります。
実務では、扱いやすさから分類に落とし込むことがよくあります。正確な数値より、閾値を超えるかどうかだけ分かればよい場面は多いためです。
分類の細分類
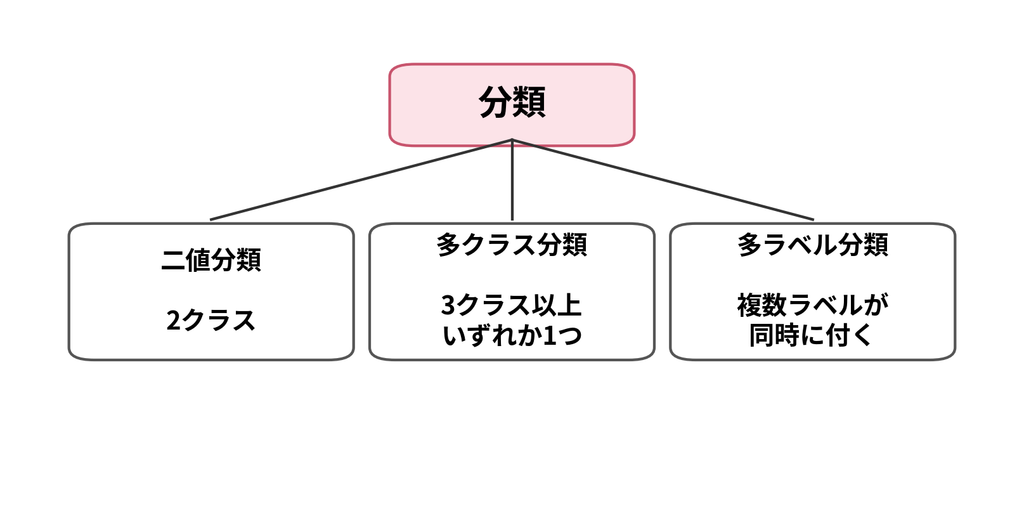
多クラスと多ラベルの違いは、質問されやすい点です。
手書き数字の認識は多クラスです。0から9のいずれか一つに決まります。
画像に写っているものを列挙するのは多ラベルです。「犬」と「屋外」と「芝生」が同時に成り立ちます。
主なアルゴリズム
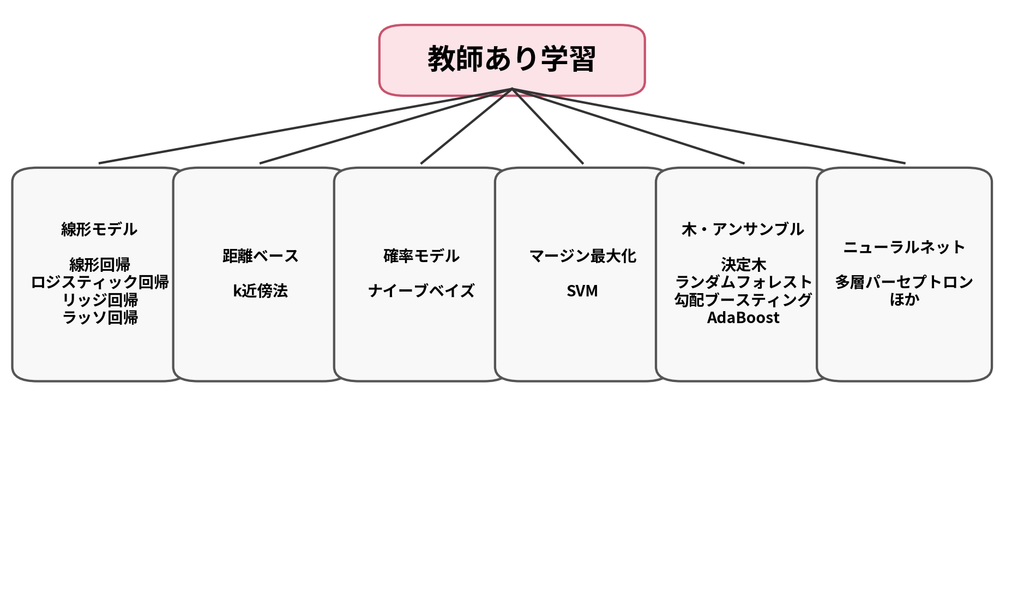
名前の落とし穴
ロジスティック回帰は、名前に回帰とありますが分類の手法です。
理由は、内部で確率という連続値を予測しているためです。その確率に閾値を設けて、クラスを決めます。
初学者が必ず引っかかる点なので、講師は先回りして説明してください。
確認問題3
次のタスクが回帰と分類のどちらか答えてください。
(1) 明日の最高気温を予測する
(2) 明日が真夏日になるかを予測する
(3) 商品レビューを5段階で評価する
(4) 機械の故障までの残り時間を予測する
解答を示します。
(1) 回帰です。連続値を予測しています。
(2) 分類です。真夏日かどうかの二値です。
(3) 判断が分かれます。5つのクラスへの多クラス分類として扱うこともできますし、順序があるため回帰として扱うこともあります。順序を考慮する順序回帰という手法もあります。
(4) 回帰です。時間という連続値を予測しています。
補足します。(3)のように、どちらとも扱える場合があります。
分類として扱うと、1と5の間違いも1と2の間違いも同じ扱いになります。回帰として扱えば、離れた予測ほど大きく罰せられます。目的に応じて選んでください。
確認問題4
ロジスティック回帰は回帰と分類のどちらに分類されますか。名前との関係も含めて説明してください。
解答を示します。
分類の手法です。
名前に回帰とあるのは、内部でクラスに属する確率という連続値を推定しているためです。その確率に閾値(通常0.5)を適用して、クラスを決定します。
補足します。歴史的な経緯もあります。
もともと統計学の回帰分析の枠組みから発展した手法であり、その名残です。名前から機能を推測すると誤るという典型例として、研修で紹介すると印象に残ります。
4 教師なし学習の系統
正解のないデータから構造を見つけます。
四つの用途
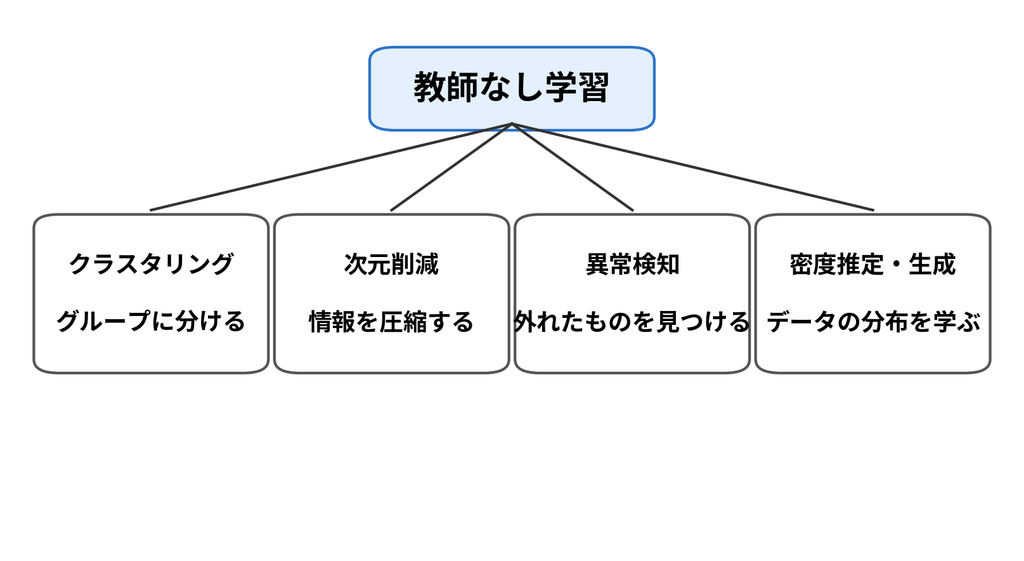
クラスタリング
似たものをまとめる処理です。
| 手法 | 特徴 |
|---|---|
| k平均法 | クラスタ数を指定する。最も基本的 |
| 階層的クラスタリング | 樹形図で関係を可視化できる |
| DBSCAN | 密度に基づく。クラスタ数の指定が不要 |
| 混合ガウスモデル | 確率分布の重ね合わせとして扱う |
k平均法は、クラスタ数を人間が決める必要があります。いくつに分けるべきかは、データを見ただけでは分かりません。
エルボー法やシルエット分析といった目安はありますが、最終的には目的次第です。
次元削減
特徴量が多すぎると、扱いが難しくなります。これを次元の呪いといいます。
| 手法 | 特徴 |
|---|---|
| 主成分分析(PCA) | 分散が大きい方向に射影する |
| 特異値分解(SVD) | 行列を分解する。PCAの基礎 |
| t-SNE | 可視化向け。局所構造を保つ |
| UMAP | t-SNEより高速。大域構造も保ちやすい |
| オートエンコーダ | ニューラルネットワークによる圧縮 |
t-SNEとUMAPは、高次元データを2次元に落として図示する用途で使われます。分析の前に、データの様子を目で見るための道具です。
ただし、これらの手法で得られた図は、距離の解釈に注意が必要です。近くに描かれた点が本当に似ているとは限りません。
異常検知
正常なデータを大量に学習し、そこから外れたものを検出します。
製造ラインの不良品検出、不正取引の検知、設備の故障予兆といった用途があります。
異常データは、そもそも数が少ないという問題があります。教師あり学習として扱うには、正解例が足りません。だから教師なしの枠組みが使われます。
確認問題5
異常検知に教師なし学習が使われることが多い理由を説明してください。
解答を示します。
異常データは発生頻度が低く、学習に十分な数を集められないためです。
教師あり学習で分類問題として扱うには、異常の例を多数用意する必要があります。しかし、不良品や不正取引は稀にしか起きません。
そこで、豊富に存在する正常データだけを学習し、そこから外れたものを異常とみなす方法が取られます。
補足します。もう一つ理由があります。
未知の異常に対応できるという点です。教師あり学習では、学習時に見た異常パターンしか検出できません。正常の範囲を学んでおけば、見たことのない異常も検出できます。
5 強化学習の系統
三つ目の大きな枝です。
何が違うのか
教師あり学習では、各データに正解が付いています。
強化学習では、正解は与えられません。行動した結果として、報酬という形の評価が返ってくるだけです。
しかも、報酬はすぐに返るとは限りません。囲碁なら、勝敗が分かるのは対局の終わりです。途中の一手が良かったのか悪かったのかは、直接には分かりません。
これを遅延報酬といいます。強化学習の難しさの中心にあります。
構成要素
| 要素 | 意味 |
|---|---|
| エージェント | 行動する主体 |
| 環境 | エージェントが働きかける対象 |
| 状態 | 現在の状況 |
| 行動 | エージェントが取る選択 |
| 報酬 | 行動の結果として得られる評価 |
| 方策 | どの状態でどう行動するかの規則 |
分類
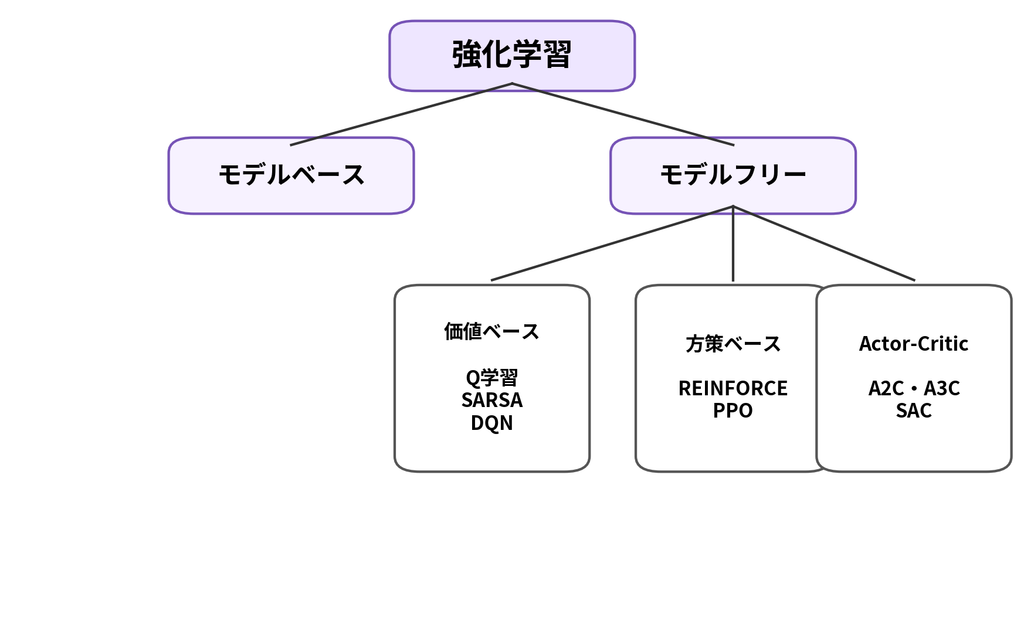
価値ベースは、各行動の価値を見積もり、価値の高い行動を選びます。
方策ベースは、行動を選ぶ規則そのものを直接学習します。
Actor-Criticは両者の組み合わせです。行動する側と評価する側を分けて持ちます。
探索と活用のジレンマ
強化学習の中心的な課題です。
これまでの経験で最も良かった行動を取り続けるべきか。それとも、まだ試していない行動を試すべきか。
前者を活用、後者を探索といいます。
活用だけでは、より良い方法を見逃します。探索だけでは、いつまでも成果が出ません。
飲食店選びに似ています。いつもの店に行けば外れませんが、新しい店を試さなければ、もっと良い店には出会えません。
生成AIとの接点
強化学習は、大規模言語モデルの学習にも使われています。
人間の好みを反映させる手法として、人間のフィードバックによる強化学習が知られています。モデルの出力に人間が評価を与え、それを報酬として学習を進めます。
強化学習をゲームやロボットの話だと思っている受講者が多いのですが、現在の生成AIの中核にも関わっています。
確認問題6
強化学習における探索と活用のジレンマを説明し、日常の例を挙げてください。
解答を示します。
活用とは、これまでの経験で最も良いと分かっている行動を選ぶことです。
探索とは、まだ試していない行動を選び、新しい情報を得ることです。
活用に偏れば、より良い選択肢を見逃します。探索に偏れば、良いと分かっている選択を活かせません。この両立が課題となります。
日常の例として、飲食店選びが挙げられます。行きつけの店に行けば満足が保証されますが、新しい店を試さなければ、より良い店を見つけられません。
補足します。この課題への対処として、最初は探索の割合を高くし、経験が蓄積されるにつれて活用の割合を高める方法があります。
一定の確率でランダムな行動を選ぶ手法を、イプシロングリーディ法といいます。
6 自己教師あり学習
近年、最も重要性が高まっている枝です。
位置づけ
教師なし学習の一種として扱われることも、独立した分類として扱われることもあります。
正解ラベルは人間が付けません。しかし、データ自身から正解を作り出します。
具体例
文章の一部を隠して、そこに入る語を当てさせる。これが代表的な方法です。
「今日は良い天気なので[ ]に行きます」
隠した語は、元のデータに含まれています。人間がラベル付けしなくても、正解が用意できます。
画像でも同様の手法があります。一部を隠して復元させる、回転させて角度を当てさせる、といった方法です。
なぜ重要になったのか
理由は、データの量です。
人手でラベルを付けたデータは、どれだけ頑張っても限りがあります。数百万件が限界でしょう。
自己教師あり学習なら、インターネット上の膨大なテキストをそのまま使えます。ラベル付けの工程が不要だからです。
大規模言語モデルが成立したのは、この仕組みがあったからです。
基盤モデルへの接続
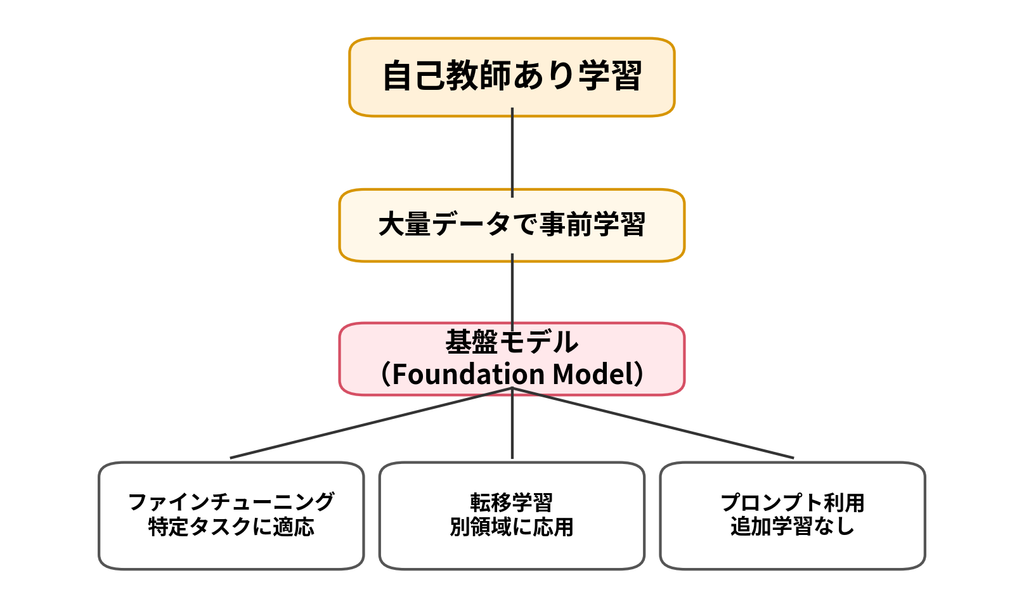
一度大きなモデルを作り、それを用途ごとに調整する。この流れが現在の主流です。
以前は、タスクごとにモデルを一から作っていました。現在は、既存の基盤モデルを出発点にします。
確認問題7
自己教師あり学習が、大規模言語モデルの成立に不可欠だった理由を説明してください。
解答を示します。
人手によるラベル付けを必要とせず、大量のテキストをそのまま学習に使えるためです。
教師あり学習では、学習データの量がラベル付けの工数に制約されます。数億件規模のデータに人手でラベルを付けることは現実的ではありません。
自己教師あり学習では、文章の一部を隠して当てさせるといった方法により、データ自身から正解を生成できます。したがって、インターネット上の膨大なテキストを学習に利用できます。
補足します。この仕組みにより、学習データの量が数桁増えました。
モデルの性能がデータ量とパラメータ数に応じて向上するという経験則が知られており、データ量の制約が外れたことが、現在の性能につながっています。
7 アンサンブル学習
分類軸を変えて、複数のモデルを組み合わせる手法群を見ます。
考え方
一つの優れたモデルを作るより、平凡なモデルを多数組み合わせるほうが良い結果になることがあります。
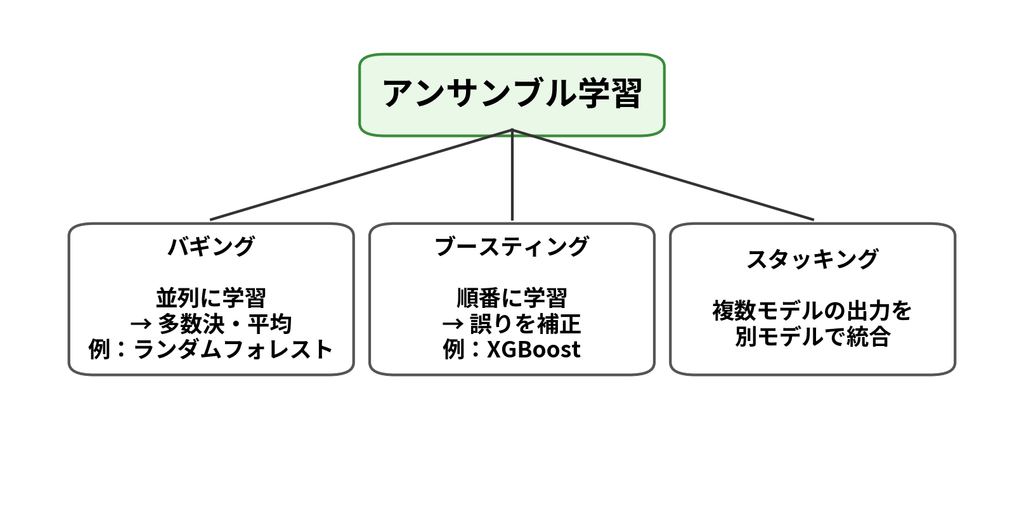
三つの方式
バギング
データを重複ありで抽出し、複数のモデルを独立に学習させます。最後に多数決や平均を取ります。
代表例はランダムフォレストです。決定木を多数作り、その結果をまとめます。
並列に学習できるため、計算を分散しやすいという利点があります。
ブースティング
前のモデルが間違えたデータを重視して、次のモデルを学習させます。順番に積み上げていく方式です。
代表例は勾配ブースティングです。XGBoost、LightGBM、CatBoostといった実装が広く使われています。
表形式のデータでは、現在でもディープラーニングより高い性能を示すことが少なくありません。
違いの比喩
バギングは、独立した複数の専門家に意見を聞いて多数決を取る方式です。
ブースティングは、一人目が解けなかった問題を二人目が重点的に解き、それでも解けない問題を三人目が扱う、という方式です。
確認問題8
バギングとブースティングの違いを、学習の進め方の観点から説明してください。
解答を示します。
バギングは、複数のモデルを独立に並列で学習させ、結果を多数決や平均で統合します。モデル同士に依存関係がありません。
ブースティングは、前のモデルの誤りを次のモデルが補正するよう、順番に学習させます。前のモデルの結果に依存するため、並列化が困難です。
補足します。性質にも違いが出ます。
バギングはばらつきを減らす効果が大きく、ブースティングは偏りを減らす効果が大きいとされます。
この違いは、バイアスとバリアンスという枠組みで説明されます。研修で扱う場合は、この概念を先に説明しておくと理解が進みます。
8 ディープラーニングの系統
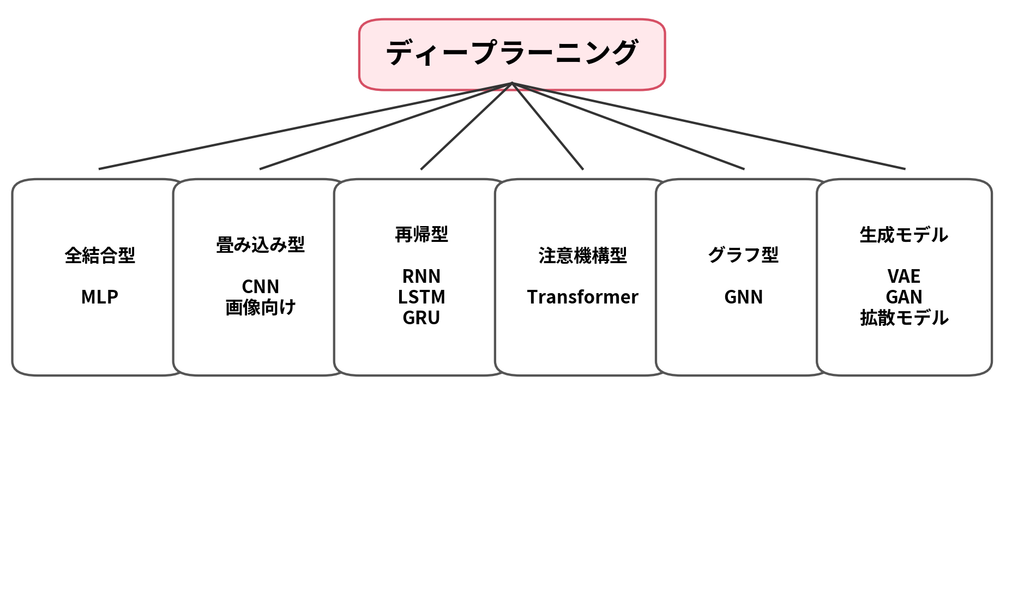
ニューラルネットワークの内部を細分化します。
構造による分類
それぞれの得意分野
| 構造 | 前提とする性質 | 主な用途 |
|---|---|---|
| CNN | 局所的なパターンが重要 | 画像認識 |
| RNN系 | 順序に意味がある | 音声、時系列 |
| Transformer | 離れた要素間の関係が重要 | 言語、そして画像も |
| GNN | 要素間の接続関係が重要 | 分子構造、SNS分析 |
構造の違いは、データのどんな性質を前提にするかの違いです。
CNNは、画像において近くの画素が関係し合うという前提を組み込んでいます。だから画像に強いのです。
Transformerへの収束
近年の大きな流れとして、Transformerがあらゆる領域に広がっています。
もともと機械翻訳のために提案された構造ですが、現在は画像認識にも使われています。画像を小さな区画に分割し、系列として扱う方法です。
領域ごとに異なる構造を使う時代から、一つの構造で統一する時代へ。この変化は押さえておく価値があります。
生成モデルの変遷
画像生成の分野では、主流が入れ替わってきました。
| 時期 | 主流 | 特徴 |
|---|---|---|
| 2014年頃から | GAN | 生成器と識別器を競わせる |
| 2013年頃から | VAE | 確率分布として潜在空間を学ぶ |
| 2020年代 | 拡散モデル | ノイズを加えて除去する過程を学ぶ |
現在の画像生成AIの多くは、拡散モデルを基礎にしています。
学習が安定しており、品質が高いことが理由です。GANは学習が不安定になりやすいという課題がありました。
確認問題9
CNNが画像処理に適している理由を、構造の観点から説明してください。
解答を示します。
CNNは、画像の局所的な領域に対してフィルタを適用する構造を持っています。近接する画素が関連し合うという画像の性質を、構造として組み込んでいます。
また、同じフィルタを画像全体で使い回すため、対象の位置が変わっても同じ特徴を検出できます。パラメータ数も抑えられます。
補足します。全結合型のネットワークで画像を扱うと、問題が生じます。
画素間の位置関係が失われ、パラメータ数が膨大になります。構造に前提を組み込むことの効果が、ここに現れています。
確認問題10
系統図上で、Transformerはどの枝に属しますか。また、当初の用途と現在の用途の違いを述べてください。
解答を示します。
ディープラーニングの中の、注意機構を用いる構造に属します。学習の仕方という軸で見れば、大規模言語モデルの事前学習では自己教師あり学習が使われます。
当初は機械翻訳のために提案された構造でしたが、現在は言語処理全般に加え、画像認識、音声処理など幅広い領域で使われています。
補足します。この問いは、系統図が排他的でないことを示す例でもあります。
Transformerという構造は、教師あり学習でも自己教師あり学習でも使えます。構造による分類と、学習の仕方による分類は、別の軸です。
9 系統図の読み方
最後に、注意点を整理します。
注意1 枝は排他ではない
ニューラルネットワークは、教師あり学習にも教師なし学習にも使えます。
オートエンコーダは教師なし学習ですが、ニューラルネットワークです。DQNは強化学習ですが、ニューラルネットワークを使っています。
系統図を厳密な階層だと思うと、混乱します。
注意2 軸が複数ある
同じ手法でも、どの軸で見るかで位置が変わります。
| 軸 | 分類の例 |
|---|---|
| 学習の仕方 | 教師あり、教師なし、強化学習 |
| 解くタスク | 回帰、分類、クラスタリング、生成 |
| モデルの構造 | 線形、木、ニューラルネットワーク |
| 出力の性質 | 識別モデル、生成モデル |
研修では、まず「学習の仕方」の軸だけを教えることをおすすめします。複数の軸を同時に示すと、初学者は混乱します。
注意3 図は簡略化されている
書籍やWebで見る系統図は、いずれも簡略化されています。
網羅的な図を作ろうとすると、複雑すぎて読めなくなります。目的に応じて枝を刈り込んだものが提示されています。
したがって、複数の系統図を見比べると内容が違います。どれが正しいという話ではありません。
図解の作り方
研修資料として系統図を作る場合、次の方針をおすすめします。
| 方針 | 理由 |
|---|---|
| 階層は3段まで | それ以上は読めない |
| 一枚に一つの軸 | 複数の軸を混ぜない |
| 例を1つずつ添える | 抽象的な名前だけでは残らない |
| 色分けは3色まで | 色が増えると意味が失われる |
そして、最初に見せる一枚は、教師あり、教師なし、強化学習の三分岐だけで構いません。細部は、学習が進んでから足していきます。
確認問題11
「ニューラルネットワークは教師あり学習に属する」という説明の問題点を指摘してください。
解答を示します。
ニューラルネットワークは、学習の仕方による分類ではなく、モデルの構造による分類です。軸が異なります。
実際、ニューラルネットワークは教師あり学習にも使われますし、オートエンコーダのように教師なし学習にも使われます。強化学習でも用いられます。
補足します。この種の混同は、研修で頻繁に起こります。
「Aは何に属しますか」という質問に答える前に、「どの軸で見るか」を確認する習慣をつけてください。
10 研修での教え方
このテーマを扱う場合の設計です。
60分の構成
| 時間 | 内容 | 形式 |
|---|---|---|
| 5分 | AIと機械学習の包含関係 | 講義 |
| 10分 | 学習の仕方による三分類 | 講義と図解 |
| 10分 | 演習。事例をどの枝に分類するか | グループ |
| 10分 | 教師あり学習の細分化 | 講義 |
| 10分 | 教師なし学習と強化学習 | 講義 |
| 10分 | 自己教師あり学習と現在の潮流 | 講義 |
| 5分 | まとめと質疑 | 全体 |
演習の設計例
事例カードを用意し、どの枝に属するかを分類させる演習が有効です。
| 事例 | 正解 |
|---|---|
| 過去の販売実績から来月の売上を予測する | 教師あり学習(回帰) |
| 顧客を購買傾向でグループ分けする | 教師なし学習(クラスタリング) |
| 製品写真から不良品を判定する | 教師あり学習(分類) |
| ロボットに歩行を習得させる | 強化学習 |
| 大量の文章から言語モデルを作る | 自己教師あり学習 |
| センサーデータから異常な挙動を検出する | 教師なし学習(異常検知) |
グループで議論させると、判断の難しい事例で意見が割れます。そこが学びの場です。
「製品写真から不良品を判定する」は、不良品のラベルがあれば教師あり学習ですが、正常品しかなければ異常検知になります。この揺れを議論させてください。
つまずきやすい点
三つあります。
一つ目は、軸の混同です。前節で述べた通りです。
二つ目は、ロジスティック回帰の名前です。必ず先回りして説明してください。
三つ目は、用語の多さそのものです。
一度にすべてを覚えさせようとしないでください。最初の研修では、三分類と、各枝の代表例を一つずつ。これで十分です。
講師が用意しておく補足
受講者から出やすい質問を挙げます。
「ディープラーニングと機械学習はどちらが優れているのですか」
回答としては、優劣ではなく適材適所だと伝えてください。表形式のデータでは、勾配ブースティングのほうが高い性能を示すことが珍しくありません。データ量が少ない場合も、単純な手法が有利です。
「今から学ぶなら何から手を付けるべきですか」
回答としては、線形回帰とロジスティック回帰をおすすめします。仕組みが単純で、他の手法の基礎になっているためです。いきなり深層学習に入ると、基礎の理解が抜けます。
まとめと次の学習ステップ
機械学習の系統図は、一つではありません。
学習の仕方で分けるのか、解くタスクで分けるのか、モデルの構造で分けるのか。軸によって図の形が変わります。この点を最初に押さえておけば、複数の図を見比べても混乱しません。
最も基本となるのは、学習の仕方による分類です。教師あり学習、教師なし学習、強化学習。そして近年は、自己教師あり学習が独立した枝として重要性を増しています。
この枝の選択は、理論的な好みではなく、手元のデータで決まります。ラベルがあるなら教師あり、ないなら教師なし、行動の結果として評価が返るなら強化学習。実務では、この順序で考えます。
そして、枝は排他ではありません。ニューラルネットワークという構造は、どの学習方法でも使えます。系統図は理解を助ける整理の道具であって、絶対的な区分ではないことを忘れないでください。
次の学習ステップとして、三つを提案します。
一つ目は、各枝の代表的な手法を一つずつ実装してみることです。線形回帰、k平均法、決定木。scikit-learnを使えば、いずれも数行で動かせます。動かしてみると、分類の意味が体感できます。
二つ目は、自分の業務データがどの枝に当てはまるかを考えることです。手元にあるデータには、ラベルが付いているでしょうか。何を予測したいのでしょうか。ここを整理すると、学ぶべき方向が定まります。
三つ目は、系統図を自分で描いてみることです。この記事の図をそのまま写すのではなく、自分が扱う領域に合わせて枝を刈り込んでください。描けるということは、理解しているということです。
土台となる地図ができれば、新しい手法が出てきても「あの枝の話だな」と位置づけられるようになります。
セイ・コンサルティング・グループでは新人エンジニア研修のアシスタント講師を募集しています。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。

