
機械学習における勾配降下法の最適化手法と系統図の完全解説
 山崎講師
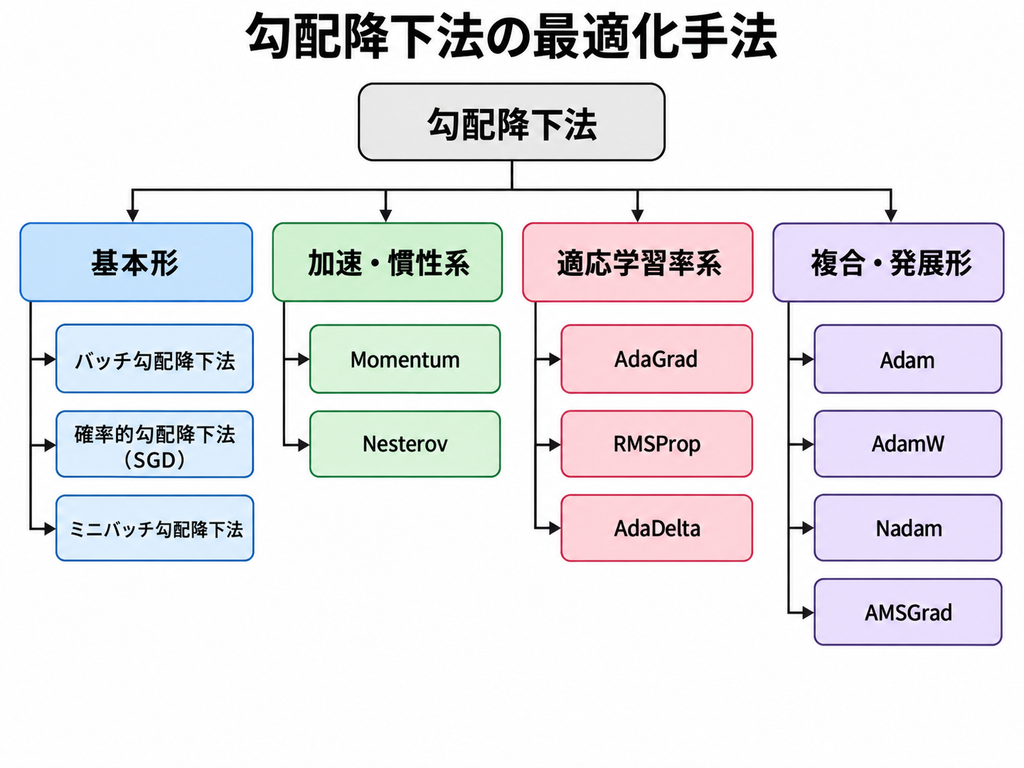
こんにちは。ゆうせいです。
機械学習や深層学習において、モデルの予測精度を高めるためには、パラメータの調整作業が欠かせません。この調整を担う中核のアルゴリズムが勾配降下法です。勾配降下法には、計算効率や収束速度を改善するために開発された多様な発展型が存在します。本記事では、上記の系統図に基づき、勾配降下法の4つの系統とそれぞれの具体的な手法について解説します。
勾配降下法とは
勾配降下法は、モデルの予測と実際の正解とのズレを表す損失関数の値を最小化する手法です。霧が立ち込める山の中で、地面の傾斜だけを頼りに最も標高が低い谷底を目指して一歩ずつ歩みを進める作業に例えられます。この歩幅の大きさを学習率、進む方向の決定に傾き(勾配)を用います。
勾配降下法は、データの扱い方や歩みの進め方によって大きく4つの系統に分類されます。
1. 基本形
基本形は、1回のパラメータ更新にどの程度のデータ量を使用するかによって分類されます。
バッチ勾配降下法: Batch Gradient Descent (BGD)
用意されたすべての学習データを一度に確認してから、傾きを計算してパラメータを更新します。
- メリット:全体の傾向を正確に把握して更新するため、谷底へ向かう進路が安定します。
- デメリット:データ量が膨大になると、1回の更新にかかる計算時間とメモリ消費量が大きくなります。
確率的勾配降下法: Stochastic Gradient Descent(SGD)
データ全体からランダムに1つのデータを選び出し、その都度パラメータを更新します。
- メリット:計算量が非常に小さく、素早く更新を繰り返すことができます。途中の小さなくぼみ(局所解)に捕まりにくい性質を持ちます。
- デメリット:1つのデータに左右されるため更新の方向が激しく蛇行し、安定して収束させる調整が難しくなります。
ミニバッチ勾配降下法: Mini-batch Gradient Descent
データを数十から数百個程度の小さなグループ(ミニバッチ)に分割し、グループごとに更新を行います。
- メリット:計算の効率性と進路の安定性を両立しており、GPUによる並列計算を最大限に活用できます。
- デメリット:グループの大きさ(バッチサイズ)を事前に決める調整作業が必要になります。
2. 加速・慣性系
過去に進んできた勢い(慣性)を考慮することで、谷底への到達速度を上げる系統です。
Momentum
物理の慣性の法則を取り入れた手法です。ボールが坂を転がり落ちるときのように、同じ方向への移動が続くと加速し、谷底へ素早く向かいます。
- メリット:平坦な場所や細長い谷筋でも勢いを保って進むことができ、振動を抑えて収束を早めます。
- デメリット:勢いがつきすぎると、目的の谷底を通り過ぎてしまう(オーバーシュートする)場合があります。
Nesterov(ネステロフの加速勾配法): Nesterov Accelerated Gradient (NAG)
慣性によって進む予定の未来の地点における傾きを先回りして計算し、進路を修正する手法です。ブレーキをかけながらカーブに進入する車に例えられます。
- メリット:勢い余って行き過ぎる現象を抑制し、Momentumよりも無駄のない効率的な移動が可能です。
- デメリット:数式の計算ステップがMomentumよりも複雑になります。
3. 適応学習率系
パラメータごとに更新の歩幅(学習率)を自動で調整する系統です。よく動くパラメータは歩幅を小さく、あまり動かないパラメータは歩幅を大きく調整します。
AdaGrad: Adaptive Gradient Algorithm
過去に計算された傾きの二乗をすべて足し合わせ、累積値が大きいパラメータほど歩幅を小さくします。
- メリット:パラメータの出現頻度に応じた適切な歩幅が自動的に設定されます。
- デメリット:更新回数が増えるにつれて分母が累積し続け、最終的に歩幅が0に近づいて学習が停止します。
RMSprop: Root Mean Square Propagation
AdaGradの欠点を解消するため、過去の傾きを単純に足し合わせるのではなく、直近の傾きを重視して指数関数的に割り引く移動平均を採用した手法です。
- メリット:歩幅が極端に小さくなって途中で止まる問題を回避し、継続して学習を進められます。
- デメリット:学習率自体の初期設定値に対して結果が左右されやすい傾向があります。
AdaDelta: Adaptive Delta
RMSpropと同様に過去の情報を制限しつつ、パラメータの単位(次元)の整合性を保つよう改良を加えた手法です。
- メリット:学習率というハイパーパラメータを人間が手動で設定する必要がほぼなくなります。
- デメリット:計算の手順が増加し、アルゴリズムの挙動把握が難しくなります。
4. 複合・発展形
慣性による加速(Momentum)と、状況に応じた歩幅調整(RMSpropなど)の長所を組み合わせた系統です。
Adam: Adaptive Moment Estimation
Momentumの勢いとRMSpropの適応的な歩幅調整を融合させた手法です。現在の深層学習において標準的に広く採用されています。
- メリット:多様な問題に対してパラメータ調整を行わなくても安定した性能を発揮します。
- デメリット:学習の終盤において、過去の情報の影響で予期せぬ挙動を示し、最適な値に収束しきらないケースが報告されています。
AdamW: Adaptive Moment Estimation with Weight Decay
Adamにおける重み減衰(モデルの複雑さを抑える正則化処理)の計算方法を数理的に修正した手法です。
- メリット:本来の正則化効果が正確に発揮され、未知のデータに対する予測性能(汎化性能)が向上します。
- デメリット:重み減衰の係数を適切に探索・設定する手間が生じます。
Nadam: Nesterov-accelerated Adaptive Moment Estimation
AdamにNesterovの先回りする加速手法を組み込んだアルゴリズムです。
- メリット:Adamよりも素早く谷底の方向へ進路を修正し、収束速度を向上させます。
- デメリット:計算処理が増加し、モデルの構造によっては過学習を引き起こす可能性があります。
AMSGrad
Adamの理論的な欠点である「過去の大きな傾きが忘れられて歩幅が不適切に広がる現象」を防ぐため、過去の最大値を保持して歩幅を制御する手法です。
- メリット:理論上の収束性が保証され、Adamがうまく収束しない特殊な条件下でも安定します。
- デメリット:通常のデータセットではAdamとの性能差が現れにくく、収束が遅くなるケースもあります。
まとめ
勾配降下法の発展は、「いかに適切な方向へ加速するか」と「いかに適切な歩幅を維持するか」という2つの課題に対する改良の歴史です。
今後の学習ステップとして、まずはミニバッチ勾配降下法とSGDの基本動作をコードで実装し、パラメータ更新の流れを把握してください。次に、広く標準として用いられているAdamおよびAdamWを使用し、精度の推移を観察することをお勧めします。基盤となる仕組みを順を追って確認することで、扱う課題に応じた適切な最適化手法を選択できるようになります。
セイ・コンサルティング・グループでは新人エンジニア研修のアシスタント講師を募集しています。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。

