確率・統計の歴史を物語で学ぶ|賭けの問題からベイズ則、最尤推定、エントロピー、MAP推定、不確実性の定量化まで(E資格対応)
 山崎講師
こんにちは。ゆうせいです。
E資格の研修で確率・統計と情報理論を扱うと、ベルヌーイ分布、ベイズ則、最尤推定、MAP(Maximum A Posteriori:最大事後確率)推定、エントロピー、KL(Kullback-Leibler)ダイバージェンスと、数式を伴う用語が次々に登場します。受講者から「公式が多くて覚えられません」「最尤推定と MAP推定の違いが分かりません」と質問された経験のある講師の方は多いのではないでしょうか。
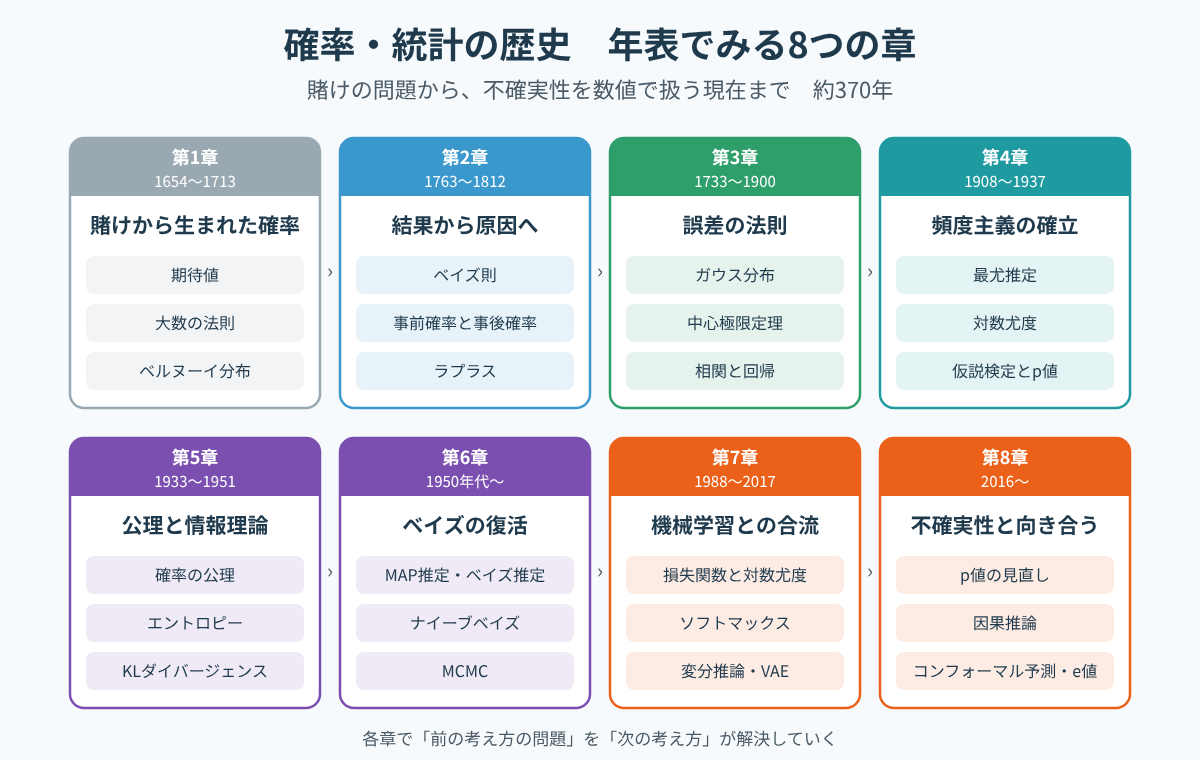
確率・統計の用語は、公式の一覧として覚えようとすると大変です。しかし、「前の考え方にどのような問題があり、次の考え方がどのように解決したか」という順番で並べると、1本の物語として理解できます。今回は、1654年の賭けの問題から2026年の不確実性の定量化まで、約370年の歴史を8つの章でたどります。各章には、E資格のポイント、数値例、確認の問いを付けました。
序章 確率と統計は逆向きの問い
確率と統計は、同じ道を逆向きに歩く学問です。
- 確率:仕組みが分かっているとき、どのようなデータが出るかを考える。例:公平なコインを10回投げると、表は何回くらい出るか
- 統計:データが手元にあるとき、背後の仕組みを推測する。例:10回投げて表が7回出た。このコインは公平と言えるか
箱の中身が分かっていて、取り出す玉を予想するのが確率です。取り出した玉を見て、箱の中身を推測するのが統計です。
機械学習は、統計の側に立っています。データを見て、モデルのパラメータ(重みなど)を推測するからです。そのため、機械学習の損失関数や正則化の多くは、確率・統計の言葉で説明できます。
E資格の出題範囲には、確率・統計と情報理論が含まれます。この記事で登場する主なキーワードは次のとおりです。出題範囲は改訂されることがあるため、受験の前に JDLA(Japan Deep Learning Association:日本ディープラーニング協会)の公式サイトで最新のシラバスを確認してください。
- 確率分布:ベルヌーイ分布、マルチヌーイ分布(カテゴリ分布)、ガウス分布
- 推定:ベイズ則、最尤推定、MAP推定、ベイズ推定、ナイーブベイズ
- 情報理論:自己情報量、エントロピー、交差エントロピー、KLダイバージェンス、JS(Jensen-Shannon)ダイバージェンス、相互情報量
第1章 賭けから生まれた確率(1654〜1713)
中断された賭けの分け方
物語は、賭けの相談から始まります。1654年、フランスの貴族シュバリエ・ド・メレが、数学者パスカルに次のような問題を持ち込みました。パスカルは、数学者フェルマーと手紙をやり取りしながら答えを探します。
2人が「先に3勝したほうが賞金をもらう」という勝負をしています。A が2勝、B が1勝した時点で、勝負を中断することになりました。賞金の金貨64枚を、どのように分ければ公平でしょうか。2人の強さは同じとします。
それまでの考え方は、「これまでの勝ち数の比(2対1)で分ける」というものでした。しかしこの方法では、A が1勝、B が0勝で中断した場合に、A がすべてを受け取ることになってしまいます。
パスカルとフェルマーは、「これまで」ではなく「これから」に注目しました。あと2回勝負をすれば、必ず決着が付きます。2回の勝負の結果は、次の4通りです。
- A が勝ち、A が勝つ:A の勝利
- A が勝ち、B が勝つ:A の勝利
- B が勝ち、A が勝つ:A の勝利
- B が勝ち、B が勝つ:B の勝利
4通りのうち3通りで A が勝つので、A が勝つ確率は 4分の3 です。賞金は、A が 64 × 4分の3 = 48枚、B が 16枚と分けるのが公平だと分かります。
「起こりうる場合を数え、確率で重みを付けて平均する」という考え方は、期待値と呼ばれます。1657年にオランダのホイヘンスが本にまとめました。

X は結果の値(確率変数)、x_i は i 番目の結果の値、P(x_i) はその結果が出る確率です。A の取り分の期待値は 64 × 0.75 + 0 × 0.25 = 48 です。サイコロの目の期待値なら、(1 + 2 + 3 + 4 + 5 + 6) ÷ 6 = 3.5 になります。
大数の法則とベルヌーイ分布
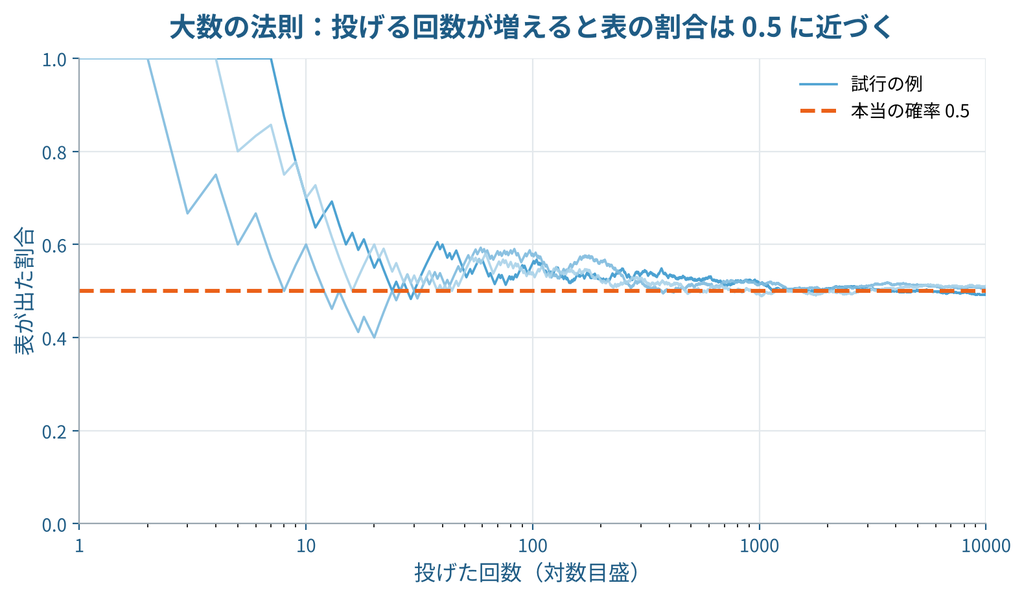
スイスの数学者ヤコブ・ベルヌーイは、「確率 4分の3」のような数は、現実の世界で何を意味するのかを考えました。1713年に出版された著書で示されたのが、大数の法則です。試行の回数を増やしていくと、ある結果が出た割合は、その結果の確率に近づいていきます。
コイン投げのように、結果が2通りしかない試行を表す分布は、ベルヌーイ分布と呼ばれます。

x は結果で、成功なら 1、失敗なら 0 です。μ(ミュー)は成功の確率です。μ が 0.7 のとき、x に 1 を入れると 0.7 の1乗 × 0.3 の0乗 = 0.7、x に 0 を入れると 0.7 の0乗 × 0.3 の1乗 = 0.3 になります。成功と失敗の2つの場合を、1つの式で書けるところがポイントです。この書き方は、第4章の最尤推定で役に立ちます。
E資格のポイント
- ベルヌーイ分布の式を、x に 1 と 0 を入れて確かめられるようにする
- ベルヌーイ分布の期待値は μ、分散は μ(1 - μ)。μ が 0.7 なら、分散は 0.7 × 0.3 = 0.21
残された問題
確率が分かっていれば、どのようなデータが出るかは計算できるようになりました。しかし、現実に知りたいのは逆の問いです。データを見て、確率を知りたいのです。ベルヌーイ自身も、「何回試せば、割合を確率とみなしてよいか」という問いに悩みました。
ここで確認
問い:同じ勝負で、A が2勝、B が0勝の時点で中断した場合、A の取り分は金貨何枚でしょうか。
答え:B が賞金を得るには、3回続けて勝つ必要があります。その確率は 2分の1 の3乗で 8分の1 です。A が勝つ確率は 8分の7 なので、A の取り分は 64 × 8分の7 = 56枚です。
第2章 結果から原因へ:ベイズとラプラス(1763〜1812)
逆向きの確率
「結果を見て、原因の確率を求める」という逆向きの問いに最初の答えを出したのが、イギリスの牧師トーマス・ベイズです。ベイズの論文は、本人の死後の1763年に、友人のリチャード・プライスの手で発表されました。フランスのラプラスも同じ考え方に独自にたどり着き、天文学や人口の推定に使える一般的な形に整えました。

この式がベイズ則(ベイズの定理)です。A を原因(仮説)、B を結果(データ)と読みます。
- P(A):事前確率。データを見る前の、原因 A の確率
- P(B | A):尤度(ゆうど)。原因が A のときに、結果 B が出る確率
- P(A | B):事後確率。結果 B を見た後の、原因 A の確率
- P(B):結果 B が出る確率の全体
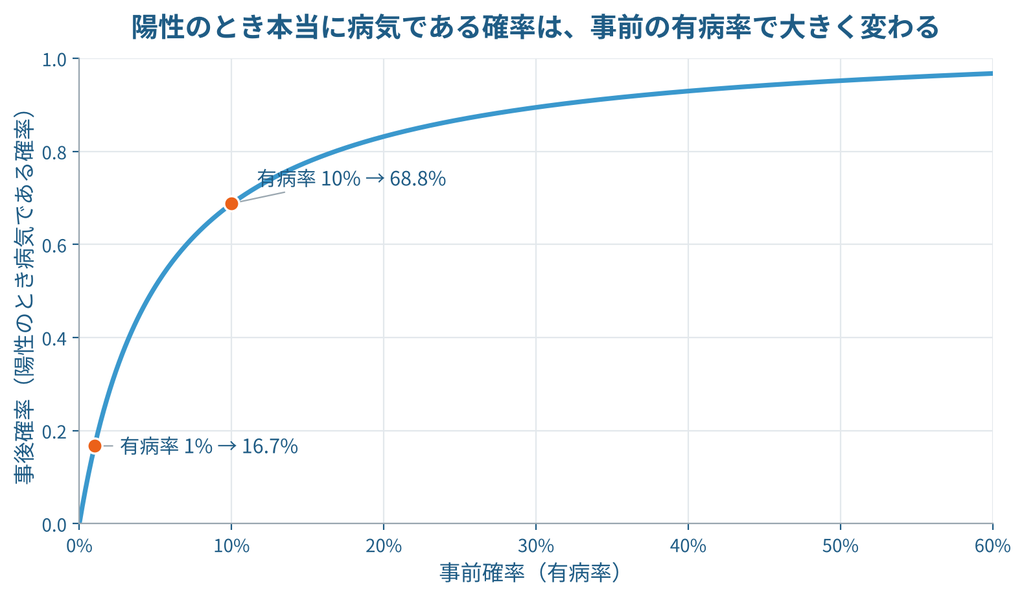
数値例で確かめましょう。ある病気にかかっている人は、全体の 1% です。検査は、病気の人の 99% を陽性と判定しますが、病気でない人の 5% も陽性と判定してしまいます。検査で陽性になった人が、本当に病気である確率はいくつでしょうか。
- 分子:0.99 × 0.01 = 0.0099
- 分母:病気で陽性 0.0099 + 病気でないのに陽性 0.05 × 0.99 = 0.0495 を足して 0.0594
- 事後確率:0.0099 ÷ 0.0594 = 約 0.167
答えは約 16.7% です。「99% 当たる検査で陽性」と聞くと、ほぼ確実に病気だと感じますが、実際の確率はずっと低くなります。1万人で考えると分かりやすくなります。病気の人は100人で、そのうち99人が陽性です。病気でない人は9900人で、そのうち495人が陽性です。陽性の合計594人のうち、本当に病気の人は99人だけです。
E資格のポイント
- ベイズ則の式と、事前確率・尤度・事後確率の対応を説明できるようにする
- 分母の P(B) は、「A のとき」と「A でないとき」を足し合わせて求める
残された問題
ベイズ則には、事前確率が必要です。手がかりが何もないとき、事前確率をどのように決めればよいのでしょうか。ラプラスは「すべての可能性を同じ確率とする」と考えましたが、その根拠は弱く、決め方によって結論が変わってしまいます。19世紀の後半から20世紀の前半にかけて、「結論が人の考えに左右される方法は科学にふさわしくない」という批判が強まり、ベイズの考え方は主流から外れていきました。
ここで確認
問い:上の例で、病気の人の割合が 10% だった場合、陽性の人が本当に病気である確率はいくつでしょうか。
答え:分子は 0.99 × 0.1 = 0.099、分母は 0.099 + 0.05 × 0.9 = 0.144 です。0.099 ÷ 0.144 = 約 0.688 で、約 68.8% になります。同じ検査でも、事前確率によって結論が大きく変わると分かります。
第3章 誤差の法則とガウス分布(1733〜1900)
測るたびに違う値をどう扱うか
第2章と同じ時代、天文学者たちは別の問題に悩んでいました。同じ星の位置を何度測っても、値が少しずつ違うのです。どの値を信じればよいのでしょうか。
1733年、ド・モアブルは、コイン投げの回数を増やしていくと、表の回数の分布が釣り鐘の形に近づくことを見つけました。1809年には、ドイツのガウスが、観測の誤差の分布として同じ釣り鐘型の曲線を導き、1805年にルジャンドルが発表していた最小二乗法と結び付けました。この分布が、ガウス分布(正規分布)です。

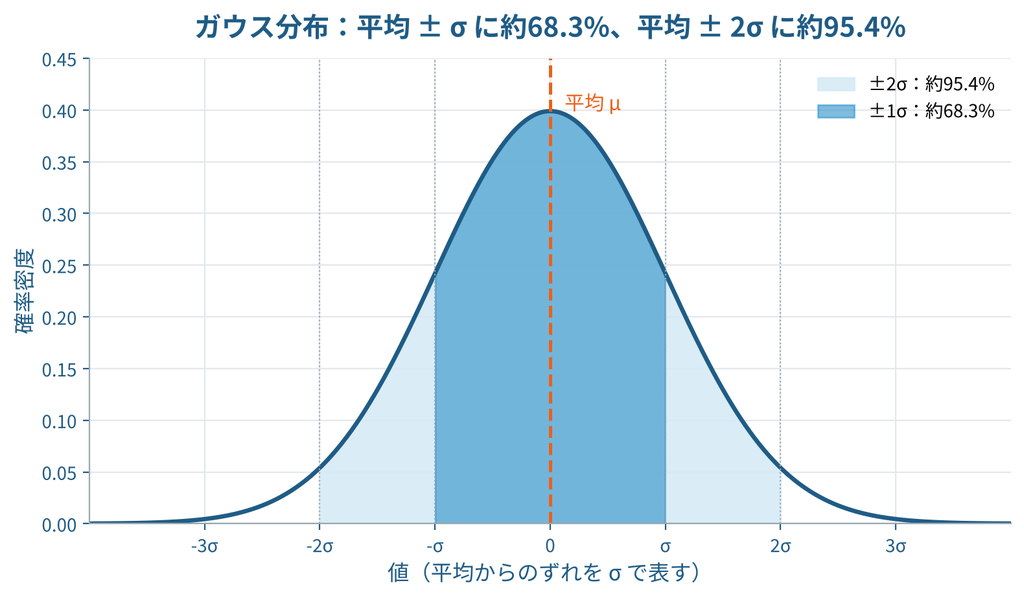
μ は平均(山の中心の位置)、σ(シグマ)は標準偏差(山の広がり)、σ の2乗は分散です。π は円周率、exp は e(約 2.718)の何乗かを表します。μ が 0、σ が 1 のとき、x が 0 での値は 1 ÷ (2π の平方根) = 約 0.399、x が 1 での値は約 0.242 です。平均から離れるほど値が小さくなります。データの約 68.3% が平均 ± σ の範囲に、約 95.4% が平均 ± 2σ の範囲に入ります。
なぜ誤差は釣り鐘型になるのでしょうか。1810年、ラプラスは中心極限定理を示しました。互いに独立な小さな要因をたくさん足し合わせると、もとの要因がどのような分布であっても、合計の分布はガウス分布に近づきます。観測の誤差は、空気の揺らぎ、機器のわずかな狂い、人の目の誤差など、多くの小さな要因の合計なので、ガウス分布に従うのです。
社会と生物への広がり
統計には、もう1つの源流があります。国や社会のデータです。1662年、ロンドンのジョン・グラントは、教会の死亡記録を集計して、人口や寿命の傾向を調べました。19世紀には、ベルギーのケトレーが、身長などの人間のデータにもガウス分布が現れることを示します。1880年代にはゴルトンが回帰と相関の考え方を生み、弟子のカール・ピアソンが相関係数を式にまとめ、1900年にはカイ二乗検定を発表しました。こうして統計学は、1つの学問として形を整えていきます。
E資格のポイント
- ガウス分布の式で、μ が中心の位置を、σ が広がりを決めることを押さえる
- ニューラルネットワークの重みの初期値やノイズに、ガウス分布がよく使われる理由の1つが中心極限定理である
残された問題
- 大量のデータが前提だった:当時の方法は、数百、数千のデータがあるときにだけ正しく使えました。数個から数十個の小さなデータでは、結論が当てになりません
- 推定の方法がばらばらだった:平均や分散を求める方法は場面ごとに考えられており、「どの方法が最もよいか」を決める共通の基準がありませんでした
ここで確認
問い:中心極限定理は、何が何に近づくことを述べた定理でしょうか。
答え:互いに独立な多数の確率変数の合計(または平均)の分布が、もとの分布の形によらず、ガウス分布に近づくことを述べた定理です。
コラム ド・モアブルは自分の死を予言したのか
第3章に登場したド・モアブルには、有名な逸話が伝えられています。晩年のド・モアブルは、毎日15分ずつ長く眠るようになったことに気づき、眠る時間が24時間に達する日を計算して、自分の死ぬ日を言い当てた、という話です。その日は1754年11月27日で、実際の命日と一致したとされます。
ただし、この逸話を裏付ける確かな資料は見つかっていません。数学史の研究では、後世に作られた話の可能性が高いとされています。仮に睡眠が延びていたとしても、亡くなる前の体調の変化としては珍しいことではなく、計算が当たったのは偶然の一致と考える方が自然です。
確率・統計を学ぶうえで、この逸話は良い練習問題になります。等差数列で睡眠時間を先へ延ばすという計算そのものはできますが、「本当にその通りに眠りが延び続けるのか」というデータの裏付けがなければ、予測は意味を持ちません。もっともらしい計算と、裏付けのある結論は違います。数字の裏にあるデータを問う姿勢を、受講者に伝える題材として使えます。
第4章 少ないデータから推定する:フィッシャーと頻度主義(1908〜1937)
ビール工場から生まれた t分布
少ないデータの問題に最初に取り組んだのは、ビール会社ギネスの技術者ウィリアム・ゴセットです。原料の品質を、少数のサンプルで判断する必要がありました。ゴセットは1908年、「スチューデント」というペンネームで、少ないデータでも使える t分布を発表します。
最尤推定:データが最も出やすい値を選ぶ
推定の共通の基準を作ったのが、イギリスの統計学者ロナルド・フィッシャーです。1922年の論文で、最尤(さいゆう)推定を体系化しました。考え方は、「手元のデータが最も出やすくなるパラメータを選ぶ」というものです。
コインを10回投げて、表が7回出たとします。表が出る確率を θ(シータ)とすると、このデータが出る確率は、第1章のベルヌーイ分布の式を10回分掛け合わせて求められます。θ の関数として見たとき、尤度と呼びます。

掛け算のままでは扱いにくいので、対数をとって足し算に直します。対数尤度と呼びます。

いくつかの θ で、対数尤度(自然対数)を計算してみましょう。
- θ が 0.5 のとき:10 × log 0.5 = 約 -6.931
- θ が 0.7 のとき:7 × log 0.7 + 3 × log 0.3 = 約 -6.109
- θ が 0.9 のとき:7 × log 0.9 + 3 × log 0.1 = 約 -7.645
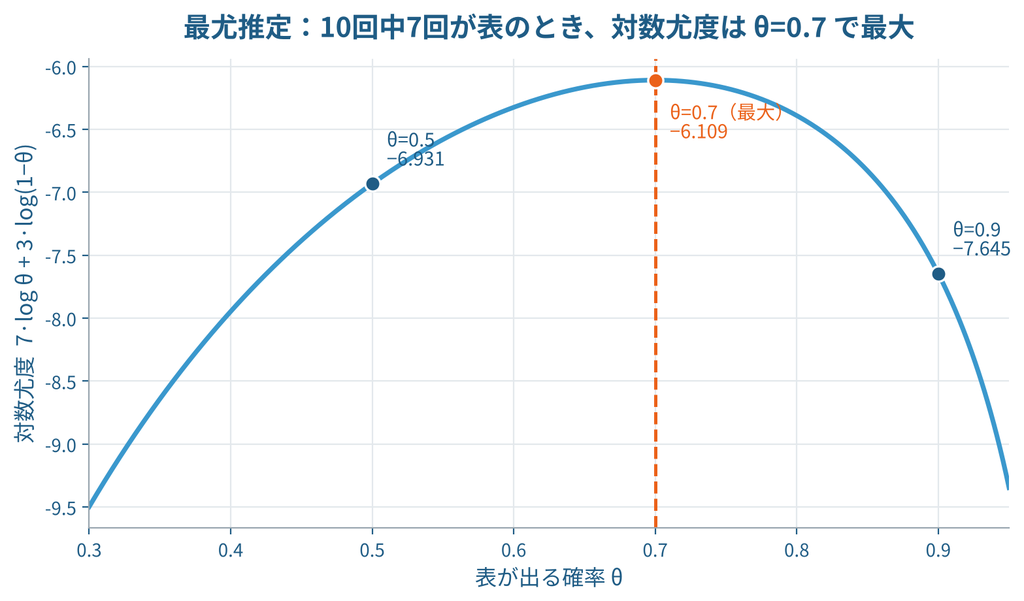
θ が 0.7 のときに最も大きくなります。対数尤度を θ で微分して 0 と置くと、7 ÷ θ - 3 ÷ (1 - θ) = 0 となり、θ = 0.7 が得られます。「表の回数 ÷ 投げた回数」という直感どおりの答えです。一般の形では、次のように書きます。

左辺は最尤推定で求めたパラメータ、arg max は「右の式を最大にする θ」という意味です。x_i は i 番目のデータ、n はデータの数です。
最小二乗法との再会
最尤推定は、第3章の最小二乗法ともつながります。「正解 = モデルの予測 + ガウス分布に従うノイズ」と仮定して対数尤度を書くと、ガウス分布の式の exp の中身、つまり「正解と予測の差の2乗」だけが残ります。対数尤度を最大にすることは、差の2乗の合計を最小にすることと同じになるのです。

この式が MSE(Mean Squared Error:平均二乗誤差)です。y_i は i 番目の正解、y に山形の記号が付いたものは予測です。正解が (3, 5, 7)、予測が (2, 5, 9) なら、(1 + 0 + 4) ÷ 3 = 約 1.667 です。回帰の損失関数に平均二乗誤差を使うことは、「ノイズがガウス分布に従う」と仮定して最尤推定をすることにあたります。
コラム なぜ対数をとるのか
最尤推定では、尤度をそのまま最大にするのではなく、対数をとった対数尤度を最大にします。受講者から「なぜわざわざ対数をとるのですか」と質問されたときは、3つの理由を伝えるとよいでしょう。
- 掛け算が足し算になる:データが独立なら、全体の尤度は1件ごとの確率の掛け算です。対数をとると足し算になり、微分が簡単になります
- 計算機で 0 になるのを防ぐ:0.5 を1000回掛けると、約 9.3 × 10 のマイナス302乗という非常に小さな値になります。データが増えると、計算機では 0 として扱われてしまいます。対数なら 1000 × log 0.5 = 約 -693.1 で、問題なく扱えます
- 最大になる位置は変わらない:対数は、もとの値が大きいほど大きくなる関数です。そのため、尤度が最大になる θ と、対数尤度が最大になる θ は同じです
機械学習では、対数尤度に -1 を掛けた「負の対数尤度」を損失関数として、最小にします。「尤度を最大にする」と「損失を最小にする」は、同じ計算を別の向きから見たものです。
問い:3件のデータの確率が 0.2、0.5、0.1 のとき、対数尤度(自然対数)はいくつでしょうか。
答え:log 0.2 + log 0.5 + log 0.1 = log (0.2 × 0.5 × 0.1) = log 0.01 = 約 -4.605 です。
仮説検定と p値
フィッシャーは、「データが偶然の範囲に収まっているか」を判断する方法も広めました。有意性検定です。1933年にはネイマンとエゴン・ピアソンが、2種類の誤りを考える仮説検定の枠組みを作り、1937年にはネイマンが信頼区間を発表しました。
検定で使う p値は、「帰無仮説(差がない、公平であるなどの仮説)が正しいとしたとき、観測された結果と同じか、それより極端な結果が出る確率」です。コインを10回投げて表が9回出たとします。公平なコインで、表が9回以上または1回以下になる確率は、1024分の22 = 約 0.021 です。0.05 より小さいので、「公平である」という仮説を捨てる、と判断します。
フィッシャーたちの立場は、頻度主義と呼ばれます。確率を「同じ試行を何度も繰り返したときに、その結果が出る割合」と考える立場です。パラメータは、未知ではあっても1つに決まった値とみなします。事前確率を使わないので、第2章で批判された主観の問題を避けられました。20世紀の科学は、頻度主義の方法を標準として発展します。
E資格のポイント
- 最尤推定は、対数尤度を最大にするパラメータを求める方法である
- ベルヌーイ分布の最尤推定値は「成功の回数 ÷ 試行の回数」、ガウス分布の平均の最尤推定値は「データの平均」になる
- 平均二乗誤差の最小化は、ガウス分布を仮定した最尤推定と同じである
残された問題
- 少ないデータで極端な値になる:コインを3回投げて3回とも表だった場合、最尤推定値は 3 ÷ 3 = 1.0 です。「裏は絶対に出ない」という結論になってしまいます。機械学習でいう過学習です
- p値が誤解されやすい:p値は「仮説が正しい確率」ではありません。それでも、0.05 を下回れば正しく、上回れば誤り、という白黒の判断に使われるようになりました
- パラメータの不確かさを直接表せない:「θ が 0.6 から 0.8 の間にある確率」のような問いには、頻度主義の枠組みでは答えられません
ここで確認
問い:コインを5回投げて、表が4回出ました。表が出る確率 θ の最尤推定値と、対数尤度の式を答えてください。
答え:最尤推定値は 4 ÷ 5 = 0.8 です。対数尤度は 4 × log θ + log (1 - θ) です。
第5章 確率の土台と情報の量(1933〜1951)
コルモゴロフの公理
ここまでの物語には、1つのあいまいさが残っていました。確率とは何か、という定義です。頻度主義は「繰り返したときの割合」、ベイズの立場は「確からしさの度合い」と考え、議論はかみ合いません。
1933年、ソ連の数学者コルモゴロフは、確率を3つの約束(公理)だけで定義しました。
- どの出来事の確率も 0 以上である
- 起こりうる出来事すべてを合わせた確率は 1 である
- 同時には起こらない出来事については、どれかが起こる確率は、それぞれの確率の足し算で求められる
確率の意味をどのように解釈するかに関係なく、この3つを満たすものを確率として扱えばよい、という整理です。条件付き確率、確率変数、期待値といった道具が、数学として厳密に使えるようになりました。
シャノンと情報の量
1948年、アメリカのクロード・シャノンは、通信の研究の中で、「情報の量」を確率で測る方法を発表しました。出発点は、「珍しい出来事ほど、知らせる価値が大きい」という考え方です。確率 P(x) の出来事が起きたと知ったときの情報の量を、自己情報量と呼びます。

確率が 2分の1 の出来事なら 1ビット、8分の1 なら 3ビットです。確率が 1 の出来事(必ず起こる出来事)は 0ビットで、知らされても新しい情報はありません。
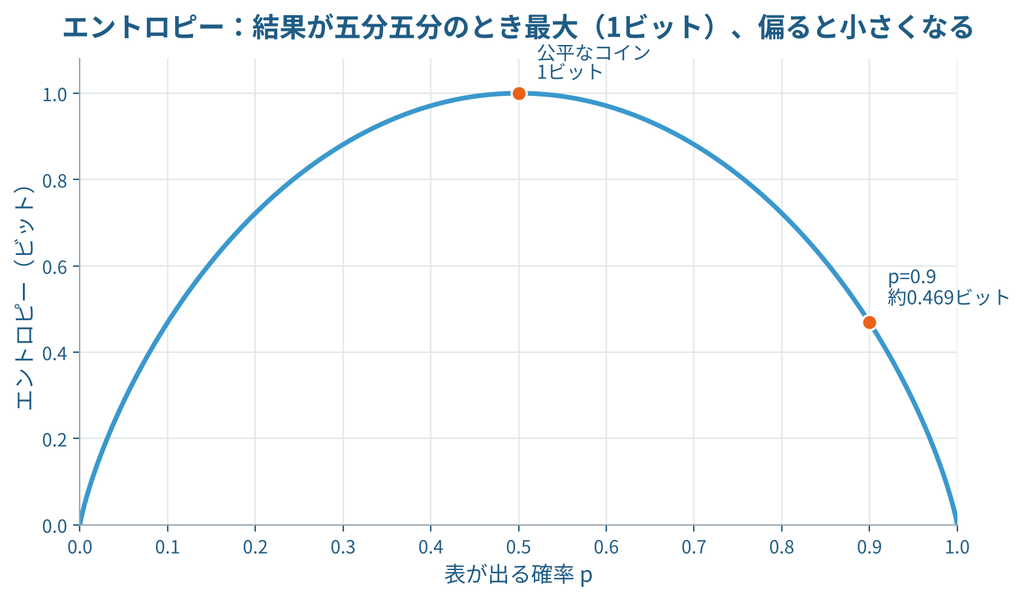
自己情報量の平均が、エントロピーです。結果の予測しにくさを表します。

P は確率分布、x は起こりうる結果です。公平なコインのエントロピーは 1ビットです。表が出る確率が 0.9 のコインでは、-(0.9 × log2 0.9 + 0.1 × log2 0.1) = 約 0.469ビットになります。結果がほぼ予想できるので、エントロピーは小さくなります。
2つの分布のずれを測る
情報理論は、「2つの確率分布がどれだけ違うか」を測る道具も生みました。1つ目は交差エントロピーです。

P は正解の分布、Q はモデルが予測した分布です。3クラスの分類で、正解が1番目のクラス、つまり P が (1, 0, 0) だとします。予測 Q が (0.7, 0.2, 0.1) なら、交差エントロピーは -log 0.7 = 約 0.357 です。予測が (0.1, 0.2, 0.7) なら、-log 0.1 = 約 2.303 に増えます。正解のクラスに高い確率を付けるほど、値は小さくなります。
2つ目は、1951年にカルバックとライブラーが発表した KLダイバージェンスです。

KLダイバージェンスは、交差エントロピー H(P, Q) からエントロピー H(P) を引いた値と同じです。P が (0.5, 0.5)、Q が (0.9, 0.1) のとき、0.5 × log (0.5 ÷ 0.9) + 0.5 × log (0.5 ÷ 0.1) = 約 0.511 です。次の3つの性質が重要です。
- 必ず 0 以上になる
- P と Q が同じ分布のときだけ 0 になる
- P と Q を入れ替えると値が変わる。上の例で入れ替えると約 0.368 になる。そのため「距離」とは呼べない
入れ替えても値が変わらないように工夫したものが、JSダイバージェンスです。

M は P と Q の平均の分布です。上の例では M が (0.7, 0.3) になり、0.5 × 0.087 + 0.5 × 0.116 = 約 0.102 です。P と Q を入れ替えても、同じ値になります。
最後に、相互情報量です。2つの確率変数が、どれだけ情報を共有しているかを表します。

右辺の2つ目は、Y を知った後に残る X のエントロピー(条件付きエントロピー)です。Y を知ることで X の予測しにくさがどれだけ減るか、を表しています。X と Y が独立なら、相互情報量は 0 です。
最尤推定とのつながり
情報理論は、第4章の最尤推定に新しい意味を与えました。負の対数尤度の平均は、「データの分布」と「モデルの分布」の交差エントロピーにあたります。データの分布のエントロピーはモデルを変えても変わらないので、交差エントロピーを最小にすることは、KLダイバージェンスを最小にすることと同じです。
つまり、最尤推定とは、「モデルの分布を、データの分布にできるだけ近づける作業」だと言えます。分類の損失関数に交差エントロピーが使われる理由も、ここにあります。
E資格のポイント
- 自己情報量、エントロピー、交差エントロピー、KLダイバージェンスの式を、小さな数値例で計算できるようにする
- KLダイバージェンスは 0 以上で、入れ替えると値が変わる。JSダイバージェンスは入れ替えても同じ値になる
- 対数の底が 2 なら単位はビット、底が e ならナットと呼ぶ
残された問題
情報理論は強力な道具を与えましたが、第4章の問題は残ったままでした。データが少ないときに最尤推定が極端な値になる問題と、パラメータの不確かさを表せない問題です。
ここで確認
問い:4つの結果が同じ確率で起こるとき、エントロピーは何ビットでしょうか。
答え:それぞれの確率は 4分の1 で、自己情報量は 2ビットです。平均も 2ビットなので、エントロピーは 2ビットです。4つの結果を区別するには、0 と 1 の2桁が必要であることに対応しています。
第6章 ベイズの復活と計算の力(1950年代〜1990年代)
事前分布で極端な推定を防ぐ
20世紀の中ごろ、ジェフリーズやサベージらが、確率を「確からしさの度合い」として一貫して扱う理論を整え、ベイズの考え方が見直され始めました。ベイズ統計では、パラメータ θ そのものに確率分布を考えます。データ D を見る前の分布が事前分布、見た後の分布が事後分布です。

第2章のベイズ則と同じ形です。p(θ) は事前分布、p(D | θ) は尤度、左辺は事後分布です。
事後分布が最も大きくなる θ を1つ選ぶ方法が、MAP推定です。

最尤推定の式に、事前分布の対数 log p(θ) が加わっただけです。分母の p(D) は θ を含まないので、最大の位置を探すときには無視できます。
第4章で問題になった、「コインを3回投げて3回とも表」の例で比べてみましょう。事前分布として、θ が 0.5 の近くにありそうだという考えを表すベータ分布 Beta(2, 2) を使います。「あらかじめ表を1回、裏を1回見ている」と考えるのと同じ効果があります。
- 最尤推定:3 ÷ 3 = 1.0
- MAP推定:(3 + 1) ÷ (3 + 2) = 0.8
- ベイズ推定:事後分布はベータ分布 Beta(5, 2) になる。平均は 5 ÷ 7 = 約 0.714
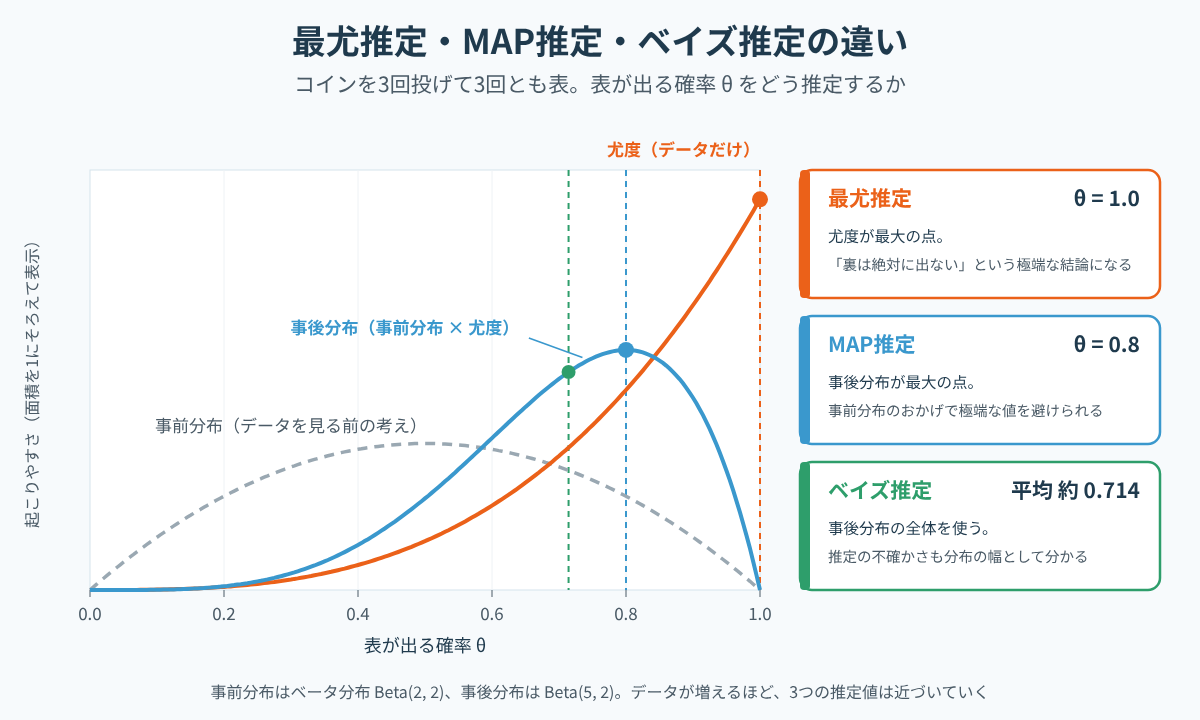
3つの推定の違いは、次のように整理できます。
- 最尤推定:データだけを使い、パラメータを1つの値で答える
- MAP推定:データと事前分布を使い、パラメータを1つの値で答える
- ベイズ推定:データと事前分布を使い、パラメータを分布のまま扱う。推定の不確かさも分布の幅として分かる
正則化との関係
MAP推定は、機械学習の正則化と同じものです。重みの事前分布を、平均 0 のガウス分布とします。第3章の式の対数をとると、log p(θ) は「重みの2乗に負の係数を掛けたもの」になります。MAP推定は「対数尤度 - 係数 × 重みの2乗」を最大にする計算になり、L2正則化(重み減衰)を付けた学習と一致します。事前分布をラプラス分布にすると、L1正則化になります。
「重みは 0 の近くにあるはずだ」という事前の考えを加えることで、少ないデータに合わせすぎるのを防いでいるのです。
ナイーブベイズ
ベイズ則を分類に使う単純な方法が、ナイーブベイズです。迷惑メールの判定を例にします。全体の 40% が迷惑メールで、「無料」という単語は迷惑メールの 50%、通常のメールの 10% に含まれるとします。「無料」を含むメールが迷惑メールである確率は、次のように求めます。
- 迷惑メールの場合:0.4 × 0.5 = 0.20
- 通常のメールの場合:0.6 × 0.1 = 0.06
- 事後確率:0.20 ÷ (0.20 + 0.06) = 約 0.769
単語が複数あるときは、「単語どうしは互いに独立である」と仮定して、単語ごとの確率を掛け合わせます。現実の文章では成り立たない単純な(ナイーブな)仮定ですが、計算が軽く、実用でも良い精度が出ることが知られています。
計算できない問題と MCMC
ベイズ推定には、大きな壁がありました。事後分布の分母 p(D) を求めるには、すべての θ についての積分が必要です。パラメータが増えると、この積分は手計算でも計算機でも求められなくなります。
解決の手がかりは、物理学にありました。1953年にメトロポリスらが考え、1970年にヘイスティングスが一般化した方法は、分母を計算しないまま、目的の分布に従うサンプル(乱数)を次々に取り出します。1984年にはゲマン兄弟がギブスサンプリングを発表し、1990年にゲルファンドとスミスが、これらの方法でベイズ統計の計算ができることを示しました。まとめて MCMC(Markov Chain Monte Carlo:マルコフ連鎖モンテカルロ法)と呼ばれます。計算機の性能が上がったことで、ベイズ統計は実用の道具になりました。
同じ時期に、計算機の力を使う方法がほかにも生まれています。1977年の EM(Expectation-Maximization)アルゴリズムは、直接は観測できない変数を含むモデルの最尤推定を可能にしました。1979年にエフロンが発表したブートストラップは、手元のデータから重複を許して何度もデータを取り出し直すことで、推定値のばらつきを調べます。
コラム 頻度主義とベイズ主義は何が違うのか
第4章の頻度主義と、第6章のベイズ主義の違いを整理します。
- 確率の意味:頻度主義では「何度も繰り返したときの割合」。ベイズ主義では「確からしさの度合い」
- パラメータの扱い:頻度主義では「未知だが1つに決まった値」。ベイズ主義では「確率分布を持つもの」
- 使う情報:頻度主義ではデータだけ。ベイズ主義ではデータと事前分布
- 代表的な方法:頻度主義では最尤推定、p値、信頼区間。ベイズ主義では MAP推定、ベイズ推定、信用区間
よく混同されるのが、信頼区間と信用区間です。頻度主義の 95% 信頼区間は、「同じ調査を何度も繰り返すと、作った区間の 95% が真の値を含む」という意味です。ベイズ主義の 95% 信用区間は、「パラメータがこの区間にある確率が 95%」という意味で、直感に近い読み方ができます。
どちらが正しいかを争うものではなく、場面に応じて使い分ける道具です。データが多くなると、両者の結果は近づきます。コインを300回投げて表が210回出た場合、最尤推定値は 0.7、事前分布を Beta(2, 2) とした MAP推定値は (210 + 1) ÷ (300 + 2) = 約 0.699 です。
問い:ベイズ主義の方法が、頻度主義の方法より役に立つのは、どのような場面でしょうか。
答え:データが少ない場面や、推定の不確かさを確率として示したい場面です。事前分布によって極端な推定を防ぐことができ、事後分布の幅から不確かさを読み取れます。
E資格のポイント
- MAP推定の式は、最尤推定の式に log p(θ) を加えたものである
- 事前分布をガウス分布とした MAP推定は L2正則化、ラプラス分布とした MAP推定は L1正則化にあたる
- 事前分布が一様分布(どの値も同じ確率)なら、MAP推定は最尤推定と一致する
- ナイーブベイズは、特徴どうしの独立を仮定してベイズ則を使う分類の方法である
残された問題
- MCMC は時間がかかる:サンプルを1つずつ取り出すため、データやパラメータが膨大なモデルには向きません
- 複雑なデータの分布を表せない:画像や文章のような次元の高いデータの分布を表すには、もっと表現力の高いモデルが必要でした
ここで確認
問い:コインを10回投げて10回とも表でした。事前分布を Beta(2, 2) とすると、MAP推定値はいくつでしょうか。
答え:(10 + 1) ÷ (10 + 2) = 約 0.917 です。最尤推定値の 1.0 より小さくなりますが、データが増えた分、3回中3回のときの 0.8 よりも 1.0 に近づいています。
第7章 機械学習との合流(1988〜2017)
2つの文化
1988年、ジューディア・パールは、多くの変数の間の確率的な関係をネットワークで表すベイジアンネットワークを本にまとめ、確率が AI(Artificial Intelligence:人工知能)の研究の中心的な道具になりました。一方で2001年、統計学者のブレイマンは、「データを生む仕組みをモデルにする文化」と「予測の精度を重視するアルゴリズムの文化」という2つの文化があると指摘しました。機械学習は後者として大きく成長しますが、その土台には、ここまでの章で見てきた確率・統計の考え方が使われています。
損失関数は負の対数尤度
ニューラルネットワークの出力を、確率分布のパラメータとみなすと、代表的な損失関数はすべて最尤推定から導けます。
- 回帰:出力をガウス分布の平均とみなす。負の対数尤度は平均二乗誤差になる
- 2クラスの分類:シグモイド関数の出力をベルヌーイ分布の μ とみなす。負の対数尤度は2値の交差エントロピーになる
- 多クラスの分類:ソフトマックス関数の出力をマルチヌーイ分布(カテゴリ分布)の確率とみなす。負の対数尤度は交差エントロピーになる
マルチヌーイ分布は、ベルヌーイ分布を3つ以上の結果に広げた分布です。ソフトマックス関数は、ネットワークの出力を、合計が 1 の確率に変換します。

z_k は k 番目のクラスに対するネットワークの出力、p_k は k 番目のクラスの確率です。出力が (2, 1, 0) のとき、確率は約 (0.665, 0.245, 0.090) になります。正解が1番目のクラスなら、損失は -log 0.665 = 約 0.408 です。
第1章のベルヌーイ分布、第3章のガウス分布、第4章の最尤推定、第5章の交差エントロピーが、ここで1つにつながりました。
変分推論と生成モデル
第6章で残った MCMC の遅さは、変分推論が解決しました。事後分布を直接求める代わりに、扱いやすい形の分布を用意し、事後分布との KLダイバージェンスが小さくなるように調整します。サンプルを取り出す問題を、ニューラルネットワークが得意な最適化の問題に置き換えたのです。
2013年の VAE(Variational Autoencoder:変分オートエンコーダ)は、変分推論とニューラルネットワークを組み合わせた生成モデルです。損失関数は、「再構成の誤差」と「KLダイバージェンス」の和になっています。2014年の GAN(Generative Adversarial Network:敵対的生成ネットワーク)は、理論の上では、本物のデータの分布と生成したデータの分布の JSダイバージェンスを小さくする学習にあたります。第5章の道具が、画像や文章を作るモデルの設計に使われるようになりました。
E資格のポイント
- 出力の分布と損失関数の組み合わせ(ガウス分布と平均二乗誤差、ベルヌーイ分布と2値の交差エントロピー、マルチヌーイ分布と交差エントロピー)を対応させて覚える
- VAE の損失関数には KLダイバージェンスが、GAN の理論には JSダイバージェンスが登場する
残された問題
- モデルの確信度が当てにならない:2017年の研究は、層の深いニューラルネットワークでは、出力の確率が実際の正解率より高くなりやすいと報告しました。「確率 0.9」と出力した予測が、実際には 0.9 の割合で当たっていないのです
- 相関と因果を区別できない:予測が当たることと、原因が分かることは別です。予測モデルだけでは、「施策を変えたら結果がどうなるか」には答えられません
- p値の誤用が表面化した:心理学や医学などで、有名な研究の結果を再現できない例が相次ぎ、第4章で残った p値の問題が改めて注目されました
ここで確認
問い:2クラスの分類で、ネットワークの出力が (1, 1) のとき、ソフトマックス関数の出力と、正解が1番目のクラスのときの損失を答えてください。
答え:2つの出力が同じなので、確率は (0.5, 0.5) です。損失は -log 0.5 = 約 0.693 です。
第8章 不確実性と向き合う現在(2016〜2026)
p値の見直し
2016年3月、ASA(American Statistical Association:米国統計協会)は、p値の使い方について声明を発表しました。p値は仮説が正しい確率ではないこと、0.05 というしきい値だけで結論を決めてはならないことなどを、原則としてまとめたものです。2019年には、同協会の学術誌の特集号の巻頭論文が、「統計的に有意」という言い方そのものをやめるように提案しました。ただし、p値の計算や利用をやめるように求めたわけではありません。声明から10年が過ぎた2026年も、議論は続いています。
相関から因果へ
予測ではなく原因を知るための方法も整えられました。1970年代にルービンが発展させた「もし別の選択をしていたら」という考え方の枠組みと、パールが作った因果をグラフで表す方法が、2本の柱です。パールは2011年にチューリング賞を受賞し、2021年には、自然に生じた状況を実験のように使って因果関係を調べる方法を確立したカード、アングリスト、インベンスが、ノーベル経済学賞を受賞しました。
予測に保証を付ける:コンフォーマル予測
第7章で残った「確信度が当てにならない」問題に対して注目されているのが、コンフォーマル予測です。もとの考え方は、1990年代の後半にヴォフクらが発表しました。
コンフォーマル予測は、答えを1つではなく、候補の集合で返します。「正解が集合に含まれる確率が 90% 以上」という保証を、データの分布の形を仮定せずに付けられる点が特徴です。手順は次のとおりです。
- 学習に使っていない検証用のデータで、予測の外れ具合を表すスコアを計算する
- スコアを小さい順に並べ、90% の位置にあるスコアを基準とする
- 新しいデータに対して、スコアが基準以下になる候補をすべて集合に入れる
自信のある問題では集合が小さく、自信のない問題では集合が大きくなります。集合の大きさが、不確かさを表すのです。
大規模言語モデルが誤った内容を自信を持って答えてしまう問題への対策としても、研究が盛んです。ただし、保証が成り立つのは、検証用のデータと運用時のデータの傾向が同じ場合です。運用時にデータの傾向が変わると、保証は崩れます。2026年には、質問の傾向が変わった場合にも保証を保つための方法が、国際会議で発表されています。
いつ止めてもよい検定:e値
p値には、「データを見ながら途中で何度も検定すると、誤った結論が増える」という弱点もあります。この弱点を補う考え方として研究が進んでいるのが、e値です。
e値は、賭けの考え方で作られています。帰無仮説が正しければ増えないはずの賭け金を考え、データが届くたびに賭けを続けます。賭け金が大きく増えたなら、帰無仮説に反する証拠が集まったと判断します。途中のどの時点で止めても、誤りの確率を抑えられる点が特徴です。新薬の効果を調べる臨床試験や、Web サービスの改善の効果を比べる実験など、データが順番に届く場面への応用が研究されています。
第1章で賭けの問題から始まった確率は、約370年を経て、賭けの考え方で検定を作り直すところまで来ました。
統計と機械学習の共通の土台
2025年、統計学の分野で権威のある国際統計学賞は、グレース・ワーバに贈られました。授賞の理由は、ノイズを含むデータになめらかな曲線を当てはめる方法(平滑化スプライン)の研究です。当てはまりの良さと、曲線のなめらかさのバランスを取る考え方は、機械学習の正則化の土台になっています。第6章で見たように、正則化は事前分布を置く MAP推定とも結び付いています。
また、医薬品の分野でも、ベイズ統計を使う動きが進んでいます。2026年1月には、アメリカの FDA(Food and Drug Administration:食品医薬品局)が、ベイズ統計の手法に関する指針の案を公表しました。
今も残る問題
- 大規模言語モデルの不確かさを、どのように測り、利用者に伝えるか
- 学習時と運用時でデータの傾向が変わったとき、保証をどのように保つか
- 事前分布や仮定の選び方を、どのように説明し、検証するか
- 予測の精度が高いモデルから、因果関係をどこまで読み取れるか
ここで確認
問い:コンフォーマル予測で、予測の集合が大きくなるのは、どのような場合でしょうか。また、保証が成り立つための条件は何でしょうか。
答え:モデルが自信を持てない、難しいデータの場合に集合が大きくなります。保証が成り立つのは、検証用のデータと運用時のデータの傾向が同じ場合です。
終章 物語を振り返る
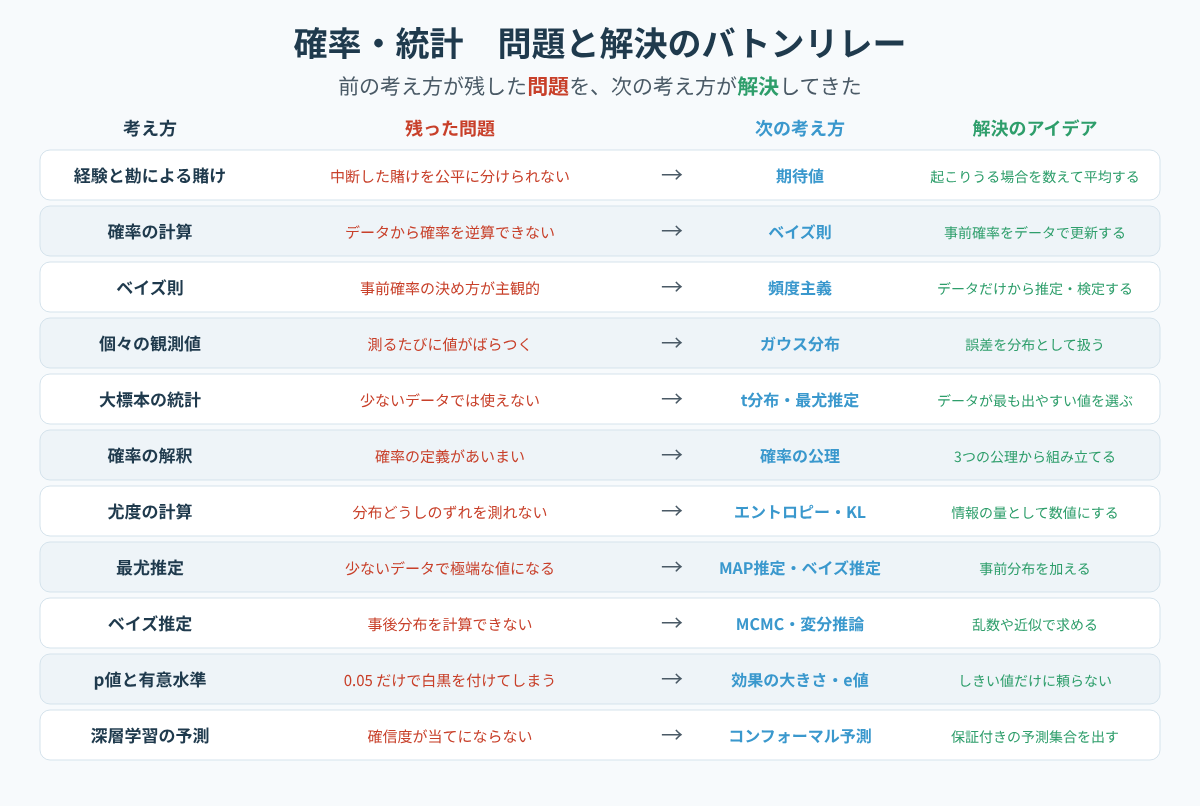
問題と解決のバトンリレー
8つの章を、「残った問題」と「解決のアイデア」の組み合わせで並べ直すと、次の図になります。
E資格のキーワードと歴史の対応
E資格で問われるキーワードが、物語のどこで生まれたかを1枚にまとめました。公式を単独で覚えるのではなく、「何を解決するために生まれたか」とセットにすると、記憶に残りやすくなります。
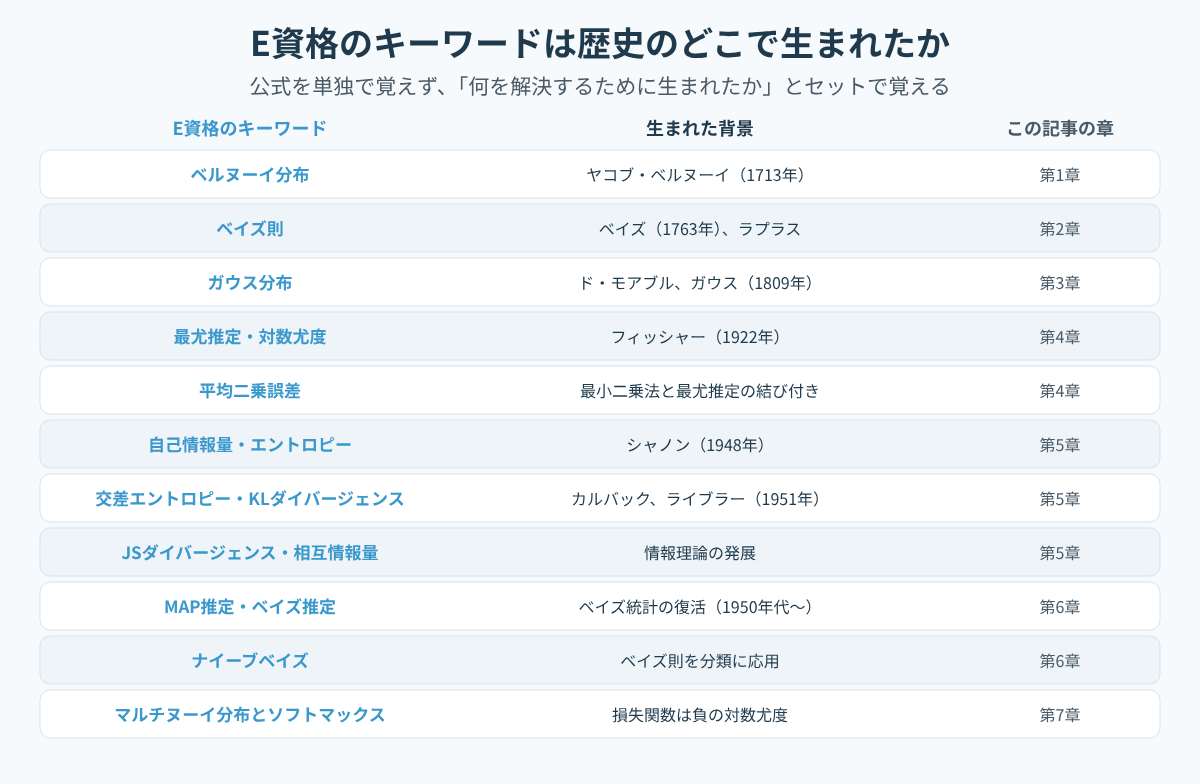
3つのパターン
約370年の歴史から、3つのパターンが読み取れます。
1つ目は、確率と統計の往復です。確率(仕組みからデータへ)が先に整い、統計(データから仕組みへ)がその道具を借りて発展しました。最尤推定が尤度という確率の計算を使い、情報理論が最尤推定に新しい意味を与えたように、2つは互いを支えています。
2つ目は、主観と客観の綱引きです。ベイズの考え方は主観的だと批判されて頻度主義が主流になり、頻度主義の限界が見えるとベイズが復活しました。現在は、両方を場面に応じて使い分けています。正則化が事前分布にあたるように、機械学習は2つの立場の成果を両方とも使っています。
3つ目は、計算の力が理論を実用に変えてきたことです。ベイズ推定は MCMC と計算機によって、変分推論はニューラルネットワークと最適化によって、実際に使える道具になりました。
確認問題
最尤推定、MAP推定、ベイズ推定について、正しい説明を1つ選んでください。
- 最尤推定は、事前分布と尤度の積が最大になるパラメータを1つ選ぶ方法である
- MAP推定は、事後分布の全体を使って、パラメータを分布のまま扱う方法である
- MAP推定は、事前分布がどの値も同じ確率の一様分布なら最尤推定と一致する
- ベイズ推定は、データが増えれば増えるほど事前分布の影響が大きくなっていく
解答と解説
正解は 3 です。
- 1 は誤りです。事前分布と尤度の積(事後分布)が最大になるパラメータを選ぶのは、MAP推定です。最尤推定は事前分布を使わず、尤度だけを最大にします
- 2 は誤りです。事後分布の全体を使い、パラメータを分布のまま扱うのは、ベイズ推定です。MAP推定は、事後分布が最大になる1つの値だけを答えます
- 3 が正解です。一様分布では log p(θ) がどの θ でも同じ値になるので、MAP推定の式から消え、最尤推定の式と同じになります
- 4 は誤りです。データが増えるほど尤度の影響が大きくなり、事前分布の影響は小さくなります。3回中3回表では MAP推定値が 0.8 でしたが、300回中210回表では約 0.699 となり、最尤推定値の 0.7 とほぼ同じになりました
研修で使うときの進め方
講師向けに、この物語を研修で使う進め方の一例を示します。
- 「箱の中身から玉を予想する」と「玉から箱の中身を推測する」のたとえで、確率と統計の向きの違いを確認する
- 年表の図を示し、8つの章の全体像を先に見せる
- 賭けの分配の問題を、受講者に考えてもらう。勝ち数の比で分ける案と、これからの場合を数える案を比べる
- 検査の陽性の例を、1万人の表を書いて計算してもらい、ベイズ則の式と対応させる
- コイン10回中7回表の対数尤度を、θ が 0.5、0.7、0.9 の3つの場合で計算してもらう
- 3回中3回表の例で、最尤推定、MAP推定、ベイズ推定の結果を比べ、図で確認する
- 交差エントロピーと KLダイバージェンスを、2つか3つの値の小さな分布で計算してもらう
- E資格のキーワードの図を使い、各キーワードが「何を解決するために生まれたか」を受講者に説明してもらう
Python の演習と組み合わせる場合は、NumPy でコイン投げのシミュレーションを行い、投げる回数を 10、100、1000、10000 と増やしたときに、表の割合が確率に近づく様子(大数の法則)や、最尤推定値と MAP推定値が近づいていく様子を確かめる実習がおすすめです。
初学者がつまずきやすい点も挙げておきます。
- 確率 P(B | A) と P(A | B) を混同する。検査の例で、「病気の人が陽性になる確率」と「陽性の人が病気である確率」を言葉で区別してもらうとよい
- 尤度を確率と同じものだと考える。尤度は、データを固定してパラメータを動かしたときの値であり、パラメータについて足し合わせても 1 にはならない
- p値を「仮説が正しい確率」だと解釈する
- KLダイバージェンスを距離だと考え、入れ替えても同じ値になると思い込む
まとめ
確率・統計の歴史は、次の流れで整理できます。
- 賭けの問題から期待値と確率の計算が生まれ、ベルヌーイが大数の法則を示した
- ベイズとラプラスが、結果から原因の確率を求めるベイズ則を作ったが、事前確率の決め方が問題になった
- 観測の誤差の研究からガウス分布と中心極限定理が生まれた
- フィッシャーらが、事前確率を使わない最尤推定と検定を確立したが、少ないデータでの極端な推定と p値の誤解が残った
- コルモゴロフが確率の土台を固め、シャノンがエントロピーや分布のずれを測る道具を作った
- ベイズ統計が復活し、MAP推定とベイズ推定が極端な推定を防ぎ、MCMC が計算の壁を越えた
- 機械学習と合流し、損失関数、正則化、生成モデルが確率・統計の言葉で説明されるようになった
- 現在は、p値の見直し、因果推論、コンフォーマル予測、e値など、不確実性と正しく向き合う方法が研究されている
公式を1つずつ暗記するのではなく、「どの問題を解決するために生まれたのか」を軸にすると、受講者は式の意味を自分の言葉で説明できるようになります。
次の学習ステップとして、まずコイン投げの例で、最尤推定、MAP推定、ベイズ推定を手で計算してみてください。そのうえで、ガウス分布を仮定した最尤推定から平均二乗誤差を導く計算、ソフトマックス関数と交差エントロピーの組み合わせの微分へと進むと、E資格の機械学習と深層学習の範囲につながっていきます。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 山崎講師2026年11月16日線形代数の歴史を物語で学ぶ|連立方程式から行列、固有値、特異値分解、GPU、AIによる行列積の高速化まで(E資格対応)
 山崎講師2026年11月16日確率・統計の歴史を物語で学ぶ|賭けの問題からベイズ則、最尤推定、エントロピー、MAP推定、不確実性の定量化まで(E資格対応)
 山崎講師2026年11月15日機械学習の歴史を物語で学ぶ|最小二乗法からパーセプトロン、決定木、SVM、ランダムフォレスト、勾配ブースティング、表形式基盤モデルまで
 山崎講師2026年11月15日オプティマイザの歴史を物語で学ぶ|勾配降下法からモーメンタム、AdaGrad、RMSProp、Adam、AdamW、Muonまで