線形代数の歴史を物語で学ぶ|連立方程式から行列、固有値、特異値分解、GPU、AIによる行列積の高速化まで(E資格対応)
 山崎講師
こんにちは。ゆうせいです。
E資格の研修で線形代数を扱うと、行列の積、逆行列、固有値、特異値分解と、計算の手順を伴う用語が続きます。受講者から「計算はできても、何のための計算なのか分かりません」「線形代数は AI(Artificial Intelligence:人工知能)のどこで使うのですか」と質問された経験のある講師の方は多いのではないでしょうか。
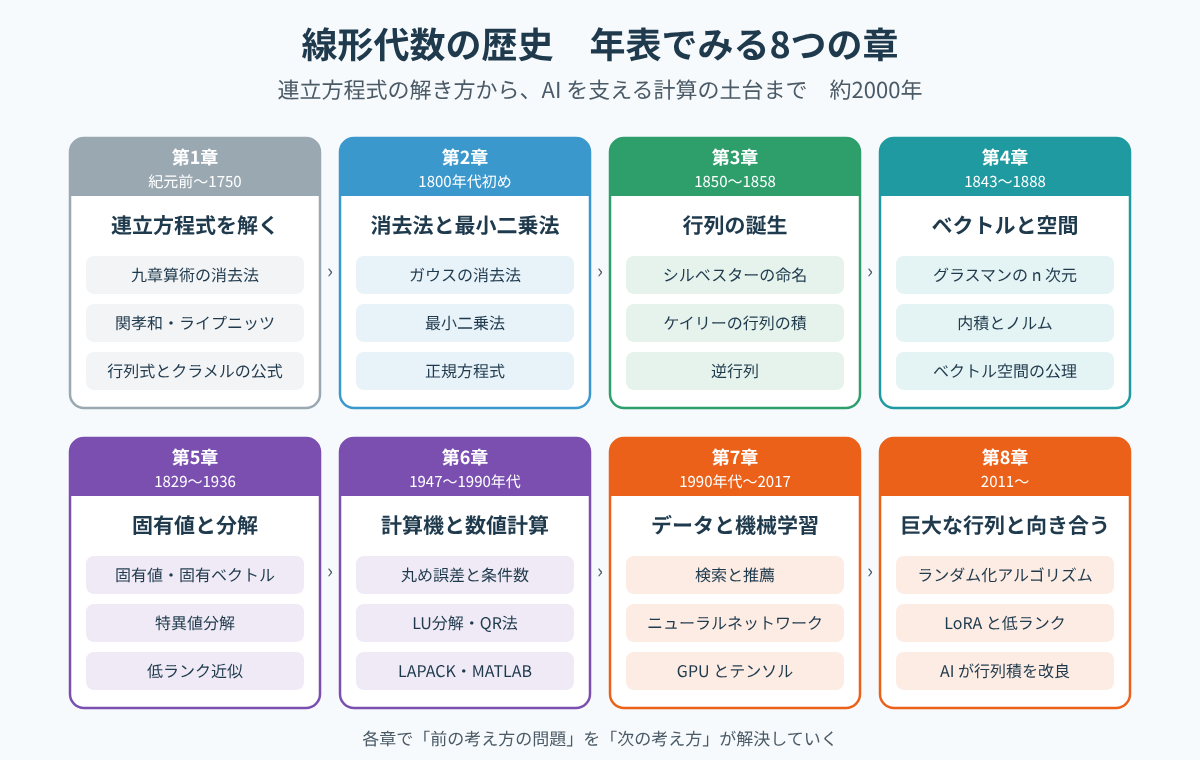
線形代数の用語は、計算の手順として覚えようとすると大変です。しかし、「前の考え方にどのような問題があり、次の考え方がどのように解決したか」という順番で並べると、1本の物語として理解できます。今回は、約2000年前の連立方程式の解き方から、2026年の AI による行列積の高速化まで、8つの章でたどります。各章には、E資格とのつながり、数値例、確認の問いを付けました。
序章 線形代数とは何か
線形代数は、「たくさんの数をまとめて扱い、まっすぐな関係を調べる」ための数学です。
「まっすぐな関係(線形)」とは、次の2つが成り立つ関係を指します。
- 入力を2倍にすると、出力も2倍になる
- 2つの入力を足してから入れた結果は、別々に入れた結果を足したものと同じになる
1個 100円の品物を x 個買うと代金が 100x 円になる、という関係が代表例です。世の中の複雑な関係も、狭い範囲で見ればまっすぐな関係で近似できるため、線形代数は科学や工学の共通の道具になりました。
物語の中で、数を並べた表(行列)は3つの顔を見せます。
- 連立方程式の係数の表
- 空間を変形する働き(変換)
- データそのものを入れる器
E資格と線形代数の関係についても触れておきます。E資格のシラバスは改訂が重ねられており、項目の立て方は版によって変わります。2019年版と2020年版のシラバスには、線形代数の項目として特異値分解が載っていました。最新の範囲は、JDLA(Japan Deep Learning Association:日本ディープラーニング協会)の公式サイトで確認してください。項目として載っているかどうかにかかわらず、全結合層の計算、誤差逆伝播、主成分分析、正則化、Attention などは、すべて行列とベクトルの言葉で書かれています。線形代数は、E資格の機械学習と深層学習の範囲を読み解くための前提知識です。
この記事で登場する主なキーワードは、次のとおりです。
- 基本の道具:スカラー、ベクトル、行列、テンソル、行列の積、転置、逆行列、行列式
- 測る道具:内積、ノルム、コサイン類似度
- 分解する道具:固有値、固有ベクトル、固有値分解、特異値分解、低ランク近似
第1章 連立方程式を解く(紀元前〜1750)
2000年前の消去法
物語は、古代の中国から始まります。約2000年前にまとめられた数学書『九章算術』の第8章「方程」には、連立方程式の解き方が載っています。計算用の棒(算木)を並べて係数の表を作り、列どうしを引き算して未知数を1つずつ消していく方法です。現在の消去法と同じ考え方で、「方程式」という言葉のもとにもなりました。
現代の書き方で例を示します。
- 2x + y = 5
- x + 3y = 10
2つ目の式を2倍すると 2x + 6y = 20 です。ここから1つ目の式を引くと、x が消えて 5y = 15 となり、y = 3 が求まります。1つ目の式に戻すと、x = 1 です。
行列式:解が1つに決まるかを判定する
消去法は強力ですが、計算を始める前に「解が1つに決まるか」を知る方法がありませんでした。17世紀の終わりに、日本の関孝和(1683年)とドイツのライプニッツ(1693年)が、それぞれ独自に、係数だけから計算できる特別な数を見つけます。行列式です。未知数が2つの場合は、次の式で求めます。

a、b、c、d は、連立方程式の係数です。上の例では 2 × 3 - 1 × 1 = 5 です。行列式が 0 でなければ、解は1つに決まります。行列式が 0 になるのは、2x + y = 5 と 4x + 2y = 10 のように、2つの式が実質的に同じ内容の場合です。式が1本分しかないので、解は1つに決まりません。
1750年には、スイスのクラメルが、連立方程式の解を行列式の割り算で直接書き表す公式を発表しました。上の例では、x = (5 × 3 - 1 × 10) ÷ 5 = 1、y = (2 × 10 - 5 × 1) ÷ 5 = 3 となります。
E資格とのつながり
- 行列式が 0 の行列は、逆行列を持たない(第3章)
- 多次元のガウス分布の式には、共分散行列の行列式と逆行列が登場する
残された問題
クラメルの公式は、未知数が増えると計算の量が爆発します。行列式を定義どおりに計算すると、未知数が n 個のとき、n の階乗(1 から n までの掛け算)の個数の項が現れるからです。未知数が10個なら約363万個、20個なら約 2.4 × 10 の18乗個です。式として美しくても、実際の計算には使えませんでした。
ここで確認
問い:x + 2y = 3、3x + 6y = 9 という連立方程式の係数の行列式を計算し、解が1つに決まるかどうかを答えてください。
答え:行列式は 1 × 6 - 2 × 3 = 0 です。2つ目の式は1つ目の式を3倍しただけなので、解は1つに決まりません。
第2章 消去法と最小二乗法(1800年代初め)
小惑星を追いかける
1801年、小惑星ケレスが発見されましたが、すぐに太陽の陰に入って見失われました。当時24歳だったドイツのガウスは、わずかな観測データから軌道を計算し、再び現れる位置を予測して的中させます。
ガウスが使ったのは、最小二乗法です。多くの観測データに最もよく合う軌道を求めようとすると、未知数がいくつもある連立方程式が現れます。ガウスは、消去の手順を誰がやっても同じ結果になるように整理しました。現在「ガウスの消去法」と呼ばれる方法です。
- 前進消去:上の式を使って、下の式から未知数を1つずつ消していく
- 後退代入:最後に残った1つの未知数を求め、上の式に戻しながら残りを求める
未知数が3つの例で確かめます。
- x + y + z = 6
- 2x + 3y + z = 11
- x + 2y + 3z = 14
2つ目の式から1つ目の式の2倍を引くと y - z = -1、3つ目の式から1つ目の式を引くと y + 2z = 8 です。この2つの差をとると 3z = 9 で、z = 3 が求まります。後ろから順に戻すと、y = 2、x = 1 です。
消去法の計算の量は、およそ n の3乗に比例します。未知数が20個なら、20 の3乗で 8000 程度の規模です。第1章のクラメルの公式の 2.4 × 10 の18乗と比べると、桁違いに少ない計算で済みます。
E資格とのつながり
線形回帰で、誤差の2乗の合計が最小になる重み w を求めると、次の式(正規方程式の解)になります。

X はデータを並べた行列、y は正解を並べたベクトル、右肩の T は転置(行と列の入れ替え)、-1 は逆行列です。ガウスが軌道の計算で解いた連立方程式は、この正規方程式にあたります。
残された問題
消去法は「計算の手順」であり、係数の表そのものを1つの対象として扱う言葉は、まだありませんでした。座標の変換を2回続けるとどうなるか、といった問いを考えるたびに、すべての係数を書き並べて計算し直す必要があったのです。
ここで確認
問い:ガウスの消去法の2つの段階の名前と、それぞれの役割を説明してください。
答え:前進消去と後退代入です。前進消去では、上の式を使って下の式から未知数を順に消し、最後の式を未知数1つだけにします。後退代入では、最後の式から未知数を求め、上の式へ順に代入して残りの未知数を求めます。
第3章 行列の誕生(1850〜1858)
表に名前を付け、1つの文字で表す
1850年、イギリスの数学者シルベスターは、数を長方形に並べた表に matrix(行列)という名前を付けました。ラテン語で「母体」を意味する言葉です。友人のケイリーは1858年の論文で、行列どうしの足し算、掛け算、逆行列を定義し、行列を1つの文字で表して計算する方法を示しました。
第1章の連立方程式は、行列を使うと次のように書けます。

係数の行列を A、未知数のベクトルを x、右辺のベクトルを b と置くと、Ax = b です。未知数が2個でも1万個でも、同じ1行の式で書けるようになりました。
行列の積は「変換を続けて行う」こと
ケイリーが定義した行列の積は、「左の行列の行」と「右の行列の列」を組み合わせて、掛けて足す計算です。

左上の 2 は、1 × 0 + 2 × 1 で求めます。複雑に見える定義ですが、「変換 B を行った後に、変換 A を行う」ことを1つの行列で表せるように作られています。
順番を入れ替えた BA を計算すると、1行目が (3, 4)、2行目が (1, 2) の行列になり、AB とは一致しません。行列の積では、掛ける順番を入れ替えると結果が変わります。「靴下をはいてから靴をはく」と「靴をはいてから靴下をはく」が違う結果になるのと同じです。
逆行列:割り算の代わり
行列には割り算がありません。その代わりに、掛けると単位行列(何もしない変換)になる逆行列を使います。2行2列の場合は、次の公式で求めます。

分母は、第1章の行列式です。行列式が 0 のときに逆行列が存在しない理由が、式から分かります。上の連立方程式の A では、行列式が 5 なので、逆行列は「1行目が (3, -1)、2行目が (-1, 2) の行列」を 5 で割ったものです。b に掛けると、x = (3 × 5 - 1 × 10) ÷ 5 = 1、y = (-1 × 5 + 2 × 10) ÷ 5 = 3 となり、消去法と同じ答えが得られます。
E資格とのつながり
ニューラルネットワークの全結合層は、行列の積で書かれます。

W は重みの行列、x は入力のベクトル、b はバイアスのベクトル、y は出力のベクトルです。積が計算できるのは、「左の行列の列の数」と「右の行列の行の数」が同じときだけです。
- W が3行4列、x が4次元のベクトルなら、y は3次元のベクトルになる
- 誤差逆伝播では、W の転置を掛けて、誤差を出力の側から入力の側へ伝える
残された問題
行列は便利な計算の道具になりましたが、図形としての意味ははっきりしていませんでした。また、4次元以上の空間を数学として扱う枠組みも、まだ整っていませんでした。
ここで確認
問い:2行3列の行列と3行4列の行列の積は、何行何列になるでしょうか。掛ける順番を逆にすると、どうなるでしょうか。
答え:2行4列になります。順番を逆にすると、左の行列の列の数(4)と右の行列の行の数(2)が合わないので、計算できません。
コラム 行列が物理学で再発見された話
第3章では、ケイリーが1858年に行列という書き方を作った話を見ました。行列は、しばらくのあいだ純粋な数学の中の道具でした。ところが約70年後、思いがけない場所で行列が主役になります。
1925年、ドイツの若い物理学者ハイゼンベルクは、原子の世界を説明する新しい計算法を考えていました。花粉症の療養のため北海の小島ヘルゴラントに滞在していたとき、その計算法の骨組みを見つけます。ただしハイゼンベルク自身は、自分が組み立てた掛け算の規則が、数学ですでに知られていた行列の積と同じものだとは気づいていませんでした。
帰郷したハイゼンベルクの計算を見た指導者のボルンは、その奇妙な掛け算が行列の積にほかならないと気づきます。ボルンは同僚のヨルダンとともに理論を整え、原子の世界を記述する量子力学は、行列力学という形にまとめられました。ハイゼンベルクの掛け算には、順番を入れかえると答えが変わるという特徴がありました。行列の積も、ABとBAが一般には一致しません。第3章で学んだこの性質が、原子の世界の不思議さと結びついていたのです。
純粋な興味から作られた数学が、何十年も経ってから科学の最前線で必要になる。線形代数にかぎらず、数学の歴史にはこうした例がいくつもあります。研修では、いま学んでいる道具がどこで役に立つかすぐには見えなくても、土台として後から効いてくる、と伝える題材に使えます。
第4章 ベクトルと空間(1843〜1888)
向きと大きさを持つ量
行列と並行して、もう1つの流れが育っていました。ベクトルです。
1843年、アイルランドのハミルトンは、3次元の回転を表す四元数を思い付き、散歩の途中で橋に式を刻んだと伝えられています。1844年には、ドイツの教師グラスマンが、3次元に限らない n 次元の空間を扱う理論を発表しました。時代を先取りした内容でしたが、難解だったため、当時はほとんど理解されませんでした。
1880年代になると、アメリカのギブスとイギリスのヘヴィサイドが、物理学で使いやすい形にベクトルの計算を整理します。そして1888年、イタリアのペアノが、「足し算と定数倍ができるものの集まり」をベクトル空間として定義しました。この定義によって、矢印だけでなく、数を並べたもの、関数、のちには画像や単語までもが、ベクトルとして扱えるようになります。
内積とノルム:似ている度合いと大きさを測る
ベクトルには、2つの基本的な「測る道具」があります。1つ目は内積です。

a_i と b_i は、ベクトル a と b の i 番目の成分です。同じ位置の成分どうしを掛けて、合計します。2つのベクトルの向きがどれくらい近いかは、次の式(コサイン類似度)で測れます。

θ(シータ)は2つのベクトルのなす角、分母はそれぞれのベクトルの長さです。値が 1 なら同じ向き、0 なら直角、-1 なら逆向きを表します。
2つ目は、ベクトルの大きさを測るノルムです。


1つ目の式は L2 ノルムで、成分の2乗の合計の平方根です。ふつうの意味での長さにあたります。2つ目の式は L1 ノルムで、成分の絶対値の合計です。
数値で確かめます。a が (3, 4)、b が (4, 3) のとき、内積は 3 × 4 + 4 × 3 = 24 です。どちらの L2 ノルムも、9 + 16 = 25 の平方根で 5 です。コサイン類似度は 24 ÷ (5 × 5) = 0.96 で、ほぼ同じ向きだと分かります。ベクトル (3, -4) の L1 ノルムは 3 + 4 = 7、L2 ノルムは 5 です。
行列は空間を変形する
ベクトル空間の考え方によって、行列に図形としての意味が与えられました。行列をベクトルに掛けることは、空間全体を、まっすぐな線はまっすぐなまま、回したり、伸ばしたり、傾けたりする操作(線形変換)です。第3章で見た行列の積の定義は、2つの変形を続けて行うことにあたります。
E資格とのつながり
- L2 ノルムは L2正則化(重み減衰)に、L1 ノルムは L1正則化に使われる
- 単語や文章を表すベクトルの近さは、コサイン類似度で測る
- Transformer の Attention は、ベクトルどうしの内積で「どの単語に注目するか」を決めている
残された問題
行列が空間を変形する働きだと分かると、新しい疑問が生まれました。同じ変形でも、座標の取り方によって、行列の中身は複雑にも単純にもなります。変形の本質を最も単純に表す見方は、どのようにすれば見つかるのでしょうか。
ここで確認
問い:ベクトル (1, 2, 2) の L1 ノルムと L2 ノルムを求めてください。
答え:L1 ノルムは 1 + 2 + 2 = 5 です。L2 ノルムは、1 + 4 + 4 = 9 の平方根で 3 です。
第5章 固有値と分解(1829〜1936)
向きが変わらないベクトルを探す
行列を掛けると、ほとんどのベクトルは向きが変わります。しかし中には、向きが変わらず、長さだけが変わる特別なベクトルがあります。固有ベクトルです。長さが何倍になるかを表す数を、固有値と呼びます。

A は行列、v は固有ベクトル、λ(ラムダ)は固有値です。この考え方は、惑星の運動や回転する物体の研究の中で育ちました。1829年、フランスのコーシーは、対称な行列(転置しても変わらない行列)の固有値が必ず実数になることを示しています。「固有」を表す eigen というドイツ語は、1904年にヒルベルトが使い始めました。
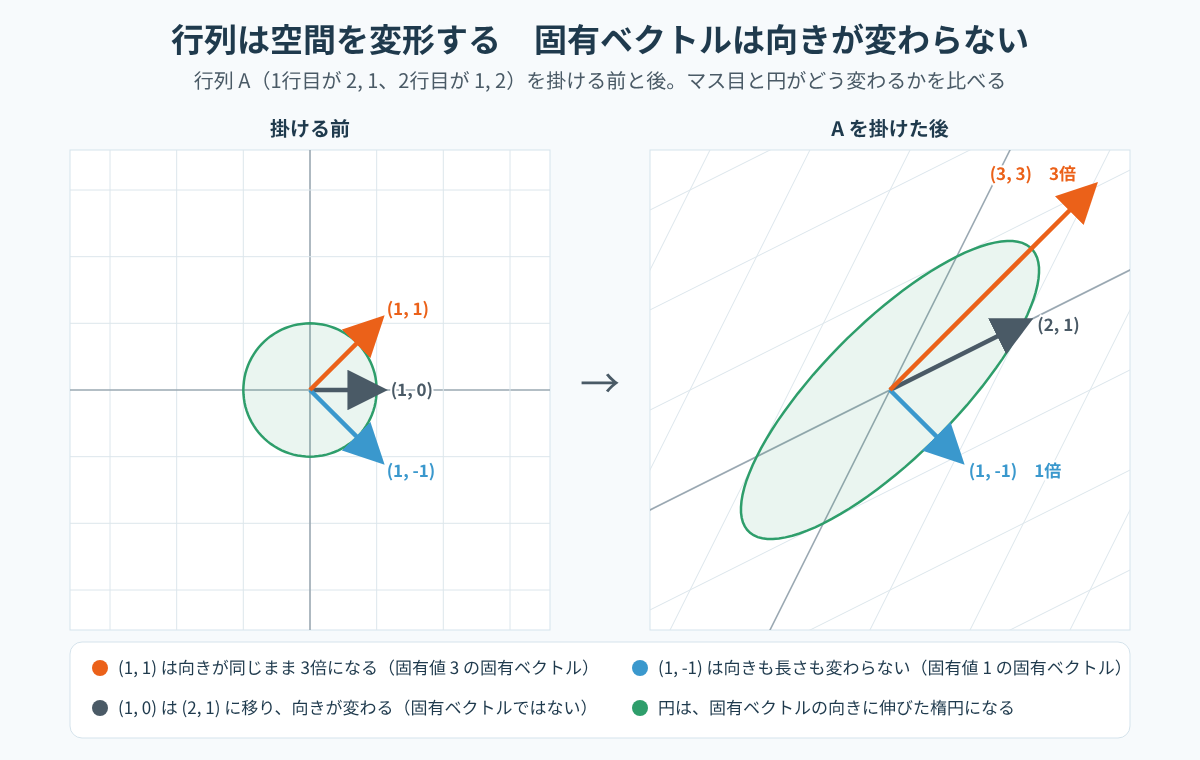
1行目が (2, 1)、2行目が (1, 2) の行列 A で確かめましょう。
- (1, 1) に掛けると (3, 3) になる。向きは同じで、長さが 3倍。固有値は 3
- (1, -1) に掛けると (1, -1) になる。向きも長さも変わらない。固有値は 1
- (1, 0) に掛けると (2, 1) になる。向きが変わるので、固有ベクトルではない
固有値は、次の式(特性方程式)を解いて求めます。

I は単位行列です。上の A では (2 - λ) の2乗 - 1 = 0 となり、λ = 1 と λ = 3 が得られます。
固有値分解:単純に見える向きで見る
固有ベクトルの向きに座標を取り直すと、行列の働きは「それぞれの軸を固有値の倍率で伸び縮みさせるだけ」になります。この見方を式にしたものが、固有値分解です。

P は固有ベクトルを列として並べた行列、Λ(ラムダの大文字)は固有値を対角線に並べた行列です。第4章で残った「変形の本質を最も単純に表す見方」への答えが、ここで得られました。
固有値分解を使うと、行列を何回も掛ける計算が簡単になります。A を10回掛けると、(1, 1) の向きは 3 の10乗 = 59049倍になり、(1, -1) の向きは 1倍のままです。繰り返し掛けたときの振る舞いは、固有値で決まります。
特異値分解:どんな形の行列も分解する
固有値分解には限界があります。行と列の数が同じ正方行列にしか使えず、正方行列でも分解できないものがあります。一方、データを入れた行列は、たとえば100人 × 5科目のような長方形です。
この限界を越えたのが、特異値分解(SVD:Singular Value Decomposition)です。1873年にイタリアのベルトラミが、1874年にフランスのジョルダンが、それぞれ発表しました。

U と V は直交行列(回転や反転を表す行列)、Σ(シグマの大文字)は特異値を対角線に並べた行列です。どんな形の行列の働きも、「回して、伸ばして、回す」の3つの段階に分けられる、という意味です。特異値は、A の転置と A の積の固有値の平方根として求められます。1行目が (3, 0)、2行目が (4, 5) の行列では、特異値は約 6.708 と約 2.236 です。計算の手順は、特異値分解の覚え方の記事で詳しく紹介しています。
1936年、エッカートとヤングは、大きい特異値の成分だけを残すと、元の行列に最も近い低ランクの行列が得られることを示しました。「情報をできるだけ失わずに、データを小さくする」方法に、数学の裏付けが付いたのです。1901年にピアソンが考え、1933年にホテリングが整理した主成分分析(PCA:Principal Component Analysis)も、固有値分解や特異値分解を使って計算します。
コラム 固有値分解と特異値分解の違い
名前が似ている2つの分解は、研修で混同されやすい内容です。違いを整理します。
- 使える行列:固有値分解は正方行列だけで、分解できない行列もある。特異値分解は、どんな形の行列にも使える
- 出てくる値:固有値は、負の数や複素数になることがある。特異値は、必ず 0 以上の実数になる
- 図形としての意味:固有値分解は「向きが変わらない方向と、その倍率」を表す。特異値分解は「回して、伸ばして、回す」を表す
- 2つの関係:特異値は、A の転置と A の積の固有値の平方根である。対称で、固有値がすべて 0 以上の行列では、固有値と特異値は一致する
問い:1行目が (2, 0)、2行目が (0, -3) の行列の、固有値と特異値を答えてください。
答え:対角線にしか値がない行列なので、固有値は対角線の値そのもので、2 と -3 です。特異値は 0 以上の値になるので、絶対値をとって大きい順に並べた 3 と 2 です。
E資格とのつながり
- 主成分分析は、データの共分散行列の固有ベクトルを求め、固有値が大きい向きから順に残す次元削減の方法である
- 特異値分解は、どんな形の行列にも使えるため、データの行列を直接分解できる
- 層を重ねたネットワークでは、重み行列の特異値が 1 より大きいか小さいかが、勾配爆発や勾配消失に関係する
残された問題
理論は整いましたが、計算の壁が残りました。特性方程式は、行列の大きさが n なら n 次の方程式です。5次以上の方程式には、解の公式がありません。大きな行列の固有値は、公式では求められないのです。手計算で扱える行列の大きさにも、限りがありました。
ここで確認
問い:1行目が (4, 0)、2行目が (0, 2) の行列の、固有値と固有ベクトルを答えてください。
答え:固有値は 4 と 2 です。固有値 4 の固有ベクトルは (1, 0)、固有値 2 の固有ベクトルは (0, 1) です。横の向きを 4倍、縦の向きを 2倍に伸ばす変換だと分かります。
第6章 計算機と数値線形代数(1947〜1990年代)
丸め誤差という新しい敵
1940年代に計算機が登場し、大きな連立方程式を解けるようになりました。ところが、新しい問題が現れます。計算機は、数を限られた桁数でしか扱えません。1回ごとのわずかな丸め誤差が、何万回もの計算の中で積み重なり、答えを狂わせるのではないか、という心配です。
1947年にフォン・ノイマンとゴールドスタインが、1948年にチューリングが、この問題を分析しました。チューリングは、消去法を行列の分解として整理した LU分解(L は下三角、U は上三角の行列)と、問題の解きにくさを表す条件数の考え方を示しています。

κ(カッパ)は条件数、分子は最大の特異値、分母は最小の特異値です。条件数が大きいほど、入力のわずかな違いが、答えの大きな違いになって現れます。
1行目が (1, 1)、2行目が (1, 1.001) の行列 A で、Ax = b を解いてみます。
- b が (2, 2.001) のとき:解は (1, 1)
- b が (2, 2.002) のとき:解は (0, 2)
右辺が 0.001 変わっただけで、解がまったく別の値になりました。この行列の条件数は約 4000 です。2本の直線がほぼ平行で、交点の位置が定まりにくい状況にあたります。
繰り返して近づく方法と、標準のソフトウェア
第5章で残った「大きな行列の固有値は公式で求められない」問題は、計算を繰り返して少しずつ答えに近づく方法(反復法)で解決されました。
- 1952年:共役勾配法。大きな連立方程式を、行列とベクトルの積の繰り返しで解く
- 1961年:QR法。行列の分解を繰り返して、固有値を求める
- 1965年:ゴラブとカハンが、特異値分解を安定して計算する方法を発表する
計算の方法は、誰でも使えるソフトウェアにまとめられていきます。1979年には、ベクトルと行列の基本的な計算をまとめた BLAS(Basic Linear Algebra Subprograms)が発表されました。1984年には MATLAB(MATrix LABoratory)が製品として発売され、1992年には LAPACK(Linear Algebra PACKage)が公開されます。Python の NumPy で行列の計算をするとき、内部で動いているのは、この流れをくむライブラリです。
E資格とのつながり
- 連立方程式を解くときは、逆行列を求めてから掛けるのではなく、専用の関数で直接解くほうが、速く、誤差も小さい
- 条件数が大きい状況は、損失関数が細長い谷の形をしている状況にあたる。勾配降下法が谷の壁の間で振動し、学習が進みにくくなる
残された問題
1990年代に入ると、インターネットの普及によって、扱うデータの規模が急に大きくなりました。数百万行、数百万列の行列を、どのように計算すればよいのでしょうか。
ここで確認
問い:最大の特異値が 100、最小の特異値が 0.01 の行列の条件数はいくつでしょうか。この行列を係数とする連立方程式には、どのような注意が必要でしょうか。
答え:条件数は 100 ÷ 0.01 = 10000 です。入力や計算途中のわずかな誤差が、解では大きく拡大されるおそれがあります。
第7章 データと機械学習(1990年代〜2017)
行列がデータの器になる
行列の3つ目の顔、「データを入れる器」が主役になります。
- 1990年:単語 × 文書の出現回数の行列を特異値分解し、少ない次元で意味の近さを表す潜在意味解析(LSA:Latent Semantic Analysis)が発表された
- 1998年:Web ページどうしのリンクを巨大な行列で表し、その固有ベクトルからページの重要度を計算する方法が、検索エンジンに使われた
- 2006〜2009年:利用者 × 作品の評価の行列を2つの小さな行列の積に分解する方法が、映画の推薦の精度を競うコンテストで活躍した
19世紀に生まれた固有値と特異値分解が、データを扱う産業の中心的な道具になったのです。
ニューラルネットワークは行列の積の積み重ね
ニューラルネットワークの計算も、行列の言葉で書かれています。第3章で見たように、1つの層は「重みの行列を掛けて、バイアスを足す」計算です。その後に活性化関数を通し、次の層でまた行列を掛けます。
実際の学習では、複数のデータをまとめて処理します。4次元の入力を32件まとめると、32行4列の行列になります。3行4列の重みの行列の転置を右から掛けると、32行3列の出力が一度に得られます。
行列の積は、「掛けて足す」という同じ形の計算の繰り返しです。画像の表示のために作られた GPU(Graphics Processing Unit)は、同じ形の計算を大量に並列で行うのが得意でした。2012年に、GPU を使って学習したディープラーニングのモデルが画像認識の大会で優勝し、深層学習の時代が始まります。
誤差逆伝播も、線形代数で書けます。微分の連鎖律は、層ごとの微分をまとめた行列(ヤコビ行列)を、出力の側から順に掛けていく計算にあたります。2017年の Transformer の Attention も、内積と行列の積の組み合わせです。
コラム スカラー・ベクトル・行列・テンソルの違い
深層学習のライブラリでは、数を並べたものをまとめて「テンソル」と呼びます。並べ方の次元の数(階数)によって、呼び名が変わります。
- スカラー(0階):1つの数。例:損失の値
- ベクトル(1階):数を1列に並べたもの。例:300次元の単語のベクトル。形状は (300,)
- 行列(2階):数を縦と横に並べたもの。例:3行4列の重み。形状は (3, 4)
- テンソル(3階以上):数を3つ以上の方向に並べたもの。例:カラー画像。色の数 × 縦 × 横で、形状は (3, 224, 224)
カラー画像を32枚まとめると、形状は (32, 3, 224, 224) の4階のテンソルになります。要素の数は 32 × 3 × 224 × 224 = 4,816,896 個です。
研修でコードを読むときは、「この時点でのテンソルの形状は何か」を1行ごとに確かめる習慣を付けてもらうと、エラーの原因を自分で見つけられるようになります。なお、数学や物理学でのテンソルには、座標の変換に対する決まりを含む、より厳密な定義があります。深層学習では、多次元の配列という意味で使われています。
問い:形状が (10, 28, 28) のテンソルは何階で、要素はいくつあるでしょうか。
答え:3階のテンソルです。要素の数は 10 × 28 × 28 = 7,840 個です。28 × 28 の白黒画像を10枚まとめたデータにあたります。
E資格とのつながり
- 全結合層、畳み込み層、Attention の計算を、入力と出力の形状とあわせて説明できるようにする
- CNN(Convolutional Neural Network:畳み込みニューラルネットワーク)の入力は、「バッチ × チャンネル × 縦 × 横」の4階のテンソルである
- 誤差逆伝播は、連鎖律を行列の積として計算している
残された問題
モデルが大きくなるにつれて、行列も巨大になりました。大規模言語モデルでは、1つの重み行列が数千行 × 数千列になり、それが何百個も使われます。行列の積や分解にかかる時間と電力が、AI の開発を左右する問題になりました。
ここで確認
問い:形状が (32, 4) の入力の行列に、形状が (3, 4) の重みの行列の転置を右から掛けると、出力の形状はどうなるでしょうか。
答え:重みの転置の形状は (4, 3) です。(32, 4) と (4, 3) の積なので、出力の形状は (32, 3) になります。32件のデータそれぞれについて、3次元の出力が得られます。
第8章 巨大な行列と向き合う現在(2011〜2026)
乱数で行列を小さくしてから解く
巨大な行列を正確に分解するには、時間がかかりすぎます。そこで発展したのが、乱数を使うランダム化アルゴリズムです。2011年にハルコ、マーティンソン、トロップがまとめた方法では、乱数で作った行列を掛けて、元の行列を「重要な成分を保ったまま小さな行列」に縮めます。小さな行列を特異値分解すれば、元の行列の大きい特異値の成分を、短い時間で近似できます。
乱数を使っても、誤差の大きさは理論で見積もれます。現在は、第6章の BLAS や LAPACK に相当する標準のライブラリを、ランダム化アルゴリズムについても整備する取り組みが進んでいます。
低ランクの考え方で学習を軽くする
第5章の低ランク近似は、大規模言語モデルの追加学習(微調整)にも使われています。2021年に提案された LoRA(Low-Rank Adaptation)です。

W は学習済みの重みの行列で、固定します。変更分だけを、2つの細長い行列 B と A の積で表し、B と A だけを学習します。W が1000行1000列、B が1000行10列、A が10行1000列なら、学習するパラメータは 10,000 + 10,000 = 20,000 個です。W 全体の 1,000,000 個と比べると、2% で済みます。
行列の積そのものを速くする
行列の積を定義どおりに計算すると、n 行 n 列の行列では n の3乗回の掛け算が必要です。1969年、ドイツのシュトラッセンは、2行2列の行列の積を、8回ではなく7回の掛け算で計算する方法を発見しました。大きな行列を小さな行列に分けて繰り返し使うと、掛け算の回数は次のように減ります。

4行4列の行列なら、定義どおりの計算では 64回、シュトラッセンの方法では 7 × 7 = 49回です。
この「49回」の記録を、AI が更新しました。2022年、AlphaTensor という AI が、0 と 1 だけを使う特別な計算の場合に、47回の方法を見つけます。2025年5月には、AlphaEvolve という AI が、複素数を成分とする4行4列の行列の積を 48回の掛け算で計算する方法を発見しました。シュトラッセンの方法からの改良は、56年ぶりです。
理論の研究も進んでいます。「行列の積は、n の何乗の計算量まで減らせるか」を表す指数は、ω(オメガ)と書かれます。定義どおりの計算は 3、シュトラッセンの方法は約 2.81 です。2026年8月には、AI を道具として使った研究によって、上限が 2.371339 から 2.371177 へ更新されました。ω の本当の値がいくつなのかは、今も分かっていません。
ただし、ω に関する理論上の方法は、現実の大きさの行列では使われていません。実際の高速化を支えているのは、GPU の性能と、メモリの使い方まで考えて作り込まれたライブラリです。
精度を下げて速くする
もう1つの方向は、数の精度を下げることです。32ビットで表していた数を16ビットや8ビットで表すと、同じメモリに多くの数を入れられ、計算も速くなります。第6章で恐れられた丸め誤差を、今度は「どこまでなら許せるか」を見極めながら、積極的に利用しているのです。
今も残る問題
- 行列の積の指数 ω の本当の値は、いくつなのか
- 乱数や低い精度を使った近似を、どこまで安全に使えるか
- 巨大なモデルの重み行列の中で何が起きているのかを、固有値や特異値からどこまで読み解けるか
- AI が見つけた計算の手順を、人がどのように検証し、理解するか
ここで確認
問い:W が 2000行2000列で、LoRA の B が2000行8列、A が8行2000列のとき、学習するパラメータの数は W 全体の何%でしょうか。
答え:W 全体は 2000 × 2000 = 4,000,000 個です。LoRA は 2000 × 8 + 8 × 2000 = 32,000 個です。32,000 ÷ 4,000,000 = 0.8% になります。
終章 物語を振り返る
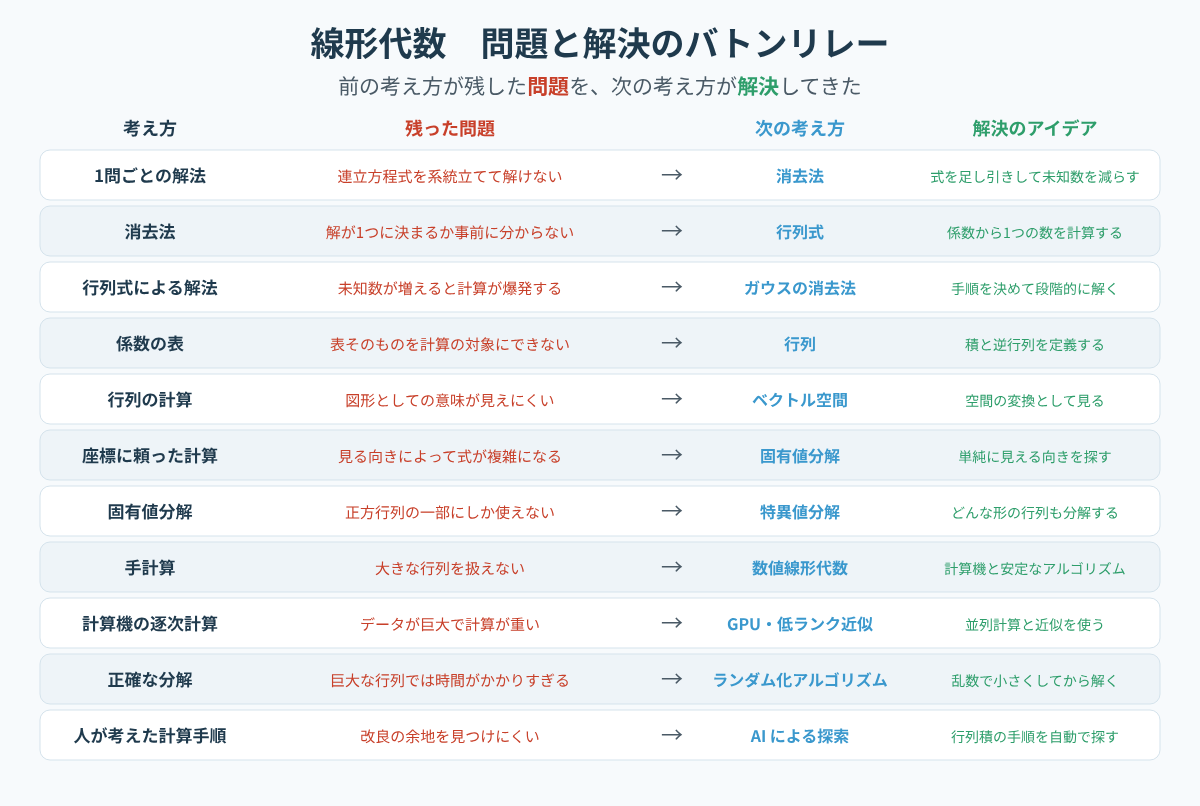
問題と解決のバトンリレー
8つの章を、「残った問題」と「解決のアイデア」の組み合わせで並べ直すと、次の図になります。
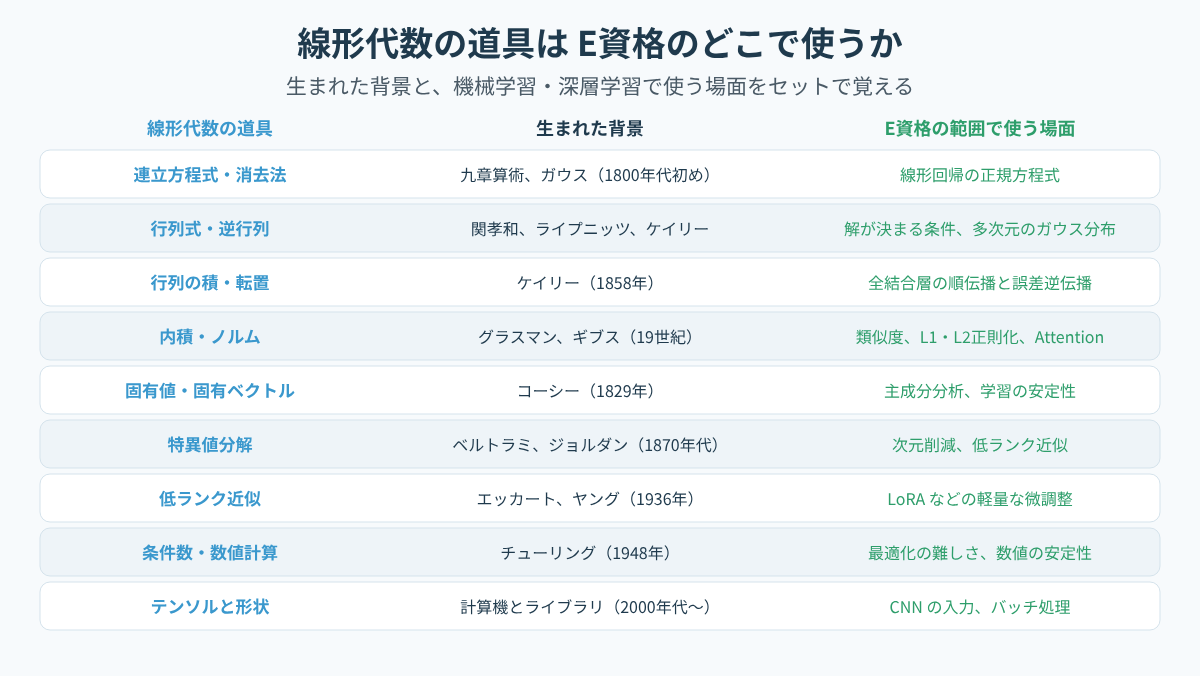
線形代数の道具と E資格の対応
線形代数の道具が、E資格の範囲のどこで使われるかを1枚にまとめました。「生まれた背景」と「使う場面」をセットにすると、計算の手順に意味が付き、記憶に残りやすくなります。
3つのパターン
約2000年の歴史から、3つのパターンが読み取れます。
1つ目は、行列の見方が広がってきたことです。最初は連立方程式の係数の表でした。次に、1つの文字で計算できる対象になり、空間を変形する働きになり、最後にはデータを入れる器になりました。新しい見方は、古い見方を捨てずに重ねられています。
2つ目は、「単純な部品に分解する」という発想が繰り返されることです。消去法は LU分解に、固有ベクトルを探す作業は固有値分解に、長方形の行列の分析は特異値分解になりました。LoRA も、変更分を2つの小さな行列の積に分ける分解です。難しい問題に出会ったら分解して考える、という姿勢が貫かれています。
3つ目は、計算の道具が理論を引っ張ってきたことです。算木、紙と鉛筆、計算機、GPU、そして AI と、道具が変わるたびに、扱える行列の大きさが変わり、新しい問題と新しい理論が生まれました。
確認問題
固有値分解と特異値分解について、正しい説明を1つ選んでください。
- 固有値分解は、行と列の数が異なる長方形の行列に対しても必ず行うことができる
- 特異値は、行列 A の転置と A の積の固有値の平方根として求めることができる
- 特異値分解で得られる特異値は、行列によっては負の数や複素数になることがある
- 大きい特異値の成分を捨てて小さい成分を残すと、元の行列の最良の近似になる
解答と解説
正解は 2 です。
- 1 は誤りです。固有値分解が使えるのは正方行列だけで、正方行列でも分解できないものがあります。長方形の行列にも使えるのは、特異値分解です
- 2 が正解です。A の転置と A の積は対称な正方行列になり、その固有値は 0 以上です。平方根をとったものが特異値です
- 3 は誤りです。特異値は、必ず 0 以上の実数になります。負の数や複素数になることがあるのは、固有値です
- 4 は誤りです。残すのは大きい特異値の成分です。大きい成分だけを残すと、同じランクの行列の中で、元の行列に最も近い近似が得られます
研修で使うときの進め方
講師向けに、この物語を研修で使う進め方の一例を示します。
- 「行列には3つの顔がある(係数の表、空間の変形、データの器)」と伝え、年表の図で全体像を見せる
- 未知数が2つの連立方程式を、消去法、クラメルの公式、逆行列の3つの方法で解いてもらい、同じ答えになることを確かめる
- 行列の積 AB と BA を計算してもらい、順番で結果が変わることを体験してもらう
- 内積、L1 ノルム、L2 ノルム、コサイン類似度を、2次元のベクトルで計算してもらう
- 方眼紙に (1, 1)、(1, -1)、(1, 0) を描き、行列を掛けた後の位置を描き込んでもらう。固有ベクトルの図で答え合わせをする
- 条件数の例(右辺を 0.001 変えると解が大きく変わる)を計算し、「ほぼ平行な2本の直線」の図で理由を説明する
- 全結合層の入力、重み、出力の形状を、受講者に書き出してもらう
- 線形代数の道具と E資格の対応の図を使い、各道具が使われる場面を受講者に説明してもらう
Python の演習と組み合わせる場合は、NumPy で行列の積、逆行列、固有値分解、特異値分解を実際に計算し、手計算の結果と比べる実習がおすすめです。画像を特異値分解し、残す特異値の数を 5、20、50 と変えて画質を比べると、低ランク近似の意味を目で確かめられます。
初学者がつまずきやすい点も挙げておきます。
- 行列の積を、同じ位置の成分どうしの掛け算だと考えてしまう
- 行列の積の順番を入れ替えても、同じ結果になると思い込む
- 固有値と特異値を混同する
- テンソルの形状を確かめずにコードを書き、形状が合わないエラーで手が止まる
まとめ
線形代数の歴史は、次の流れで整理できます。
- 古代の消去法から始まり、行列式が「解が1つに決まるか」を判定する道具になった
- ガウスが消去法を整理し、最小二乗法の計算を可能にした
- シルベスターとケイリーが行列を定義し、連立方程式や変換を1つの文字で扱えるようにした
- ベクトル空間の考え方が、行列に「空間を変形する」という意味を与えた
- 固有値分解と特異値分解が、行列の働きを単純な部品に分けて理解する方法を示した
- 計算機の登場で、丸め誤差と向き合う数値線形代数と、標準のライブラリが生まれた
- 行列はデータの器となり、ニューラルネットワークと GPU が行列の積を AI の中心に置いた
- 現在は、ランダム化、低ランク、低い精度、AI による探索によって、巨大な行列と向き合っている
計算の手順を1つずつ暗記するのではなく、「どの問題を解決するために生まれたのか」を軸にすると、受講者は行列の計算に意味を見いだせるようになります。
次の学習ステップとして、まず2行2列の行列で、行列の積、逆行列、固有値、特異値を手で計算してみてください。そのうえで、全結合層の順伝播と誤差逆伝播を行列の式で書き、形状を1つずつ確かめる練習へと進むと、E資格の深層学習の範囲につながっていきます。確率・統計の側の物語は、確率・統計の歴史の記事で確認できます。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 山崎講師2026年11月16日線形代数の歴史を物語で学ぶ|連立方程式から行列、固有値、特異値分解、GPU、AIによる行列積の高速化まで(E資格対応)
 山崎講師2026年11月16日確率・統計の歴史を物語で学ぶ|賭けの問題からベイズ則、最尤推定、エントロピー、MAP推定、不確実性の定量化まで(E資格対応)
 山崎講師2026年11月15日機械学習の歴史を物語で学ぶ|最小二乗法からパーセプトロン、決定木、SVM、ランダムフォレスト、勾配ブースティング、表形式基盤モデルまで
 山崎講師2026年11月15日オプティマイザの歴史を物語で学ぶ|勾配降下法からモーメンタム、AdaGrad、RMSProp、Adam、AdamW、Muonまで