強化学習の歴史を物語で学ぶ|効果の法則からDQN、AlphaGo、ChatGPT、DeepSeek-R1、AIエージェントまで
 山崎講師
こんにちは。ゆうせいです。
強化学習の研修で、DQN、PPO、AlphaZero、RLHF、GRPO といった名前を順番に紹介していくと、受講者は用語の多さに圧倒されてしまいます。ところが、それぞれの手法を「前の手法が抱えていた問題を、次の手法がどう解決したか」という流れで並べると、1本の物語として理解できるようになります。
今回は、強化学習の歴史を、その始まりから2026年の最新の動向まで、物語の形でたどります。各章の終わりには、受講者の理解を確かめる問いを用意しました。研修の導入や、E資格・G検定の学習の振り返りに活用してください。
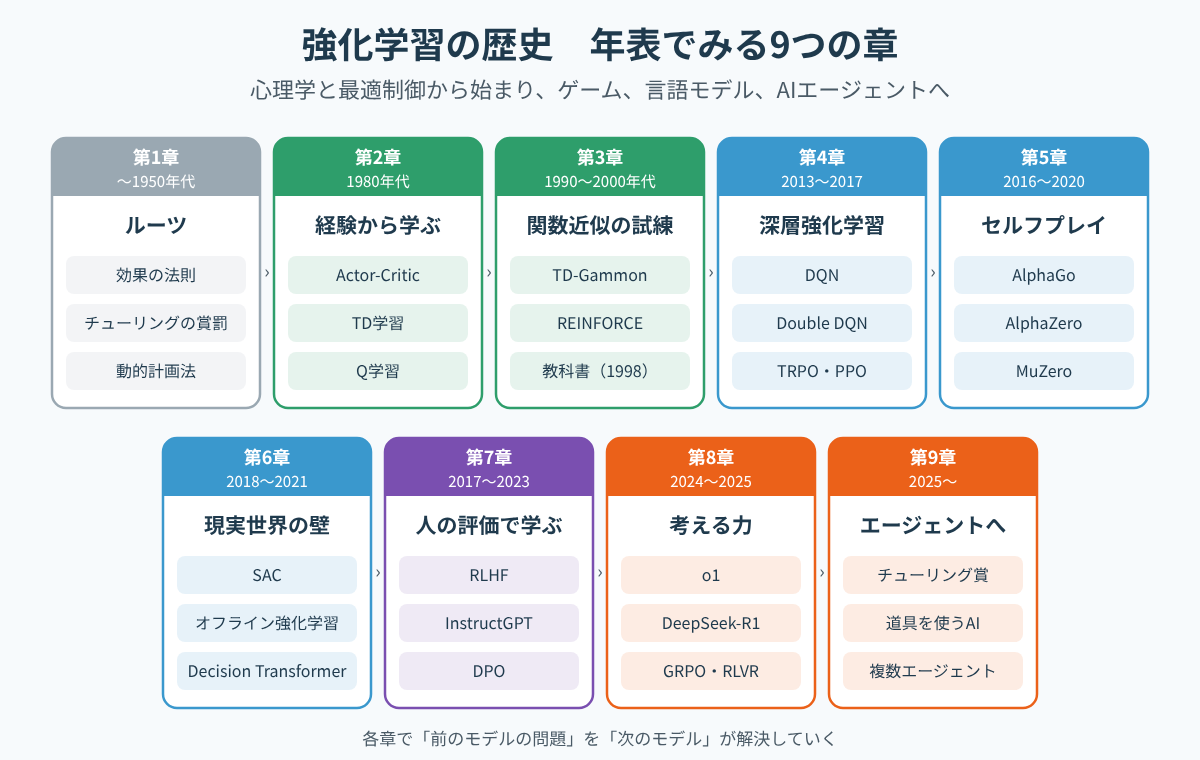
序章 強化学習とは何か
物語を始める前に、登場人物を紹介します。強化学習には、次の4つの要素が登場します。
- エージェント:学習する主体。ゲームのプレイヤーやロボット、AIモデルなど
- 環境:エージェントが働きかける世界。ゲームの盤面や現実の部屋など
- 行動:エージェントが選ぶ手。右に動く、石を置く、文章を書くなど
- 報酬:行動の結果として環境から返ってくる点数。良い結果ならプラス、悪い結果ならマイナス
強化学習の目的は、将来にわたって受け取る報酬の合計が最大になるような行動の選び方(方策)を、試行錯誤を通じて身に付けることです。正解の行動を1つずつ教えてもらう教師あり学習とは異なり、エージェントは「やってみて、結果を受け取り、次に生かす」ことを繰り返して学びます。
子どもが自転車に乗れるようになる過程を思い浮かべると分かりやすくなります。誰かが「ハンドルを何度傾けよ」と正解を教えるのではなく、転んだり進めたりした経験から、少しずつうまい乗り方を身に付けていきます。
第1章 ルーツ:心理学と最適制御(〜1950年代)
猫と迷路箱から始まった
強化学習の物語は、コンピュータが生まれる前、動物の学習を調べた心理学から始まります。19世紀の終わりごろ、アメリカの心理学者ソーンダイクは、猫を仕掛けのある箱に入れ、外に出るまでの様子を観察しました。猫は最初、でたらめに動き回りますが、偶然うまく仕掛けを動かして外に出ると、次からはその行動を早く取るようになりました。
ソーンダイクは、この観察から「満足のいく結果をもたらした行動は繰り返されやすくなる」という効果の法則をまとめました。良い結果につながった行動を強める、という強化学習の基本的な考え方は、ここに源流があります。
1950年には、アラン・チューリングが論文「計算する機械と知性」の中で、報酬と罰によって機械を教育するという考え方に触れています。
ベルマンの動的計画法
もう1つの源流は、最適制御という工学の分野です。1950年代、アメリカの数学者リチャード・ベルマンは、長い時間にわたる意思決定を、小さな問題に分けて解く動的計画法を考えました。その中心にあるのが、ベルマン方程式です。

各記号の意味は次のとおりです。
- V(s):状態 s の価値。その状態から最善の行動を取り続けたときに得られる報酬の合計の見込み
- a:行動
- R(s, a):状態 s で行動 a を取ったときにすぐ得られる報酬
- γ(ガンマ):割引率。0 から 1 の値で、将来の報酬をどれだけ重視するかを表す
- P(s' | s, a):状態 s で行動 a を取ったとき、次の状態が s' になる確率
この式は、「今の状態の価値は、今すぐもらえる報酬と、次の状態の価値の合計で決まる」という関係を表しています。将来の価値を少しずつ割り引いて今に引き寄せる考え方は、この後のすべての章に受け継がれていきます。
残された問題
動的計画法には、大きな問題がありました。式の中の P(s' | s, a)、つまり「ある行動をしたら次にどうなるか」という環境の仕組みを、あらかじめすべて知っている必要があったのです。
現実の世界では、環境の仕組みが完全に分かっていることはほとんどありません。さらに、状態の数が増えると計算量が急激に増える「次元の呪い」と呼ばれる問題も抱えていました。ベルマン自身がこの言葉を使ったことで知られています。
ここで確認
問い:動的計画法を現実の問題に使うとき、最も大きな壁になったのは何でしょうか。
答え:環境の仕組み(行動するとどの状態にどれだけの確率で移るか)を、あらかじめすべて知っている必要があったことです。
第2章 経験から学ぶ:TD学習とQ学習(1980年代)
バートとサットンの出会い
環境の仕組みを知らなくても学べる方法はないか。この問いに取り組んだのが、マサチューセッツ大学アマースト校のアンドリュー・バートと、その学生だったリチャード・サットンです。2人は心理学や神経科学の研究に刺激を受けながら、1980年代に強化学習の基本的な考え方とアルゴリズムを次々と発表しました。
1983年には、行動を選ぶ役(アクター)と、その行動を評価する役(クリティック)を分ける Actor-Critic の考え方を示しました。この「役割を分ける」発想は、約30年後の深層強化学習で再び主役になります。
TD学習:予想のズレから学ぶ
1988年、サットンは TD学習(Temporal Difference Learning:時間的差分学習)を発表しました。TD学習の考え方は、次の式で表せます。

各記号の意味は次のとおりです。
- V(s_t):時刻 t の状態の価値の予想
- α(アルファ):学習率。予想をどれだけ修正するかを決める小さな値
- r_{t+1}:1歩進んだときに得られた報酬
- かっこの中:1歩進んだ後の新しい見積もりと、元の予想とのズレ(TD誤差)
数値で確認します。今の状態の価値の予想が V(s) = 5 だったとします。1歩進むと報酬 1 を得て、次の状態の価値の予想は 10 でした。γ = 0.9、α = 0.1 とすると、新しい見積もりは 1 + 0.9 × 10 = 10 です。ズレは 10 - 5 = 5 なので、予想は 5 + 0.1 × 5 = 5.5 に更新されます。
天気予報にたとえると分かりやすくなります。月曜に「金曜は雨」と予想し、火曜に新しい情報で「金曜は晴れそう」と予想が変わったとします。金曜を待たなくても、火曜の時点で月曜の予想を修正できます。TD学習も同じように、最終的な結果を待たずに、1歩先の予想を使って今の予想を修正します。
この方法なら、環境の仕組みを知らなくても、実際に行動して得た経験だけで学習できます。第1章の問題を、TD学習は「経験から1歩ずつ学ぶ」ことで乗り越えました。
Q学習:行動の価値を直接学ぶ
1989年、イギリスのクリストファー・ワトキンスは、状態だけでなく「状態と行動の組み合わせ」の価値を学ぶ Q学習を発表しました。

Q(s, a) は、状態 s で行動 a を取ったときの価値です。次の状態で最も価値の高い行動(max の部分)を使って見積もるため、実際には探索のために別の行動を試していても、最善の行動の価値を学べるという特徴があります。
Q学習では、状態と行動の組み合わせごとに価値を記録した表(Qテーブル)を作り、経験するたびに表の値を更新していきます。
残された問題
Q学習には、表の大きさという問題がありました。迷路のマス目のように状態が少なければ表で管理できますが、ゲーム画面のように状態の数が膨大になると、表は現実的な大きさに収まりません。また、表では「少し違うけれど似ている状態」の経験を生かせないため、すべての状態を1つずつ経験しなければなりませんでした。
ここで確認
問い:TD学習は、動的計画法のどのような問題を解決したのでしょうか。
答え:環境の仕組みを知らなくても、実際の経験から得た報酬と1歩先の予想を使って、価値の予想を少しずつ修正できるようにしました。
第3章 関数近似の試練と冬の時代(1990〜2000年代)
TD-Gammon の成功
表の代わりに、ニューラルネットワークのような関数で価値を近似すれば、似た状態の経験を共有できます。1992年ごろ、IBM のジェラルド・テサウロは、TD学習とニューラルネットワークを組み合わせたバックギャモンのプログラム TD-Gammon を開発しました。TD-Gammon は自分自身との対戦を繰り返して学び、トップレベルの人間に近い強さに達しました。
同じ1992年には、ロナルド・ウィリアムズが、価値を経由せずに行動の選び方(方策)そのものを直接改善する方策勾配法の基本形 REINFORCE を発表しています。
うまくいかない組み合わせ
ところが、TD-Gammon の成功を他の問題で再現しようとすると、学習が不安定になり、価値の予想が発散してしまう例が次々と報告されました。
後にサットンとバートは、次の3つがそろうと学習が不安定になりやすいことを整理し、「致命的な三つ組(deadly triad)」と呼びました。
- 関数近似:ニューラルネットワークなどで価値を近似する
- ブートストラップ:TD学習のように、自分の予想を使って予想を更新する
- 方策オフ学習:Q学習のように、実際に取った行動とは別の方策について学ぶ
Q学習とニューラルネットワークの組み合わせは、まさにこの3つがそろう状態でした。
1998年、サットンとバートは教科書『Reinforcement Learning: An Introduction』を出版し、それまでの研究を体系的にまとめました。しかし、AI研究全体が停滞した時期とも重なり、強化学習が大きな注目を集めるまでには、さらに15年ほどの時間が必要でした。
ここで確認
問い:Q学習をニューラルネットワークと組み合わせると、どのような問題が起こりやすかったのでしょうか。
答え:学習が不安定になり、価値の予想が発散しやすいという問題です。関数近似、ブートストラップ、方策オフ学習の3つがそろうと起こりやすくなります。
第4章 深層強化学習の夜明け:DQNからPPOへ(2013〜2017)
DQN:不安定さを2つの工夫で抑える
2013年、イギリスの DeepMind 社は DQN(Deep Q-Network)を発表し、2015年に科学誌 Nature に論文が掲載されました。DQN は、ゲーム画面の画素だけを入力として、多くの Atari 2600 のゲームで人間のプロに匹敵する成績を上げました。
DQN の核心は、第3章の不安定さを抑える2つの工夫にありました。
- 経験再生(Experience Replay):経験をいったんメモリーにためておき、そこからランダムに取り出して学習する。連続した経験どうしの強い関連を断ち切り、学習を安定させる
- ターゲットネットワーク:予想の目標値を計算するネットワークを別に用意し、一定期間ごとにしか更新しない。追いかける目標が毎回動いてしまう問題を抑える
ターゲットネットワークは、動く的を射るのが難しいなら、的をしばらく止めておけばよい、という発想です。
次の問題と、次の解決
DQN にもいくつかの問題が見つかりました。
1つ目は、価値を高く見積もりすぎる過大評価の問題です。Q学習の max の計算では、たまたま高く予想された行動が選ばれやすいため、価値が全体的に高めにずれていきます。2015年の Double DQN は、行動を選ぶネットワークと、その価値を評価するネットワークを分けることで、この問題を和らげました。その後も、改良を組み合わせた Rainbow(2017年)などが続きます。
2つ目は、ロボットの関節の角度のように、行動が連続的な値になる問題が苦手なことです。DQN は「すべての行動の中から最大のものを選ぶ」ため、行動の候補が無数にあると計算できません。そこで、方策を直接出力する方策勾配法の流れが再び注目され、DDPG(2015年)や、複数の環境で並行して学ぶ A3C(2016年)が登場しました。
TRPO から PPO へ:更新しすぎない工夫
方策勾配法にも問題がありました。1回の更新で方策を大きく変えすぎると、それまでに身に付けた良い行動が壊れてしまい、学習が崩れることがあったのです。
2015年の TRPO(Trust Region Policy Optimization)は、更新前後の方策の違いが一定の範囲(信頼領域)に収まるように制約をかけて、この問題を解決しました。しかし、TRPO は計算が複雑で、実装しにくいという課題がありました。
2017年、OpenAI のジョン・シュルマンらは、PPO(Proximal Policy Optimization)を発表しました。PPO は、更新の幅を「クリップ(切り取り)」という簡単な操作で制限することで、TRPO に近い安定性を、はるかに簡単な実装で実現しました。PPO は扱いやすさから広く使われるようになり、後の章で言語モデルの学習にも使われます。
ここで確認
問い:DQN は、第3章で問題になった学習の不安定さを、どのような工夫で抑えたのでしょうか。
答え:経験をためてランダムに取り出して学ぶ経験再生と、目標値を計算するネットワークをしばらく固定するターゲットネットワークの2つです。
第5章 セルフプレイの時代:AlphaGo から MuZero へ(2016〜2020)
AlphaGo:人間の棋譜から出発する
囲碁は、盤面の組み合わせが極めて多く、コンピュータが人間のトップ棋士に勝つのはまだ先だと考えられていました。2016年3月、DeepMind の AlphaGo は、世界トップクラスの棋士である李世乭(イ・セドル)九段に4勝1敗で勝利しました。
AlphaGo は、まず人間の棋譜を使った教師あり学習で打ち方をまね、その後、自分自身との対局による強化学習で強くなりました。さらに、モンテカルロ木探索という先読みの方法を組み合わせていました。
AlphaGo Zero:人間の棋譜を使わない
AlphaGo には、人間の棋譜という大量のデータが必要という問題がありました。人間のデータがない問題には使えず、人間の打ち方の癖も引き継いでしまいます。
2017年に発表された AlphaGo Zero は、囲碁のルールだけを与え、人間の棋譜を一切使わずに、自分自身との対局(セルフプレイ)だけで学習しました。そして、以前の AlphaGo を上回る強さに達しました。同じ年に発表され、2018年に科学誌 Science に論文が掲載された AlphaZero は、同じ方法で囲碁・チェス・将棋の3つを学習しました。
MuZero:ルールすら教えない
AlphaZero にも、まだ前提が残っていました。先読みをするために、ゲームのルール(ある手を打つと盤面がどう変わるか)を正確に知っている必要があったのです。これは、第1章の動的計画法が抱えていた「環境の仕組みを知っている必要がある」という問題と同じ形をしています。
2019年に発表され、2020年に Nature に掲載された MuZero は、先読みに必要な環境のモデルも、経験から自分で学ぶようにしました。ルールを教えなくても、囲碁・チェス・将棋と Atari のゲームで高い成績を上げました。
同じ時期には、リアルタイム戦略ゲーム StarCraft II の AlphaStar や、チーム対戦ゲーム Dota 2 の OpenAI Five など、より複雑なゲームでも強化学習が成果を上げています。
ここで確認
問い:AlphaGo から AlphaGo Zero、さらに MuZero へと進む中で、「人間やルールから与えられるもの」はどのように減っていったでしょうか。
答え:AlphaGo は人間の棋譜とルールを使い、AlphaGo Zero は棋譜を使わずルールだけを使い、MuZero はルールも与えられずに環境のモデルを自分で学びました。
第6章 現実世界の壁(2018〜2021)
試行錯誤の回数という問題
ゲームでは、何百万回でも試行錯誤ができます。しかし、現実のロボットや医療、工場の制御では、失敗のたびに機械が壊れたり、危険が生じたりします。強化学習を現実世界で使うには、少ない試行で学ぶこと(サンプル効率)と、危険な試行をしないことが課題になりました。
2018年の SAC(Soft Actor-Critic)は、報酬に加えて「行動の多様さ」も評価に入れることで、探索と安定性のバランスを取り、ロボット制御などで少ない経験から効率よく学べることを示しました。
オフライン強化学習:過去のデータから学ぶ
さらに踏み込んだのが、新しく試行錯誤をせず、すでに集めたデータだけから学ぶオフライン強化学習です。ただし、データにない行動の価値を高く見積もってしまう問題があり、2020年の CQL(Conservative Q-Learning)は、データにない行動の価値を控えめに見積もることで対処しました。
2021年の Decision Transformer は、強化学習の問題を「過去の状態・行動・報酬の並びから、次の行動を予測する」という系列予測の問題として捉え直し、言語モデルと同じ Transformer で解く方法を示しました。強化学習と言語モデルの距離は、ここで一気に縮まります。
ここで確認
問い:ゲームでうまくいった強化学習を現実世界に持ち込むとき、何が課題になったのでしょうか。
答え:試行錯誤の回数を大幅に減らすこと(サンプル効率)と、危険な試行をせずに学ぶことです。過去のデータだけから学ぶオフライン強化学習は、その解決策の1つです。
第7章 人間の評価で学ぶ:RLHF から DPO へ(2017〜2023)
報酬をどう決めるかという問題
ゲームには勝ち負けという明確な報酬があります。しかし、「役に立つ文章を書く」「失礼のない返答をする」といった目標には、点数を計算する式がありません。報酬をうまく設計できないことは、強化学習が広い分野に使われるうえでの大きな壁でした。
2017年、OpenAI と DeepMind の研究者たちは、人間が2つの行動を見比べて「どちらが良いか」を選び、その好みから報酬を学ぶ方法を示しました。これが、人間のフィードバックによる強化学習(RLHF:Reinforcement Learning from Human Feedback)の出発点です。
InstructGPT と ChatGPT
2022年、OpenAI は RLHF を大規模言語モデルに使った InstructGPT を発表しました。手順は、大きく次の3段階です。
- 人間が書いた模範解答で、言語モデルを教師あり学習する
- 人間が複数の回答に順位を付けたデータから、回答の良さを点数にする報酬モデルを学習する
- 報酬モデルの点数が高くなるように、PPO を使って言語モデルを強化学習する
第4章で生まれた PPO が、ここで言語モデルの学習に使われました。同じ年の11月に公開された ChatGPT にも、同様の方法が使われています。強化学習は、ゲームの世界から、多くの人が毎日使う対話AIの中へと活躍の場を広げました。
DPO:強化学習の手順を省く
RLHF にも問題がありました。報酬モデルを別に学習し、さらに PPO で調整するため、手順が多く、計算資源も多く必要です。設定の調整も難しく、学習が不安定になることがありました。また、言語モデルが報酬モデルの弱点を突いて、中身が伴わないのに点数だけ高い回答を出す「報酬ハッキング」も問題になりました。
2023年に発表された DPO(Direct Preference Optimization)は、報酬モデルを明示的に作らず、「AとBではAが好まれた」という好みのデータから、言語モデルを直接学習する方法を示しました。数式の変形によって、強化学習のループを回さずに RLHF と同じ目的を達成できることを示した点が特徴です。手順が簡単になったことで、多くの研究や開発で使われるようになりました。
ここで確認
問い:RLHF の「報酬モデル」は、どのような問題を解決するために導入されたのでしょうか。
答え:「役に立つ文章」のように点数を計算する式がない目標について、人間の好みのデータから点数の付け方を学ぶためです。
第8章 考える力を育てる:o1、DeepSeek-R1、GRPO(2024〜2025)
人の評価に頼る限界
RLHF や DPO は、人間の好みに合った返答を学ぶのには役立ちました。しかし、数学の証明やプログラミングのように、正しさが重要な問題では、人間の好みは必ずしも正しさと一致しません。また、長い推論の正しさを人が判定するには、大きな手間と費用がかかります。
検証できる報酬(RLVR)
そこで注目されたのが、答えが正しいかどうかを自動で判定できる問題では、その判定結果をそのまま報酬にするという考え方です。数学なら答えが合っているか、プログラムならテストに合格するかを、プログラムで確かめられます。この方法は、検証可能な報酬による強化学習(RLVR:Reinforcement Learning with Verifiable Rewards)と呼ばれます。
2024年9月、OpenAI は、答える前に長く考える推論モデル o1 を発表し、強化学習によって考える過程を学ばせたことを説明しました。
2025年1月には、中国の DeepSeek 社が DeepSeek-R1 を発表しました。特に注目を集めたのが、その前段階の DeepSeek-R1-Zero です。R1-Zero は、模範的な推論の例を教師あり学習で与えず、正解かどうかと出力の形式だけを報酬にした強化学習によって、自分の答えを見直したり、長い推論を行ったりする振る舞いを身に付けました。
GRPO:評価役を置かない工夫
DeepSeek-R1 で使われた強化学習の方法が、GRPO(Group Relative Policy Optimization)です。GRPO は、DeepSeek 社が2024年に数学向けのモデル DeepSeekMath で導入した方法です。
PPO では、行動の良さを測る基準として、価値を予想する評価役(クリティック)のネットワークを別に学習します。大規模言語モデルでは、この評価役も巨大になり、計算資源を多く使います。
GRPO は、同じ問題に対して複数の回答を作らせ、そのグループの中での相対的な良さを基準にします。i 番目の回答の良さ(アドバンテージ)は、次のように計算します。

各記号の意味は次のとおりです。
- r_i:i 番目の回答の報酬
- mean(r):グループ内の報酬の平均
- std(r):グループ内の報酬の標準偏差(ばらつきの大きさ)
数値で確認します。同じ問題に4つの回答を作らせ、正解なら報酬 1、不正解なら 0 とします。結果が 1, 0, 0, 1 だった場合、平均は 0.5、標準偏差は 0.5 です。正解の回答のアドバンテージは (1 - 0.5)/0.5 = 1、不正解の回答は (0 - 0.5)/0.5 = -1 になります。正解した回答の出し方が強められ、不正解の回答の出し方が弱められます。
テストの採点にたとえると、絶対的な基準を作る係を置かずに、「同じ問題を解いたクラスの平均より良かったか」で評価する方法です。第2章でバートとサットンが示した Actor-Critic の「評価役」を、あえて置かない選択をした点が興味深いところです。
残された問題
推論モデルにも課題は残っています。報酬を得るために推論が不必要に長くなる、検証の抜け穴を突いて報酬だけを得ようとする(報酬ハッキング)、答えが自動で検証できない問題には使いにくい、といった点です。DeepSeek-R1 では、強化学習の前に少量の推論例で教師あり学習を行い、読みにくい出力などの問題を和らげています。
ここで確認
問い:GRPO は、PPO と比べて何を省いたのでしょうか。また、その代わりに何を基準にしたのでしょうか。
答え:価値を予想する評価役(クリティック)のネットワークを省きました。その代わりに、同じ問題に対する複数の回答のグループ内での平均とばらつきを基準にしています。
第9章 エージェントの時代へ(2025〜)
チューリング賞
2025年3月、計算機科学の分野で最も権威のある賞の1つ、ACM チューリング賞(2024年度)が、アンドリュー・バートとリチャード・サットンに贈られることが発表されました。授賞理由は、強化学習の概念とアルゴリズムの基礎を築いたことです。第2章で登場した2人の40年以上にわたる研究が、言語モデルの時代に改めて評価されました。
1問1答から、長い仕事へ
2025年から2026年にかけて、強化学習の主な舞台は、1問に1回答えるタスクから、AIエージェントへと広がっています。AIエージェントは、検索やプログラムの実行などの道具を使いながら、何十、何百もの手順を重ねて仕事を進めます。ソフトウェア開発や調査の支援、複数のエージェントが役割を分担して協力する仕組みなどで、強化学習を使った研究が盛んに行われています。
新しい問題:どの手順が良かったのか
エージェントの強化学習では、古くからある問題が、より大きな形で現れています。長い手順の最後に「成功」か「失敗」かの報酬しか得られない場合、どの手順が成功に貢献し、どの手順が失敗の原因だったのかが分かりにくいのです。この問題は信用割り当て(credit assignment)の問題と呼ばれます。
現在は、最後の結果だけでなく途中の手順ごとに評価を与える方法や、複数のエージェントのうち誰の貢献が大きかったかを見積もる方法などが研究されています。また、実際に使われているエージェントが、自分の経験から継続的に学び続ける仕組みも議論されています。
第2章の TD学習は「最終結果を待たずに、1歩ごとに予想を修正する」方法でした。エージェントの時代の課題は、その考え方を、言語モデルが行う長い仕事の中でどう実現するかという問いだと言えます。物語は、始まりの問いに戻りながら、新しい章を書き続けています。
ここで確認
問い:AIエージェントの強化学習で大きな課題になっている「信用割り当て」とは、どのような問題でしょうか。
答え:長い手順の最後にしか報酬が得られない場合に、どの手順が成功や失敗にどれだけ貢献したのかを判断しにくいという問題です。
終章 物語を貫くパターン
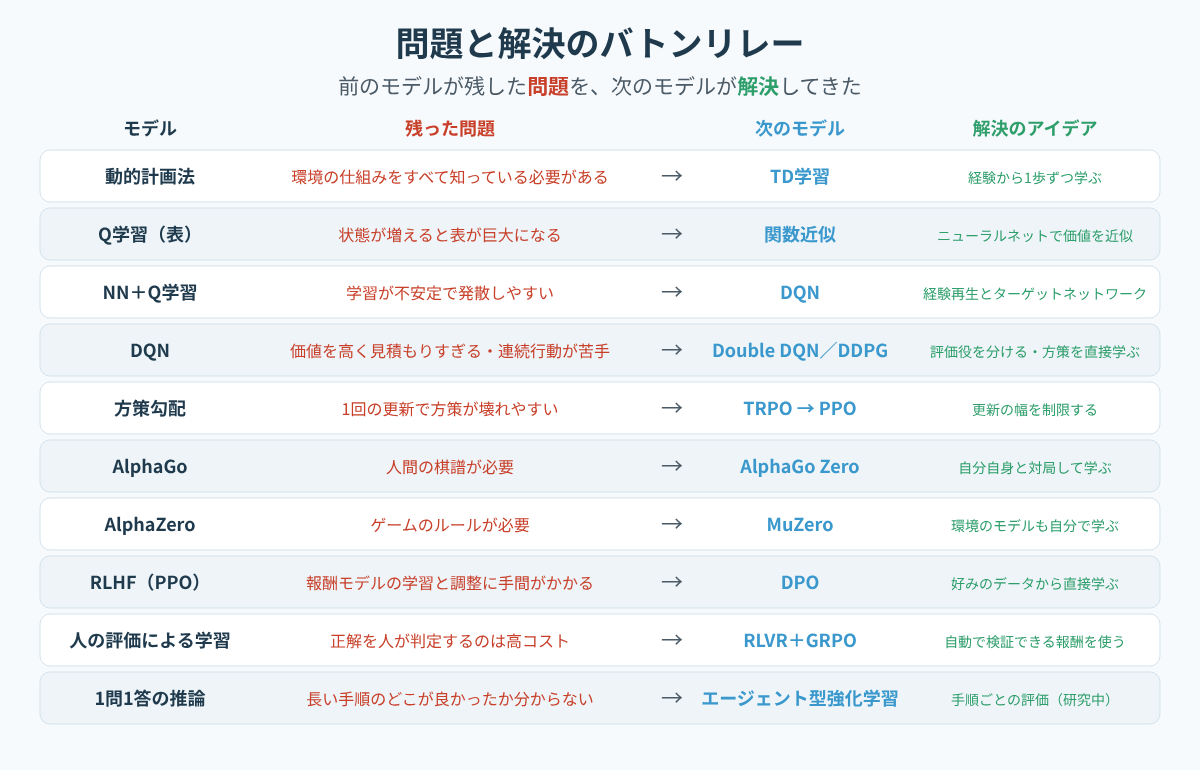
70年以上にわたる強化学習の歴史を振り返ると、同じパターンが繰り返されていることに気付きます。
- 新しい手法が、前の手法の問題を解決する
- その手法を広い問題に使うと、新しい問題が見つかる
- 次の手法が、その問題を解決する
そして、いくつかの考え方は形を変えて何度も登場します。ベルマン方程式の「将来の価値を今に引き寄せる」考え方、Actor-Critic の「行動役と評価役を分ける」考え方、TRPO や PPO の「更新しすぎない」考え方は、最新の言語モデルの学習にも受け継がれています。
研修では、新しい手法を紹介するときに「この手法は、どの問題を解決するために生まれたのか」「この手法には、どのような問題が残っているのか」の2つを必ず問いかけてみてください。受講者は、用語を暗記するのではなく、手法どうしのつながりとして理解できるようになります。
確認問題
強化学習の歴史について、正しい説明を1つ選んでください。
- Q学習は、ニューラルネットワークと組み合わせることで最初から安定して学習できた
- MuZero は、ゲームのルールを与えられずに環境のモデルを自分で学んだ
- DPO は、報酬モデルを学習してから PPO で言語モデルを調整する方法である
- GRPO は、PPO よりも大きな評価役のネットワークを追加した方法である
解答と解説
正解は 2 です。
- 1 は誤りです。Q学習とニューラルネットワークの組み合わせは不安定になりやすく、DQN の経験再生とターゲットネットワークによって安定化されました
- 2 は正しい説明です。AlphaZero はルールを必要としましたが、MuZero は先読みに使う環境のモデルも経験から学びました
- 3 は誤りです。報酬モデルと PPO を使うのは RLHF です。DPO は報酬モデルを明示的に作らず、好みのデータから直接学習します
- 4 は誤りです。GRPO は評価役のネットワークを省き、グループ内の回答の比較を基準にしました
研修で使うときの進め方
講師向けに、この物語を研修で使う進め方の一例を示します。
- 序章の4つの要素(エージェント・環境・行動・報酬)を、身近な例で確認する
- 年表の図を示し、9つの章の全体像を先に見せる
- 各章を「主人公(手法)」「立ちはだかった壁(問題)」「次の主人公への引き継ぎ(解決)」の3点で説明する
- 各章の「ここで確認」の問いを、個人またはペアで答えてもらう
- 問題と解決のバトンリレーの図を使い、章どうしのつながりを振り返る
- グループワークとして、「エージェントの信用割り当ての問題を、自分ならどう解決するか」を話し合ってもらう
最後のグループワークには正解がありません。歴史の流れを踏まえて、次の章を自分たちで考える体験は、受講者が強化学習を自分のこととして捉えるきっかけになります。
まとめ
- 強化学習は、心理学の効果の法則と、ベルマンの動的計画法という2つの源流から始まった
- TD学習とQ学習は、環境の仕組みを知らなくても経験から学べるようにした
- DQN は経験再生とターゲットネットワークで深層学習との組み合わせを安定させ、PPO は更新幅の制限で方策の学習を安定させた
- AlphaGo から MuZero への流れで、人間の棋譜やゲームのルールへの依存が減っていった
- RLHF は人間の好みを報酬にし、DPO はその手順を簡単にした
- RLVR と GRPO は、自動で検証できる報酬によって推論の力を伸ばした
- 現在は、AIエージェントの長い手順における信用割り当てが大きな課題になっている
次の学習ステップとしては、この物語に登場したベルマン方程式、TD誤差、方策勾配の数式を、1つずつ手で計算してみる流れをおすすめします。物語で流れをつかんだ後に数式に取り組むと、それぞれの式が「どの問題を解決するために生まれたのか」を意識しながら学べます。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 山崎講師2026年11月15日機械学習の歴史を物語で学ぶ|最小二乗法からパーセプトロン、決定木、SVM、ランダムフォレスト、勾配ブースティング、表形式基盤モデルまで
 山崎講師2026年11月15日オプティマイザの歴史を物語で学ぶ|勾配降下法からモーメンタム、AdaGrad、RMSProp、Adam、AdamW、Muonまで
 山崎講師2026年11月15日ディープラーニングの歴史を物語で学ぶ|パーセプトロンから誤差逆伝播法、2度の冬、AlexNet、Transformer、基盤モデルまで
 山崎講師2026年11月15日コンピュータビジョンの歴史を物語で学ぶ|猫の脳の実験からAlexNet、ResNet、YOLO、ViT、CLIP、SAM、ロボットの目まで