Scaled Dot-Product Attentionにおけるkey次元スケーリングの公式と覚え方
 山崎講師
こんにちは。ゆうせいです。
自然言語処理や深層学習の基盤モデルとして広く使われるTransformerには、入力された単語同士の関連度を計算する仕組みとしてScaled Dot-Product Attentionが組み込まれています。
この計算過程において、ベクトルの内積値をkeyの次元数の平方根で割る「スケーリング」という処理が行われます。一見すると唐突に現れる平方根の割り算ですが、確率の計算を安定させるための明確な統計的背景が存在します。
本記事では、key次元に応じた内積スケーリングの基本概念から公式の構造、覚え方、利点と留意点、そして理解を深める学習の手順を解説します。
内積スケーリングの基本概念
Transformerの注意機構では、Query(検索の手がかり)とKey(照合対象のインデックス)という2つのベクトルの内積を計算し、どの単語に注目すべきかを表すスコアを算出します。
内積スケーリングとは、算出した内積の値をKeyベクトルの次元数 d_k の平方根で割る操作を指します。
テストの合計点による比喩
高校の定期試験を想定します。1科目あたり平均50点、点数のばらつきが一定の試験があると仮定します。
試験が国語の1科目だけであれば、生徒ごとの点数のばらつきは標準的な範囲に収まります。しかし、試験科目を5科目、10科目、20科目と増やして合計点で比較する場合を考えます。科目数が多くなるほど、得意な生徒と苦手な生徒の総合得点の差は開いていき、合計点のばらつきは科目数の増加に比例して大きくなります。
ベクトルの内積も同様です。次元数(要素の個数)が大きくなると、各要素の掛け算を足し合わせた合計値のばらつきが肥大化します。内積スケーリングは、増えた科目数の影響を抑えて、常に1科目分のばらつきと同じ水準に数値を揃える調整作業に相当します。
構成する記号の整理
公式に登場する記号の意味を整理します。
- Q:検索の入力を表すQuery行列
- K:参照先の情報を表すKey行列
- d_k:Keyベクトルの次元数(要素の数)
- softmax:数値を合計が1になる確率値へ変換する関数
スケーリングの公式と構造の分解
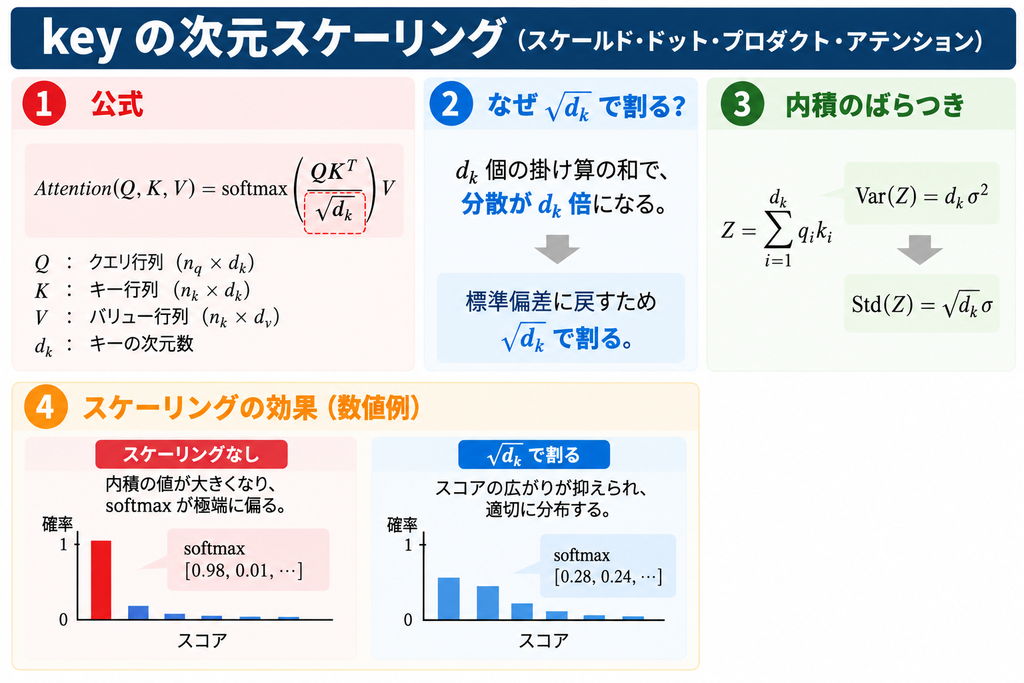
Scaled Dot-Product Attentionの計算式は次の通りです。

この式の中核にある分数が、key次元に応じたスケーリング部分です。

なぜ次元数そのものではなく平方根で割るのか
この計算の目的は、内積値の「分散(ばらつき)」を1に保つことです。
QueryとKeyの各要素が、平均0、分散1の独立した標準正規分布に従っていると仮定します。
2つの要素を掛け合わせた値の分散も1になります。
次元数が d_k 個ある場合、内積は d_k 個の数値を足し合わせる計算となるため、足し合わされた全体の分散は d_k 倍に増大します。
統計学の規則において、分散が d_k であるデータの散らばりの幅(標準偏差)は、分散の平方根をとった次の値になります。

データの広がり具合を表す標準偏差が根号 d_k となるため、数値をこの標準偏差で割ることで、次元数 d_k がどれほど大きくなっても、内積値の分散を常に1に保つことができます。
公式の覚え方
公式の分母を記憶する際は、統計学における標準偏差の導出と結びつける方法が適しています。
- 足し算の個数:d_k 個の掛け算を足すため、ばらつき(分散)は d_k 倍になる
- 割るべき数値:ばらつきの単位(標準偏差)に戻すため、平方根をとった根号 d_k で割る
「次元の数だけ分散が増えるため、標準偏差であるルート次元で割って整える」という統計的な因果関係を把握しておくと、単なる d_k ではなく根号を付ける理由を自然に思い出すことができます。
内積スケーリングの利点と留意点
内積値をスケーリングする処理には、数理的な利点と運用上の性質が存在します。
利点
- 勾配消失問題の防止内積の分散が大きくなりすぎると、極端に大きな正の数値や負の数値が発生します。この数値をsoftmax関数に入力すると、最大値の部分だけが1に近づき、他の部分はほぼ0になります。この状態ではsoftmax関数の傾き(勾配)が極めて微小になり、逆伝播時に重みが更新されなくなる勾配消失が発生します。スケーリングによって入力値の大きさを制御することで、勾配が消失せず健全に学習が進みます。
- モデルの大規模化への耐性モデルの表現力を高めるために隠れ層の次元数 d_k を512や1024へと拡張しても、スケーリング処理が入っているため、次元数の違いによる勾配の挙動の変化を抑えることができます。
留意点
- 次元数が極めて小さい環境での効果の限定性d_k の値が小さい場合、内積値の分散も大きく広がらないため、スケーリングによる数値の補正効果は小さくなります。
- 要素の独立性という仮定との乖離各要素が独立かつ同一の分布に従うという数理的な前提のもとで設計されていますが、実際のモデル学習における重みや入力データは完全な独立性を満たさない場合があり、分散が厳密に1に保たれるとは限らない側面があります。
まとめ
key次元に応じた内積スケーリングは、Attention機構の学習を安定させるための処理です。
- 内積は要素の積を足し合わせるため、次元数 d_k に比例して分散が大きくなる
- 分散 d_k の標準偏差に相当する根号 d_k で割ることで、ばらつきを標準化する
- softmax関数に入力される値の肥大化を防ぎ、学習時の勾配消失を回避する
内積スケーリングの理解を確実なものにするためには、次の順序に沿って学習を進める方法を推奨します。
- 2次元や3次元の簡単なベクトルを用意し、手計算で通常の内積とスケーリング後の値を算出する。
- softmax関数に極端に大きな値(例:10や50)を入力した際の出力結果と微分値の挙動を確認し、勾配消失の発生過程を確かめる。
- 2つの独立な正規分布の積の期待値と分散の計算ルールを確認し、d_k 個の和をとったときに分散が d_k になる数理的な証明を追う。
- Multi-Head Attention全体の構造へと学習範囲を広げ、全体の次元数 d_model と分割された各ヘッドの次元数 d_k の関係性を整理する。
投稿者プロフィール