機械学習の歴史を物語で学ぶ|最小二乗法からパーセプトロン、決定木、SVM、ランダムフォレスト、勾配ブースティング、表形式基盤モデルまで
 山崎講師
こんにちは。ゆうせいです。
機械学習の研修では、線形回帰、ロジスティック回帰、決定木、SVM、ランダムフォレスト、勾配ブースティングと、多くの手法が次々に登場します。受講者から「手法が多すぎて、違いが分かりません」「結局どれを使えばよいのですか」と質問された経験のある講師の方は多いのではないでしょうか。
機械学習の手法は、一覧表で覚えようとすると大変です。しかし、「前の手法が抱えていた問題を、次の手法がどのように解決したか」という順番で並べると、1本の物語として理解できます。今回は、1805年の最小二乗法から2026年の表形式基盤モデルまで、約220年の歴史を8つの章でたどります。研修でそのまま話せるように、各章に数値例と確認の問いを付けました。
序章 機械学習とは何か
コンピュータに仕事をさせる方法は、大きく2つあります。
- 人がルールを書く方法:「件名に『当選』があれば迷惑メールとする」のような条件を、人が1つずつプログラムに書く
- データから学ばせる方法:迷惑メールと通常のメールの例を大量に見せて、見分ける規則をコンピュータ自身に見つけさせる
後者が機械学習です。料理にたとえると、レシピを細かく書いて渡すのが前者、完成した料理をたくさん食べさせて作り方を身に付けさせるのが後者にあたります。
機械学習の歴史には、何度も登場する3つの課題があります。この3つを先に押さえておくと、物語が追いやすくなります。
- 表現力:複雑な規則を表せるか。直線しか引けないモデルは、曲がった境界を表せません
- 汎化:学習に使っていない新しいデータでも当たるか。学習用のデータだけに合わせすぎる状態を過学習と呼びます
- 手間:人が決めなければならない部分がどれだけあるか。ルール、特徴量、モデルの設定など、人の作業は少ないほうが使いやすくなります
なお、この記事は、正解の付いたデータから学ぶ教師あり学習を中心に扱います。強化学習、生成モデル、ディープラーニングの歴史は、それぞれ別の記事で詳しく紹介しています。
第1章 統計学という源流(1805〜1936)
点の集まりに直線を当てはめる
物語は、コンピュータが生まれる140年ほど前から始まります。1805年、フランスの数学者ルジャンドルが最小二乗法を発表しました。ドイツの数学者ガウスも同じ時期に同じ方法を使っており、天体の軌道を観測データから求める計算に役立てました。
最小二乗法は、点の集まりに最もよく合う直線を求める方法です。直線と各点のずれ(誤差)を2乗して合計し、合計が最も小さくなる直線を選びます。直線を y = ax + b と書くと、傾き a は次の式で求められます。

x_i と y_i は i 番目のデータ、x と y の上に線が付いた記号はそれぞれの平均です。切片 b は、y の平均から a と x の平均の積を引いて求めます。
数値で確かめましょう。データが (1, 1)、(2, 4)、(3, 4) の3点だとします。x の平均は 2、y の平均は 3 です。
- 分子:(1 - 2) × (1 - 3) + (2 - 2) × (4 - 3) + (3 - 2) × (4 - 3) = 2 + 0 + 1 = 3
- 分母:(1 - 2) の2乗 + (2 - 2) の2乗 + (3 - 2) の2乗 = 1 + 0 + 1 = 2
- 傾き a = 3 ÷ 2 = 1.5、切片 b = 3 - 1.5 × 2 = 0
求めた直線は y = 1.5x です。x が 4 のときの予測は 6 になります。「データから式の係数を決め、新しい入力に対して予測する」という流れは、現在の機械学習とまったく同じです。
その後、1886年にゴルトンが親子の身長の関係を調べて「回帰」という言葉を生み、1936年にはフィッシャーが、アヤメの花の測定値から品種を見分ける線形判別分析を発表しました。予測(回帰)と分類という、機械学習の2つの基本的な課題は、統計学の中ですでに形になっていたのです。
残された問題
この時代の方法には、2つの限界がありました。
- 式の形は人が決める:直線を当てはめるのか、曲線を当てはめるのか、どの変数を使うのかは、分析する人が考える必要がありました
- 計算は手作業:変数やデータが増えると、計算の量が急に増えます
ここで確認
問い:最小二乗法で、誤差をそのまま合計せずに2乗してから合計するのはなぜでしょうか。
答え:誤差にはプラスとマイナスがあり、そのまま合計すると打ち消し合ってしまうためです。2乗するとすべて0以上の値になり、ずれの大きさを正しく合計できます。
第2章 学習する機械の誕生(1950年代〜)
経験から強くなるプログラム
1940年代にコンピュータが登場すると、「機械は学習できるか」という問いが現実のものになりました。1950年、チューリングは論文の中で、大人の知能を最初から作るのではなく、子どもの心を作って教育するという考え方を示しています。
IBMの研究者アーサー・サミュエルは、チェッカーというボードゲームのプログラムを作りました。プログラムは自分自身と対戦を繰り返し、盤面の良し悪しを評価する式を少しずつ直していきます。やがてプログラムは、作者のサミュエル本人より強くなりました。サミュエルが1959年の論文で使った machine learning という言葉が、機械学習という名前が広まるきっかけになったとされています。
パーセプトロン:誤りを見て重みを直す
1957年、心理学者のローゼンブラットがパーセプトロンを提案しました。脳の神経細胞をまねたモデルで、入力に重みを掛けて合計し、合計が0より大きければ1、そうでなければ0を出力します。
パーセプトロンの新しさは、重みを自動で直す規則にありました。

w は重み、x は入力、t は正解、y はモデルの出力、η(イータ)は学習率(1回に直す量)です。正解と出力が同じなら t - y は0になり、重みは変わりません。間違えたときだけ、正解に近づく向きに重みが動きます。
数値例を見てみましょう。重みが (0.2, -0.4)、入力が (1, 1)、正解が 1、学習率が 0.5 だとします。
- 合計:0.2 × 1 + (-0.4) × 1 = -0.2。0以下なので出力は 0(不正解)
- 更新:t - y = 1 なので、重みに 0.5 × 1 × (1, 1) = (0.5, 0.5) を足す
- 新しい重み:(0.7, 0.1)。合計は 0.8 になり、出力は 1(正解)
第1章の方法では、人が式を立てて一度に解を求めました。パーセプトロンは、例を1つずつ見ながら少しずつ賢くなります。「学習する機械」が本当に動いたのです。
同じ頃、もう1つの単純な方法も研究されました。k近傍法です。新しいデータが来たら、過去のデータの中から最も近い k 個を探し、多数決で答えを決めます。1967年にカバーとハートが性質を理論的に分析しました。
残された問題
1969年、ミンスキーとパパートは著書の中で、パーセプトロンの限界を数学的に示しました。パーセプトロンが引ける境界は直線だけです。そのため、「2つの入力のうち片方だけが1のときに1を出す」という XOR(排他的論理和)のような単純な問題さえ解けません。
4つの点 (0, 0)、(0, 1)、(1, 0)、(1, 1) を紙に描き、(0, 1) と (1, 0) だけを丸で囲んでみてください。丸の付いた点と付いていない点を1本の直線で分けることはできないと分かります。
この指摘をきっかけに、ニューラルネットワークの研究は長い停滞期に入りました。k近傍法にも、予測のたびに全データと比べるため遅い、変数が多いと「近さ」が意味を持ちにくくなる、という問題が残りました。
ここで確認
問い:パーセプトロンは、正しく答えられたデータに対して重みをどのように更新するでしょうか。
答え:更新しません。正解 t と出力 y が同じなので t - y が0になり、重みに足す量が0になるためです。
第3章 ルールを自分で作る木(1980年代)
エキスパートシステムの壁
1970年代から1980年代にかけて、AIの主役はエキスパートシステムでした。医師などの専門家の知識を「もし〜ならば〜」というルールにして大量に登録し、専門家のように判断させる仕組みです。
ところが、大きな壁がありました。専門家から知識を聞き出してルールに書き起こす作業に、膨大な時間がかかったのです。専門家自身も、自分の判断の理由をすべて言葉にできるわけではありません。この問題は「知識獲得のボトルネック」と呼ばれました。
決定木:データからルールを作る
「ルールを人が書くのが大変なら、データから自動で作ればよい」。この発想で生まれたのが決定木です。1984年にブレイマンらが CART を、1986年にキンランが ID3 を発表しました。
決定木は、「年齢は30歳以上か」「購入回数は3回以上か」のような質問を順番に行い、データを分けていきます。出来上がった木は「もし〜ならば〜」のルールの集まりなので、人が読んで理解できます。
よい質問とは、分けた後のグループができるだけ「同じ答えのデータだけ」になる質問です。グループの混ざり具合は、ジニ不純度で測ります。

p_k は、グループの中でクラス k が占める割合です。1種類だけなら G は 0、2種類が半分ずつなら G は 0.5 になります。
数値例です。「購入した」5人と「購入しなかった」5人の合計10人がいるとします。
- 分ける前:G = 1 - (0.5 の2乗 + 0.5 の2乗) = 0.5
- ある質問で分けた結果、左のグループが4人(購入4人、非購入0人)、右のグループが6人(購入1人、非購入5人)になった
- 左:G = 0。右:G = 1 - ((1/6) の2乗 + (5/6) の2乗) = 約 0.278
- 人数で重みを付けた平均:0.4 × 0 + 0.6 × 0.278 = 約 0.167
不純度は 0.5 から 0.167 に下がりました。決定木は、すべての質問の候補についてこの計算を行い、最も不純度が下がる質問を選びます。
決定木は、パーセプトロンが解けなかった XOR も解けます。「1つ目の入力は1か」と聞いた後に「2つ目の入力は1か」と聞けば、4つの点を正しく分けられるからです。
同じ1986年には、ラメルハート、ヒントン、ウィリアムズが誤差逆伝播法を広め、層を重ねたニューラルネットワークでも XOR が解けるようになりました。ニューラルネットワークのその後は、ディープラーニングの歴史の記事で扱っています。
残された問題
決定木には、はっきりした弱点がありました。
- 過学習しやすい:質問を重ねて木を深くすると、学習用のデータを1件ずつ覚えるような細かいルールができてしまいます
- 結果が不安定:学習用のデータが少し変わるだけで、最初の質問が変わり、まったく違う木になることがあります
ここで確認
問い:10人のグループが「購入した」9人と「購入しなかった」1人に分かれているとき、ジニ不純度はいくつでしょうか。
答え:G = 1 - (0.9 の2乗 + 0.1 の2乗) = 1 - (0.81 + 0.01) = 0.18 です。半分ずつの 0.5 より小さく、かなり純粋なグループだと分かります。
第4章 理論の裏づけと SVM(1990年代)
なぜ未知のデータに当たるのか
ここまでの手法は、「やってみたらうまくいった」という経験に支えられていました。学習用のデータで正解できることと、未知のデータで正解できることは別の話です。両者の関係を数学で説明しようとする研究が、1980年代から進みました。ヴァプニクらの理論や、1984年にヴァリアントが示した学習の理論です。
理論から得られた教訓の1つは、「学習用のデータに合っていて、しかも単純なモデルほど、未知のデータにも当たりやすい」という点でした。
マージンを最大にする
この考え方を形にしたのが、サポートベクターマシン(SVM)です。1992年にボーザー、ギヨン、ヴァプニクが基本の形を発表し、1995年にコルテスとヴァプニクが、多少の誤りを許す現在の形にしました。
2つのクラスを分ける直線は、ふつう何本も引けます。SVM は、その中から「両方のクラスの最も近い点までの距離が最大になる直線」を選びます。道路にたとえると、2つの集団の間に、できるだけ幅の広い道路を通すイメージです。道路の幅をマージンと呼びます。
境界を w・x + b = 0 と書いたとき、マージンは次の式で表されます。

w は境界の向きを決める重みのベクトル、分母は w の長さです。w が (3, 4) なら、長さは 9 + 16 = 25 の平方根で 5、マージンは 2 ÷ 5 = 0.4 になります。w の長さを小さくするほど、マージンは広がります。
パーセプトロンは「分けられればどの直線でもよい」という立場でした。SVM は「最も余裕のある直線」を選ぶことで、未知のデータへの強さを手に入れたのです。
カーネルトリック:曲がった境界を引く
直線しか引けない問題は、カーネルトリックで解決されました。データをもっと次元の高い空間に移すと、元の空間では直線で分けられなかったデータが、平らな面で分けられるようになります。机の上に混ざって置かれた赤と青のビー玉を、赤だけ持ち上げれば、間に1枚の板を差し込めるのと同じ考え方です。
高い次元に移す計算は大変ですが、SVM の計算に必要なのは、2つのデータの内積(似ている度合い)だけです。カーネル関数を使うと、実際にデータを移さなくても、移した先での内積を直接計算できます。代表的な RBF カーネルは次の式です。

x と z は2つのデータ、γ(ガンマ)は「近い」とみなす範囲を決める値です。x が (1, 2)、z が (2, 4)、γ が 0.1 のとき、距離の2乗は 1 + 4 = 5 なので、K = exp(-0.5) = 約 0.607 です。2つのデータが同じなら 1、遠く離れるほど 0 に近づきます。
1990年代後半から2000年代にかけて、SVM は文字認識や文書分類などで高い精度を出し、機械学習の主役になりました。
残された問題
- データが増えると遅い:すべてのデータの組み合わせについてカーネルを計算するため、データが数十万件を超えると学習が難しくなります
- カーネルと特徴量は人が選ぶ:どのカーネルを使うか、画像や文章からどのような数値(特徴量)を取り出すかは、人が設計する必要がありました
ここで確認
問い:w が (6, 8) のとき、マージンはいくつでしょうか。w が (3, 4) のときと比べて、広いでしょうか、狭いでしょうか。
答え:w の長さは 36 + 64 = 100 の平方根で 10、マージンは 2 ÷ 10 = 0.2 です。w が (3, 4) のときの 0.4 より狭くなります。
第5章 多数の力を集める:アンサンブル(1995〜2001)
バイアスとバリアンス
第3章で、決定木は過学習しやすく不安定だと述べました。この弱点を理解するために、予測の誤差を3つに分ける考え方を紹介します。

左辺は予測の誤差(2乗)の平均です。右辺の Bias(バイアス)は予測の平均が正解からずれている大きさ、Var(バリアンス)は学習用のデータが変わったときに予測がばらつく大きさ、σ の2乗はデータに含まれるノイズで、どのモデルでも減らせません。たとえば、バイアスが 2、バリアンスが 3、ノイズが 1 なら、誤差は 4 + 3 + 1 = 8 です。
的当てにたとえると、バイアスが大きいモデルは「いつも的の左上に集まる」状態、バリアンスが大きいモデルは「的の周りに広く散らばる」状態です。直線のモデルはバイアスが大きく、深い決定木はバリアンスが大きくなります。
バギングとランダムフォレスト
バリアンスを減らす方法を示したのが、決定木の生みの親の一人であるブレイマンです。1996年に発表したバギングは、学習用のデータから重複を許して無作為に取り出したデータで木を何本も作り、予測の平均(分類なら多数決)をとります。1人の意見はばらついても、多くの人の平均は安定する、という考え方です。
ただし、木どうしが似ていると、平均をとっても効果は限られます。n 本の木の平均のバリアンスは、次の式で表せます。

v は木1本のバリアンス、ρ(ロー)は木どうしの相関(似ている度合い)、n は木の本数です。v が 1、n が 100 のときの値を計算します。
- 相関が 0 のとき:0 + 1 ÷ 100 = 0.01
- 相関が 0.2 のとき:0.2 + 0.8 ÷ 100 = 0.208
- 相関が 0.5 のとき:0.5 + 0.5 ÷ 100 = 0.505
木を100本に増やしても、相関が 0.5 あるとバリアンスは半分にしかなりません。本数を増やすだけでは足りず、木どうしを似せない工夫が必要だと分かります。
2001年、ブレイマンはランダムフォレストを発表しました。データを無作為に選ぶだけでなく、質問を選ぶたびに、使える特徴量も無作為に絞ります。木ごとに違う特徴量を見るため、木どうしの相関が下がり、平均の効果が大きくなります。
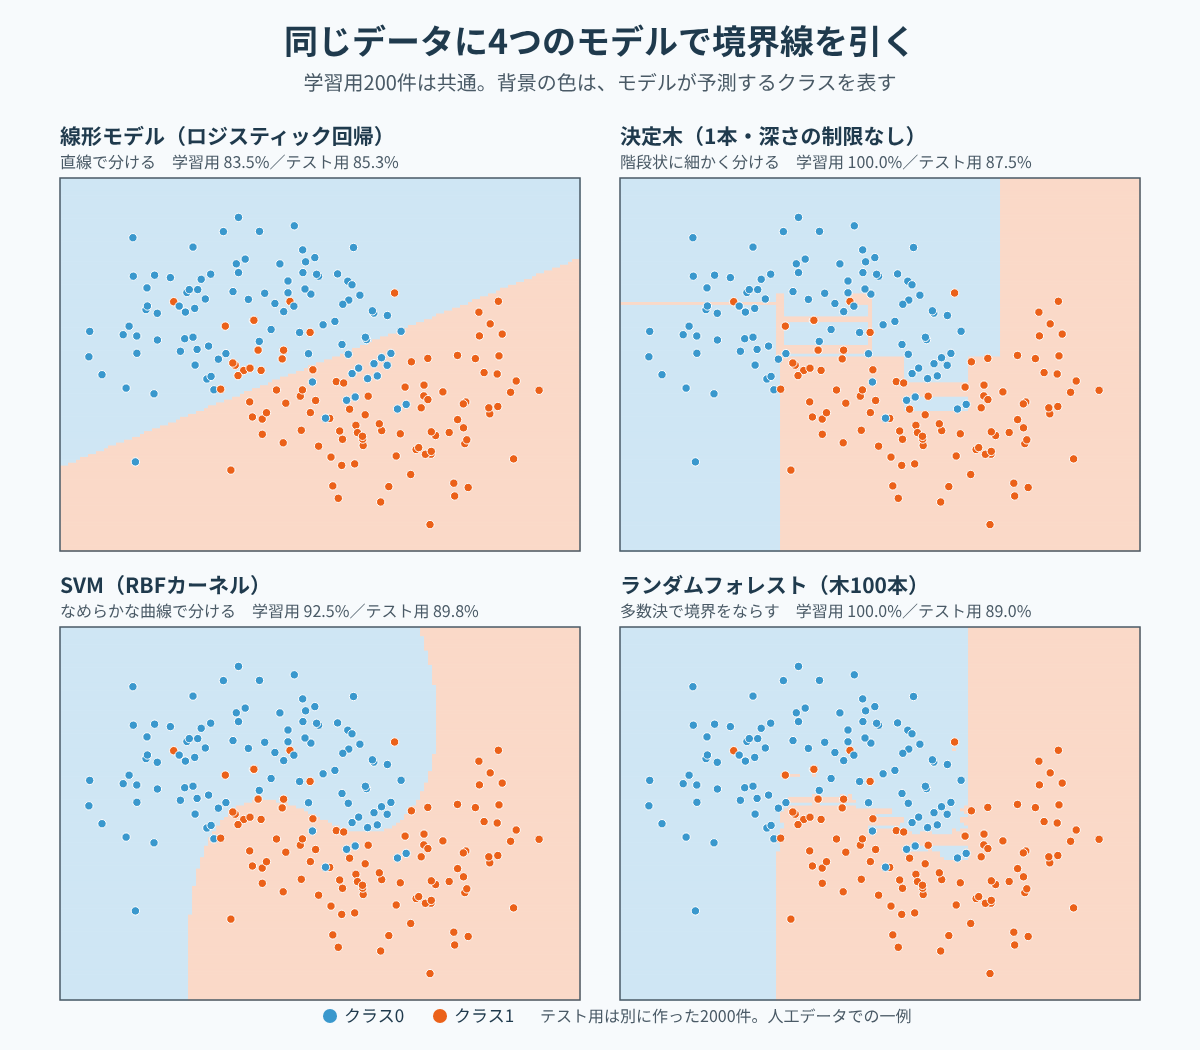
図は、同じ200件のデータを4つのモデルに学習させ、境界を描いた結果です。別に用意した2000件のテスト用データでの正解率も載せています。
- 線形モデル:境界は直線です。学習用 83.5%、テスト用 85.3% で、曲がった形を表せていません(バイアスが大きい状態)
- 決定木1本:学習用は 100% ですが、テスト用は 87.5% です。細い帯のような領域ができており、学習用のデータを覚え込んでいます(バリアンスが大きい状態)
- ランダムフォレスト:学習用は同じく 100% で、テスト用は 89.0% です。1本の木より境界が整い、テスト用の正解率が 1.5 ポイント上がりました
- SVM(RBF カーネル):なめらかな曲線になり、テスト用は 89.8% です
この例では、SVM がランダムフォレストをわずかに上回りました。どのモデルが最もよいかは、データによって変わります。1997年にウォルパートとマクレディが示した「ノーフリーランチ定理」は、あらゆる問題で常に最良となる手法は存在しないと述べています。研修では、「必ず複数のモデルを比べる」という習慣とあわせて伝えるとよいでしょう。
ブースティング:誤りを次の学習器が直す
アンサンブルには、もう1つの流れがあります。ブースティングです。バギングが木を並列に作って平均するのに対し、ブースティングは学習器を1つずつ順番に作り、前の学習器が間違えたデータを次の学習器が重点的に学びます。
1995年にフロイントとシャピレが発表した AdaBoost は、当てずっぽうより少しよい程度の「弱い学習器」を集めて、強い学習器を作れると示しました。各学習器の発言力(重み)は、誤り率から決まります。

α(アルファ)は学習器の発言力、ε(イプシロン)は誤り率です。誤り率が 0.2 なら α = 0.5 × ln 4 = 約 0.693、誤り率が 0.3 なら約 0.424 です。誤り率が 0.5(当てずっぽうと同じ)なら α は 0 になり、発言力を持ちません。
2001年には、フリードマンが勾配ブースティングを発表しました。新しい木に「これまでの予測と正解との差(残差)」を学ばせ、少しずつ足していく方法です。

F_m は m 本目までの予測、h_m は m 本目の木、η は1回に足す割合(学習率)です。正解が 100、最初の予測が 60、η が 0.5 で、各木が残差を正確に学べたとします。
- 1本目:残差は 40。予測は 60 + 0.5 × 40 = 80
- 2本目:残差は 20。予測は 80 + 0.5 × 20 = 90
- 3本目:残差は 10。予測は 90 + 0.5 × 10 = 95
予測が 60、80、90、95 と正解に近づいていきます。バギングがバリアンスを減らすのに対し、ブースティングは主にバイアスを減らします。
残された問題
- 計算が重い:木を1本ずつ順番に作るため、データが大きいと学習に時間がかかりました
- 特徴量は人が作る:表の列をどう加工するか、画像からどのような数値を取り出すかは、依然として人の仕事でした
ここで確認
問い:バギングとブースティングの違いを、木の作り方に注目して説明してください。
答え:バギングは、無作為に選んだデータで木を並列に作り、予測を平均します。ブースティングは、木を1本ずつ順番に作り、前の木までの誤りを次の木が直します。バギングは主にバリアンスを、ブースティングは主にバイアスを減らします。
第6章 データと競技の時代(2006〜2017)
賞金100万ドルのコンテスト
2000年代に入ると、インターネットの普及によって、企業に大量のデータが集まるようになりました。2006年、動画配信の Netflix は、映画のおすすめの精度を10%改善したチームに100万ドルを贈るコンテスト「Netflix Prize」を始めました。世界中のチームが3年近く競い、2009年に目標が達成されます。優勝チームの方法は、100を超えるモデルの予測を組み合わせたアンサンブルでした。第5章の考え方が、実際のデータで力を示したのです。
2010年には、データ分析の競技の場である Kaggle が始まりました。同じ2010年に最初の公開版が出た Python のライブラリ scikit-learn は、線形モデルからランダムフォレストまで、どの手法も同じ書き方(fit で学習し、predict で予測する)で使えるようにしました。機械学習は、研究者だけの道具から、多くのエンジニアが使う道具へと変わっていきます。
勾配ブースティングの高速化
競技の場で特に強さを見せたのが、勾配ブースティングの改良版です。2014年に公開された XGBoost(論文は2016年)は、次の工夫で第5章の「計算が重い」問題を解決しました。
- 木が複雑になりすぎないように、葉の数や葉の値の大きさにペナルティを与える(正則化)
- 質問の候補を調べる計算を並列に行う
- 値が欠けているデータを、そのまま扱えるようにする
続いて、2017年に LightGBM と CatBoost が発表されました。LightGBM は、数値をいくつかの区間にまとめてから質問を探すことで学習をさらに速くし、CatBoost は「都道府県」「商品カテゴリ」のような文字の項目を上手に扱う工夫を取り入れています。
売上、顧客、アクセス記録のような表の形のデータでは、勾配ブースティングが第一の選択肢になりました。
残された問題
表のデータでは大きな成功を収めましたが、画像、音声、文章は別でした。写真は画素の値の集まりにすぎず、そのまま決定木や SVM に入れても精度は上がりません。そこで研究者は、輪郭の向きや色の分布などを計算する特徴量を、何年もかけて手作業で設計していました。
精度を決めるのは学習の方法より特徴量の設計である、という状況が続きます。特徴量の設計は、対象ごとに専門の知識が必要で、他の分野に使い回せません。第3章の「知識獲得のボトルネック」が、形を変えて残っていたとも言えます。
ここで確認
問い:Netflix Prize の優勝チームの方法は、第5章のどの考え方を使っていたでしょうか。
答え:アンサンブルです。性質の違う多数のモデルの予測を組み合わせると、1つのモデルより精度が上がるという考え方を使っていました。
第7章 特徴量を自分で学ぶ:ディープラーニング(2012〜)
人が設計していた特徴量を、データから学ぶ
2012年、画像認識の競技会で、ヒントンらのチームのディープラーニングのモデル(AlexNet)が、2位以下に大差を付けて優勝しました。層を深く重ねたニューラルネットワークは、輪郭、模様、部品、物体という特徴量を、画像のデータから自分で学びます。人が設計していた特徴量が、学習の対象になったのです。
この考え方を表現学習と呼びます。画像に続いて、音声認識、機械翻訳でも同じ変化が起こりました。2024年には、ニューラルネットワークによる機械学習の基礎を築いた功績で、ホップフィールドとヒントンがノーベル物理学賞を受賞しています。詳しい流れは、ディープラーニングの歴史の記事をご覧ください。
それでも表データでは木が強かった
ディープラーニングがすべてを置き換えたわけではありません。表の形のデータでは、勾配ブースティングの優位が続きました。2022年に発表された研究は、中規模の表データを集めて比較し、木を使うモデルがディープラーニングを上回る場合が多いと報告しています。理由として、表データには予測に役立たない列が多く含まれること、境界がなめらかでないことなどが挙げられました。
「画像・音声・文章はディープラーニング、表データは勾配ブースティング」という使い分けが、2010年代後半から2020年代前半の現場の標準になりました。
残された問題
- 大量のデータと計算資源が必要:正解の付いたデータを大量に集め、高性能な計算機で長時間学習させる必要があります
- 課題ごとに作り直す:課題が変わるたびに、データを集め、モデルを学習させ、設定を調整する作業が発生します
- 判断の理由が見えにくい:決定木のようにルールとして読めないため、予測の理由を説明する手法(LIME、SHAP など)が2016年以降に研究されました
ここで確認
問い:従来の機械学習とディープラーニングでは、特徴量を用意する方法がどのように違うでしょうか。
答え:従来の機械学習では、人が特徴量を設計して計算し、モデルに与えます。ディープラーニングでは、モデルが生のデータから特徴量そのものを学びます。
第8章 学習済みモデルを使い回す時代(2022〜2026)
基盤モデルという考え方
第7章の「課題ごとに作り直す」問題を解決したのが、基盤モデルです。大量のデータで一度学習させた大きなモデルを、さまざまな課題に使い回します。文章を扱う大規模言語モデルが代表例で、利用者は自分でモデルを学習させなくても、指示を文章で伝えるだけで多くの課題を解けるようになりました。
表データにも基盤モデルが届いた
この流れは、勾配ブースティングが強かった表データにも届いています。2022年に発表された TabPFN は、人工的に作った大量の表データで事前に学習させたモデルです。新しい表データを渡されると、学習用の行を「例」として読み取り、追加の学習なしで予測します。課題ごとの学習も、設定の調整もいりません。
2025年1月には、改良版が科学誌 Nature に掲載され、1万件までの小さなデータで従来の手法を上回ったと報告されました。扱えるデータの大きさは、その後の版で5万件、さらに2026年5月の版では100万行まで広がっています。
ただし、勾配ブースティングが不要になったわけではありません。表データのモデルを継続的に比較する取り組みでは、次のような結果が報告されています。
- 勾配ブースティングは、実用的な表データで今も有力な候補である
- ディープラーニングは、十分な時間をかけて調整と組み合わせを行えば追いつく
- 基盤モデルは、小さなデータで特に強い
- 複数の種類のモデルを組み合わせると、さらに精度が上がる
最後の点は、第5章と第6章で見たアンサンブルの考え方が、2026年の今も生きていることを示しています。
機械学習の作業そのものを AI が行う
もう1つの新しい動きは、AI エージェントです。データの確認、前処理、モデルの選択、学習、評価という一連の作業を、大規模言語モデルが自分でプログラムを書いて進めます。
2024年には、Kaggle の75の競技を使ってエージェントの実力を測る評価基準が作られました。発表時点で最も成績のよかった構成は、16.9%の競技で銅メダル相当以上に達しています。成績を高める研究はその後も続いており、機械学習の作業のうち定型的な部分は、自動化が進むと考えられます。
今も残る問題
道具が進歩しても、人が判断しなければならない点は残ります。
- 何を予測するかを決める:解くべき課題と、成功を測る指標を決めるのは人です
- データの質を確かめる:誤った正解や偏ったデータで学習させれば、どの手法でも誤った結果が出ます
- 評価を正しく行う:テスト用のデータの情報が学習に漏れる「リーク」があると、精度は見かけだけ高くなります
- 運用後の変化に備える:学習したときと運用するときでデータの傾向が変わると、精度は下がります
- 判断の理由を説明する:融資や採用など、人に影響する判断では説明が求められます
ここで確認
問い:表形式の基盤モデルは、勾配ブースティングと比べて、新しいデータに対する使い方がどのように違うでしょうか。
答え:勾配ブースティングは、新しいデータごとにモデルを学習させ、設定を調整します。表形式の基盤モデルは、事前に学習を済ませており、新しいデータの学習用の行を例として読み取って、追加の学習なしで予測します。
終章 物語を振り返る
問題と解決のバトンリレー
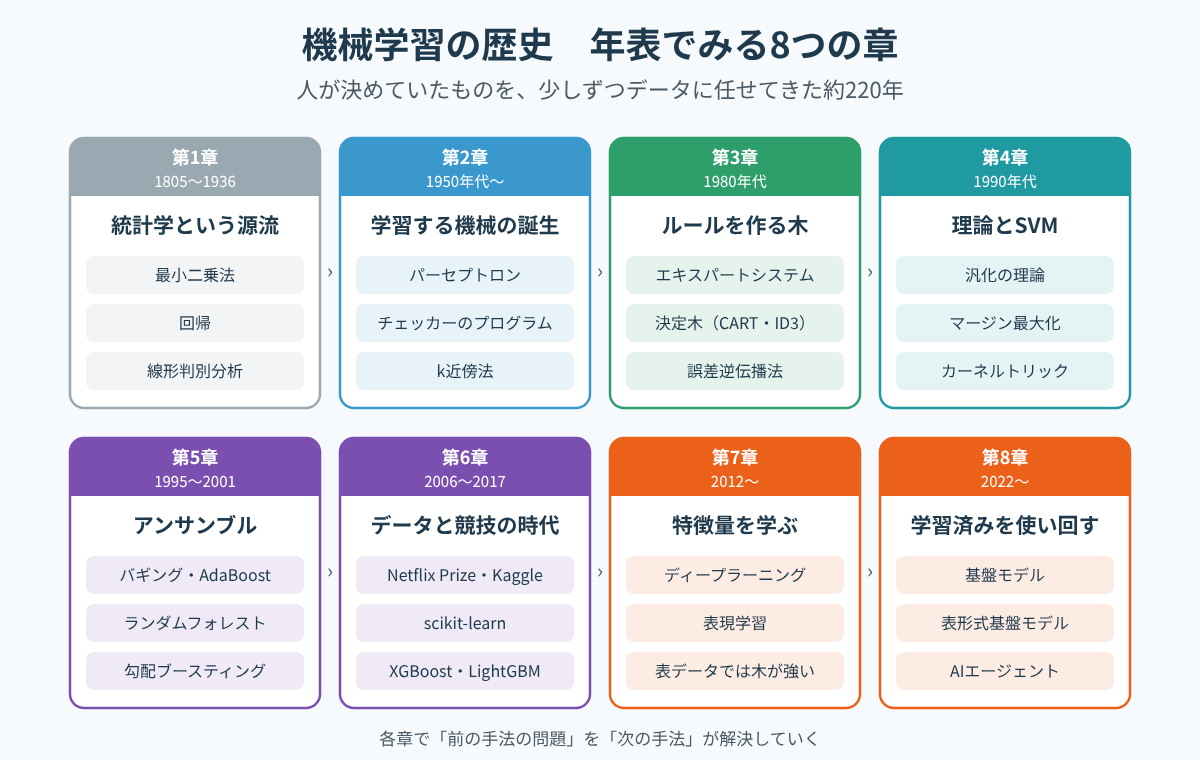
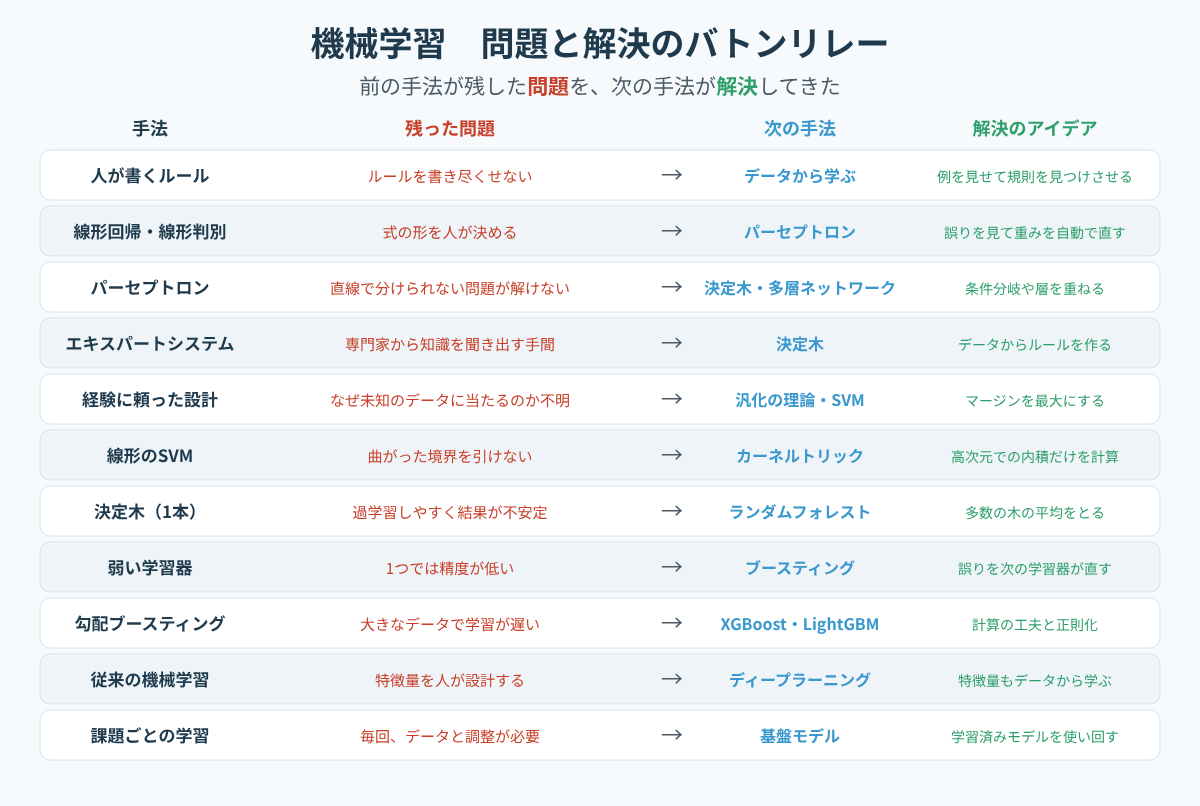
8つの章を、「残った問題」と「解決のアイデア」の組み合わせで並べ直すと、次の図になります。
3つのパターン
約220年の歴史から、3つのパターンが読み取れます。
1つ目は、人が決める部分が減り続けてきたことです。最初は人がルールを書いていました。次に、ルールはデータから学び、人は特徴量を設計するようになりました。ディープラーニングでは特徴量も学習の対象になり、基盤モデルでは課題ごとの学習さえ省けるようになっています。序章で挙げた「手間」の課題が、一貫して解決されてきたと言えます。
2つ目は、表現力と汎化の綱引きです。パーセプトロンは表現力が足りず、決定木は表現力が高い代わりに過学習しました。SVM のマージン、ランダムフォレストの平均、XGBoost の正則化は、どれも「表現力を保ちながら過学習を抑える」ための工夫です。
3つ目は、古い手法が消えずに道具箱に残ることです。線形回帰は今も最初に試す基準として使われ、決定木は勾配ブースティングの部品として現役です。新しい手法は、古い手法を置き換えるというより、使える道具を増やしてきました。
どの手法を使えばよいか
受講者から「結局どれを使えばよいのですか」と聞かれたときの目安を示します。
- 最初に線形回帰やロジスティック回帰を試し、比較の基準にする
- 表データでは、勾配ブースティング(XGBoost、LightGBM など)を試す。データが少ない場合は、表形式の基盤モデルも候補になる
- 画像、音声、文章では、学習済みのディープラーニングのモデルや基盤モデルを利用する
- 判断の理由の説明が重視される場合は、線形モデルや浅い決定木を優先する
- どの場合も、複数のモデルを同じテスト用データで比べてから決める
確認問題
ランダムフォレストが、1本の決定木の弱点を補う仕組みとして、最も適切な説明はどれでしょうか。
- 木を1本だけ深く育てて、学習用データへの当てはまりを高める
- 前の木の誤りを次の木が直すように、木を順番に足していく
- データを高い次元に移し、マージンが最大の境界を1つ求める
- データと特徴量を無作為に選んだ多数の木を作り、多数決をとる
解答と解説
正解は 4 です。
- 1 は誤りです。木を深く育てると、学習用データへの当てはまりは高まりますが、過学習が進みます。1本の決定木の弱点そのものです
- 2 は誤りです。木を順番に足して前の誤りを直すのは、ブースティング(AdaBoost や勾配ブースティング)の説明です
- 3 は誤りです。高い次元に移してマージン最大の境界を求めるのは、カーネルを使った SVM の説明です
- 4 が正解です。ランダムフォレストは、データと特徴量の両方を無作為に選んで木どうしの相関を下げ、多数決(回帰では平均)によってバリアンスを減らします
研修で使うときの進め方
講師向けに、この物語を研修で使う進め方の一例を示します。
- 「人がルールを書く方法」と「データから学ばせる方法」の違いを、迷惑メールの例で確認する
- 年表の図を示し、8つの章の全体像と、表現力・汎化・手間という3つの課題を先に伝える
- 最小二乗法の数値例(3点から y = 1.5x を求める)を、受講者に手で計算してもらう
- XOR の4つの点を紙に描いてもらい、1本の直線では分けられないと確かめる
- ジニ不純度の数値例(0.5 から 0.167 へ)を計算し、決定木が質問を選ぶ基準を確認する
- 4つのモデルの境界の図を見せ、「学習用の正解率が 100% のモデルは、よいモデルと言えるか」を話し合う
- 勾配ブースティングの数値例(60、80、90、95)で、残差を少しずつ直す流れを追う
- 問題と解決のバトンリレーの図で、全体のつながりを振り返る
Python の演習と組み合わせる場合は、scikit-learn で同じデータにロジスティック回帰、決定木、ランダムフォレスト、SVM を学習させ、学習用とテスト用の正解率を表にまとめる実習がおすすめです。決定木の深さを 1、3、5、制限なしと変えて、学習用とテスト用の正解率の差が広がる様子を観察すると、過学習を体験として理解できます。
初学者がつまずきやすい点も挙げておきます。
- 学習用の正解率だけを見て、よいモデルだと判断してしまう
- バギングとブースティングを、どちらも「木をたくさん作る方法」として混同する
- ディープラーニングが登場したので、従来の手法は不要になったと考えてしまう
まとめ
機械学習の歴史は、次の流れで整理できます。
- 統計学の時代に、データから式の係数を決めて予測する考え方が生まれた
- パーセプトロンが、誤りを見て重みを自動で直す学習を実現したが、直線の境界しか引けなかった
- 決定木が、データからルールを作る方法を示したが、過学習と不安定さが残った
- SVM が、マージンの最大化とカーネルトリックで、汎化と曲がった境界を両立した
- ランダムフォレストとブースティングが、多数の学習器を組み合わせて精度を高めた
- XGBoost などが勾配ブースティングを高速化し、表データの標準になった
- ディープラーニングが、特徴量の設計をデータからの学習に置き換えた
- 基盤モデルが、課題ごとの学習を省き、表データにも広がりつつある
手法の名前を一覧で覚えるのではなく、「どの問題を解決するために生まれたのか」を軸にすると、受講者は新しい手法に出会ったときにも位置づけを考えられるようになります。
次の学習ステップとして、まず scikit-learn で線形モデル、決定木、ランダムフォレストを同じデータに当てはめ、学習用とテスト用の正解率を比べてみてください。そのうえで、交差検証による評価の方法、勾配ブースティングの主な設定の意味へと進むと、実務で使える知識がつながっていきます。ニューラルネットワークの側の物語は、ディープラーニングの歴史とオプティマイザの歴史の記事で続きを確認できます。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 山崎講師2026年11月15日機械学習の歴史を物語で学ぶ|最小二乗法からパーセプトロン、決定木、SVM、ランダムフォレスト、勾配ブースティング、表形式基盤モデルまで
 山崎講師2026年11月15日オプティマイザの歴史を物語で学ぶ|勾配降下法からモーメンタム、AdaGrad、RMSProp、Adam、AdamW、Muonまで
 山崎講師2026年11月15日ディープラーニングの歴史を物語で学ぶ|パーセプトロンから誤差逆伝播法、2度の冬、AlexNet、Transformer、基盤モデルまで
 山崎講師2026年11月15日コンピュータビジョンの歴史を物語で学ぶ|猫の脳の実験からAlexNet、ResNet、YOLO、ViT、CLIP、SAM、ロボットの目まで