ディープラーニングの歴史を物語で学ぶ|パーセプトロンから誤差逆伝播法、2度の冬、AlexNet、Transformer、基盤モデルまで
 山崎講師
こんにちは。ゆうせいです。
ディープラーニングの研修では、活性化関数、誤差逆伝播法、勾配消失、ドロップアウト、バッチ正規化、Adam、スキップ接続と、多くの技術用語が登場します。受講者から「なぜこんなに多くの工夫が必要なのか」「どれが何のためにあるのか」と質問されることも多いのではないでしょうか。
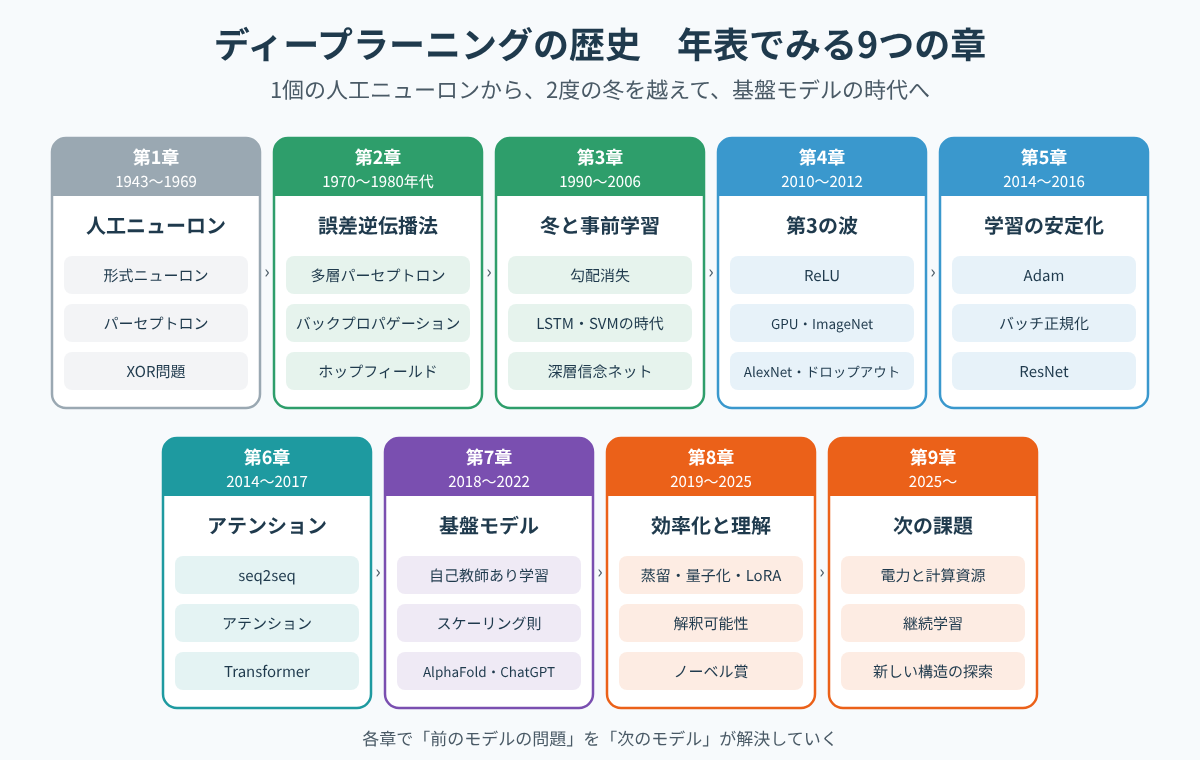
これらの技術は、ばらばらに生まれたわけではありません。「ネットワークをどうやって学習させるか」という1つの問いに対して、前の方法が抱えていた問題を、次の方法が解決してきた結果です。今回は、ディープラーニングの歴史を、その始まりから2026年の最新の動向まで、物語の形でたどります。
これまでの記事では、強化学習、生成モデル、自然言語処理、コンピュータビジョンの歴史を紹介しました。今回は、それらすべての土台になっている「学習の仕組み」そのものの物語です。各章の終わりには、受講者の理解を確かめる問いを用意しました。G検定・E資格の学習や、AI研修の導入に活用してください。
序章 ディープラーニングとは何か
物語を始める前に、言葉の関係を整理します。
- 人工知能(AI):人間の知的な働きを、コンピュータで実現しようとする技術の全体
- 機械学習:AI の中で、データから規則や傾向を学ぶ方法
- ディープラーニング(深層学習):機械学習の中で、層を何段も重ねたニューラルネットワークを使う方法
ニューラルネットワークは、脳の神経細胞(ニューロン)の働きをヒントにした計算の仕組みです。1つ1つの人工ニューロンは、入ってきた数値に「重み」を掛けて足し合わせ、その結果に応じて次へ信号を送るという、単純な計算しかしません。この単純な部品を大量に並べ、層として何段も重ねることで、複雑な判断ができるようになります。
学習とは、この「重み」を少しずつ調整して、望ましい答えが出るようにすることです。工場の流れ作業にたとえると、各工程(層)の担当者が、最終製品の出来を見ながら自分の作業のやり方(重み)を少しずつ直していく作業にあたります。
ディープラーニングの歴史は、「層を重ねたネットワークの重みを、どうすればうまく調整できるか」という問いへの挑戦の歴史です。
第1章 人工ニューロンの誕生とパーセプトロン(1943〜1969)
神経細胞を数式にする
物語は、コンピュータがまだ普及していない1943年に始まります。神経生理学者のウォーレン・マカロックと数学者のウォルター・ピッツは、神経細胞の働きを単純な数式で表した「形式ニューロン」を発表しました。入力の合計がある値を超えたら 1 を、超えなければ 0 を出力するというモデルです。
1949年には、心理学者のドナルド・ヘッブが、「同時に活動する神経細胞どうしの結び付きは強くなる」という学習の仮説(ヘッブの法則)を示しました。結び付きの強さを変えることが学習である、という考え方の出発点です。
パーセプトロン:学習する機械
1958年、アメリカの心理学者フランク・ローゼンブラットは、パーセプトロンを発表しました。パーセプトロンは、形式ニューロンに「正解と比べて重みを自動的に直す」仕組みを加えたもので、データから学習できる最初期の機械です。新聞でも取り上げられ、大きな期待を集めました。
入力が2つのパーセプトロンは、次の式で計算します。

各記号の意味は次のとおりです。
- x1, x2:入力
- w1, w2:重み。それぞれの入力をどれだけ重視するかを表す
- b:バイアス。出力が 1 になりやすいかどうかを調整する値
- z:重み付きの合計。z が 0 より大きければ 1 を、そうでなければ 0 を出力する
数値で確認します。w1 = 1、w2 = 1、b = -1.5 とします。入力が (1, 1) のとき、z = 1 + 1 - 1.5 = 0.5 で 0 より大きいので、出力は 1 です。入力が (1, 0) のとき、z = 1 + 0 - 1.5 = -0.5 なので、出力は 0 です。両方の入力が 1 のときだけ 1 を出力するので、このパーセプトロンは「AND(かつ)」の判定を行っています。
図形として見ると、パーセプトロンは、平面の上に1本の直線を引いて、データを2つのグループに分けています。
残された問題:1本の直線では分けられない
1969年、マービン・ミンスキーとシーモア・パパートは、著書『パーセプトロン』で、この仕組みの限界を数学的に示しました。代表的な例が XOR(排他的論理和)です。XOR は、2つの入力の「どちらか一方だけ」が 1 のときに 1 を出力します。
- (0, 0) → 0
- (1, 0) → 1
- (0, 1) → 1
- (1, 1) → 0
この4つの点を平面に描くと、1 になる点と 0 になる点が対角線上に互い違いに並びます。どのように直線を1本引いても、2つのグループに分けることはできません。
層を重ねれば解決できることは知られていましたが、当時は、重ねた層の重みを学習させる方法がありませんでした。期待は急速にしぼみ、ニューラルネットワークの研究は最初の「冬の時代」を迎えます。
ここで確認
問い:単純なパーセプトロンが XOR を解けないのは、なぜでしょうか。
答え:パーセプトロンは1本の直線でデータを2つに分ける仕組みですが、XOR は 1 になる点と 0 になる点が互い違いに並ぶため、1本の直線では分けられないからです。
第2章 層を重ねる:誤差逆伝播法(1970〜1980年代)
中間の層を、どう学習させるか
入力と出力の間に中間の層(隠れ層)を入れると、直線を何本も組み合わせた複雑な境界を作れるため、XOR も解けるようになります。問題は、学習の方法でした。出力の層は、正解と比べれば誤りの大きさが分かります。しかし、中間の層には「正解」がないため、どの重みをどれだけ直せばよいのかが分かりません。
勾配降下法:坂を下るように重みを直す
この問題を解く土台になるのが、勾配降下法です。予測と正解のずれを表す値(損失)を計算し、損失が小さくなる向きに重みを少しずつ動かします。

各記号の意味は次のとおりです。
- w:重み
- L:損失。予測と正解のずれの大きさ
- ∂L/∂w:勾配。重みを少し増やしたときに、損失がどれだけ増えるかを表す値
- η(イータ):学習率。1回にどれだけ重みを動かすかを決める小さな値
霧の中で山を下る場面にたとえられます。周りは見えなくても、足元の傾きは分かります。傾きが下がっている向きに1歩ずつ進めば、やがて谷底に近づきます。
数値で確認します。損失が L = (w - 3)² で表されるとします。損失が最小になるのは w = 3 のときです。勾配は 2(w - 3) なので、w = 0 から始めると、勾配は 2 × (0 - 3) = -6 です。学習率を 0.1 とすると、新しい重みは 0 - 0.1 × (-6) = 0.6 になります。もう1回繰り返すと、勾配は 2 × (0.6 - 3) = -4.8 で、重みは 0.6 + 0.48 = 1.08 です。0 → 0.6 → 1.08 と、正解の 3 に少しずつ近づいていきます。
誤差逆伝播法:誤差を出口から入口へ伝える
残る問題は、中間の層の勾配をどう計算するかです。その答えが、誤差逆伝播法(バックプロパゲーション)です。出力の誤差を、出口から入口に向かって層を1つずつさかのぼりながら伝え、それぞれの重みが誤差にどれだけ関わっていたかを計算します。数学的には、合成関数の微分(連鎖律)を使います。

h は中間の層の出力、y は最終的な出力です。重み w が h を変え、h が y を変え、y が損失 L を変えるという影響の連鎖を、掛け算でつなげています。例えば、3つの値が順に 0.5、0.2、3 なら、勾配は 0.5 × 0.2 × 3 = 0.3 です。
工場のたとえで言えば、最終製品の不良の原因を、最後の工程から前の工程へと順にさかのぼり、各工程の責任の大きさを割り出す作業です。
この考え方は、複数の研究者によって段階的に作られました。1967年には、日本の甘利俊一が、多層のネットワークを確率的勾配降下法で学習させる方法を発表しています。1970年代には、セッポ・リンナインマーやポール・ワーボスが、現在の誤差逆伝播法にあたる計算方法を示しました。そして1986年、デビッド・ラメルハート、ジェフリー・ヒントン、ロナルド・ウィリアムズが科学誌 Nature に発表した論文によって、誤差逆伝播法は広く知られるようになり、ニューラルネットワークは2度目のブームを迎えます。
同じ時代の重要な研究
この時代には、後につながる研究がいくつも生まれています。
- 1979年:福島邦彦のネオコグニトロン。後の畳み込みニューラルネットワーク(CNN)の原型
- 1982年:ジョン・ホップフィールドのホップフィールドネットワーク。パターンを記憶し、不完全な入力から思い出すネットワーク
- 1985年:ヒントンらのボルツマンマシン。統計物理学の考え方を使い、データの特徴を自分で見つけるネットワーク
- 1989年:ヤン・ルカンらが、誤差逆伝播法で CNN を学習させ、手書き数字の認識に成功
1989年には、中間の層を1つ持つネットワークは、ニューロンの数を十分に増やせば、どのような連続関数でも近似できることが数学的に示されました(万能近似定理)。ニューラルネットワークの表現力には、理論的な裏付けが与えられたのです。
ここで確認
問い:誤差逆伝播法は、多層のネットワークのどのような問題を解決したのでしょうか。
答え:中間の層には正解がないため、重みをどれだけ直せばよいか分からないという問題です。出力の誤差を出口から入口へ順に伝えることで、すべての層の重みの勾配を計算できるようにしました。
第3章 2度目の冬と、夜明け前(1990〜2006)
勾配消失:誤差が途中で消えてしまう
誤差逆伝播法があれば、層をいくらでも深くできるように思えました。ところが、層を深くすると、入口に近い層がほとんど学習しなくなるという問題が現れました。1991年、ドイツのゼップ・ホッフライターは、この現象を分析し、原因を明らかにしました。勾配消失問題です。
当時よく使われていた活性化関数(ニューロンの出力を決める関数)のシグモイド関数は、微分の値が最大でも 0.25 にしかなりません。誤差逆伝播法では、層を1つさかのぼるたびに、この微分の値を掛け算します。10層さかのぼると、次のようになります。

最大の値を掛け続けたとしても、勾配は100万分の1以下に小さくなります。伝言ゲームで、人を経るたびに声が4分の1になっていくようなものです。10人目には、ほとんど何も聞こえません。入口に近い層には「どう直せばよいか」の情報が届かず、学習が進まなくなります。
LSTM:記憶を長く保つ
勾配消失は、時系列のデータを扱う RNN(再帰型ニューラルネットワーク)で特に深刻でした。長い文章や音声では、過去にさかのぼる回数が多くなるためです。1997年、ホッフライターとユルゲン・シュミットフーバーは、LSTM を発表しました。情報を保管する「記憶セル」と、情報の出入りを調整する「ゲート」を使い、勾配が消えずに長く伝わる経路を作ったのです。LSTM は、後に音声認識や機械翻訳で広く使われます。
主役はサポートベクターマシンへ
1990年代から2000年代前半にかけて、機械学習の主役は、サポートベクターマシン(SVM)などの手法に移りました。理論が明快で、少ないデータでも高い精度を出せたためです。ニューラルネットワークは、学習に時間がかかり、設定の調整が難しく、深くすると学習が進まない方法と見なされ、研究は2度目の冬を迎えます。
それでも、ヒントン、ルカン、ヨシュア・ベンジオといった少数の研究者たちは、ニューラルネットワークの研究を続けました。
2006年:深い層を学習させる方法
2006年、ヒントンらは、深いネットワークを学習させる新しい手順を発表しました。いきなり全体を学習させるのではなく、まず1層ずつ順番に、入力データの特徴を捉えるように準備の学習(事前学習)を行い、最後に全体を誤差逆伝播法で仕上げる方法です。この方法で作られたネットワークは、深層信念ネットワークと呼ばれます。
建物にたとえると、全部の階を一度に建てるのではなく、1階ずつ土台を固めてから積み上げる方法です。この成果をきっかけに、「ディープラーニング」という言葉が広く使われるようになりました。
残された問題
事前学習は、手順が複雑で時間がかかりました。また、この時点では、大規模な実用の課題で他の手法を明確に上回る結果は、まだ示されていませんでした。
ここで確認
問い:勾配消失問題とは、どのような現象でしょうか。
答え:誤差逆伝播法で誤差を入口に向かって伝えるとき、層をさかのぼるたびに小さな値を掛け算するため、勾配がほとんど 0 になり、入口に近い層の学習が進まなくなる現象です。
第4章 第3の波:ReLU、GPU、データ(2010〜2012)
ReLU:勾配を消さない活性化関数
勾配消失への、より単純な解決策が見つかりました。活性化関数を、シグモイド関数から ReLU(Rectified Linear Unit)に替えることです。2010年から2011年にかけて、その効果が相次いで報告されました。

ReLU は、入力が正ならそのまま出力し、負なら 0 を出力するだけの関数です。入力が正のとき、微分の値は常に 1 です。10層さかのぼっても、1 を10回掛けるだけなので、勾配は小さくなりません。シグモイド関数の 0.25 の10乗と比べると、違いは明らかです。計算も単純で速く、事前学習をしなくても深いネットワークを学習できるようになりました。
GPU とデータ
残る壁は、計算の速さとデータの量でした。
- GPU:ゲームの映像を描くための装置である GPU は、大量の単純な計算を同時に行うことが得意です。ニューラルネットワークの計算は行列の積が中心なので、GPU と相性がよく、学習時間が大幅に短くなりました
- データ:インターネットの普及によって、大量の画像や文章が手に入るようになりました。2009年には、大量の画像に人の手でラベルを付けたデータセット ImageNet が公開され、最終的には1400万枚以上の規模になりました
相次ぐ成果
2009年ごろから、音声認識で、深いニューラルネットワークが従来の方法を上回る結果が報告され始めました。2012年には、Google の研究チームが、動画から切り出した大量の画像をラベルなしで学習させたネットワークの中に、猫の顔に強く反応するニューロンが生まれたことを報告し、話題になりました。
そして2012年、画像認識の大会 ILSVRC で、ヒントンの研究室の AlexNet が、2位に10ポイント以上の差を付けて優勝しました。AlexNet は、ReLU と GPU に加えて、ドロップアウトという方法を使っていました。学習のたびに、ニューロンの一部をランダムに休ませる方法です。特定のニューロンに頼りすぎることを防ぎ、訓練データだけに過剰に適合してしまう過学習を抑えます。チームの練習で、毎回ランダムに何人かを休ませると、誰が欠けても動けるチームになるのと同じ考え方です。
アイデア(ReLU、ドロップアウト)、計算資源(GPU)、データ(ImageNet)の3つがそろい、ニューラルネットワークの3度目の波が始まりました。この波は、現在まで続いています。
ここで確認
問い:ReLU は、勾配消失問題をどのように和らげたのでしょうか。
答え:入力が正のときの微分の値が常に 1 なので、層をさかのぼって掛け算を繰り返しても、勾配が小さくなりにくいからです。
第5章 学習を安定させる道具がそろう(2014〜2016)
それでも学習は職人技だった
AlexNet の後、研究者たちはネットワークをさらに深く、大きくしようとしました。しかし、学習率の決め方や重みの最初の値によって、学習がうまく進んだり失敗したりするため、深いネットワークの学習には経験と試行錯誤が必要でした。2014年から2016年にかけて、この問題を解決する道具が次々と登場します。
Adam:歩幅を自動で調整する
第2章の勾配降下法では、学習率(歩幅)をすべての重みで同じ値にしていました。歩幅が大きすぎると谷底を飛び越え、小さすぎるといつまでも到着しません。2014年に発表された Adam は、過去の勾配の傾向を記録し、重みごとに歩幅を自動的に調整します。なだらかな坂では大きく、急で不安定な坂では小さく進むイメージです。Adam とその改良版は、現在も広く使われています。
初期値と正規化:信号の大きさをそろえる
重みの最初の値が不適切だと、信号が層を進むうちに大きくなりすぎたり、小さくなりすぎたりします。2010年と2015年に、層の大きさに応じて適切な初期値を決める方法が提案されました。
2015年のバッチ正規化は、各層に入るデータの平均とばらつきを、学習の途中で一定にそろえる方法です。前の層の重みが変わるたびに、後ろの層に入る値の傾向が変わってしまうと、後ろの層は学習しにくくなります。値の傾向をそろえることで、学習が安定し、速く進むようになりました。
ResNet:近道を作る
層を非常に深くすると精度がかえって下がる問題は、2015年の ResNet が解決しました。層を飛び越える近道(スキップ接続)を足すことで、信号と勾配がそのまま通れる経路を作ります。ResNet は 152層という深さで学習に成功しました。詳しい仕組みは、コンピュータビジョンの歴史の記事で紹介しています。
LSTM の記憶セル、ReLU、スキップ接続は、どれも「勾配が途中で消えない通り道を作る」という同じ考え方に基づいています。
道具が誰でも使えるようになる
同じ時期に、ディープラーニングのプログラムを書くための道具(フレームワーク)も整いました。2015年には Google の TensorFlow や、日本の Preferred Networks による Chainer が公開され、2016年から2017年にかけて PyTorch が登場しました。誤差逆伝播法の計算を自動で行ってくれるため、研究者や技術者は、ネットワークの設計に集中できるようになりました。
2016年には、ディープラーニングと強化学習を組み合わせた AlphaGo が、囲碁のトップ棋士に勝利しました。2019年3月には、ヒントン、ルカン、ベンジオの3人に、計算機科学で最も権威のある賞の1つであるチューリング賞(2018年度)が贈られることが発表されています。
ここで確認
問い:バッチ正規化は、どのような問題を解決するための方法でしょうか。
答え:学習の途中で、各層に入るデータの値の傾向が変わってしまい、学習が不安定になる問題です。層に入るデータの平均とばらつきをそろえることで、学習を安定させ、速く進められるようにしました。
第6章 アテンションと Transformer(2014〜2017)
順番に処理する限界
画像では CNN が成果を上げましたが、文章や音声のような系列のデータには、RNN や LSTM が使われていました。これらは、データを先頭から1つずつ順番に処理します。そのため、計算を並列に行えず、GPU の力を十分に生かせませんでした。また、LSTM を使っても、非常に長い系列では、離れた位置の情報が薄れてしまいます。
必要な場所に注目する
2014年に提案されたアテンション(注意機構)は、出力を作るたびに、入力のどの部分に注目すべきかを計算し、必要な情報を直接参照する仕組みです。そして2017年、Google の研究者たちは、RNN を使わず、アテンションだけで系列を処理する Transformer を発表しました。
Transformer は、系列の中のすべての要素どうしの関係を一度に計算します。順番に処理する必要がないため、GPU で並列に計算でき、大量のデータで大きなモデルを学習できるようになりました。Transformer の中には、スキップ接続や正規化といった、第5章の道具も組み込まれています。仕組みの詳しい説明は、自然言語処理の歴史の記事で紹介しています。
汎用の部品になる
Transformer は、もともと機械翻訳のために作られましたが、その後、画像、音声、動画、タンパク質の構造など、さまざまなデータに使われるようになりました。それまでは、画像には CNN、系列には RNN と、データの種類ごとに異なる構造を使っていました。Transformer の登場で、1つの構造でさまざまなデータを扱えるようになり、分野をまたいだ発展が加速しました。
ここで確認
問い:Transformer は、RNN や LSTM のどのような問題を解決したのでしょうか。
答え:データを1つずつ順番に処理するため並列に計算できず、長い系列では離れた位置の情報が薄れる問題です。すべての要素どうしの関係を一度に計算することで、並列化と長い系列の把握を両立しました。
第7章 事前学習と基盤モデル(2018〜2022)
ラベル付きデータが足りない
ネットワークを大きくするほど、多くの学習データが必要になります。しかし、人間が正解ラベルを付けたデータを用意するには、大きな手間と費用がかかります。
この問題を解決したのが、自己教師あり学習です。データそのものから問題を作り、ラベルなしで学習します。文章なら「次の単語を当てる」「隠された単語を当てる」、画像なら「隠された部分を復元する」といった問題です。インターネット上の膨大なデータをそのまま学習に使えるようになりました。
2018年以降、大量のデータで事前学習した大きなモデルを、さまざまな課題に使い回す方法が主流になります。2006年の事前学習は「深い層を学習させるための準備」でしたが、この時代の事前学習は「幅広い知識を先に身に付けさせる」ためのものです。同じ言葉でも、目的が変わっている点に注意してください。
大きくするほど賢くなる
2020年には、モデルの大きさ、データの量、計算量を増やすと、性能が予測可能な形で向上するという「スケーリング則」が報告されました。大きなモデルに投資する根拠が示され、モデルの大規模化が加速します。2021年には、幅広い課題の土台として使える大規模なモデルを指す「基盤モデル」という言葉が提案されました。
この時期には、それまでの常識を揺るがす発見もありました。従来は、モデルを大きくしすぎると過学習を起こして性能が下がると考えられていました。ところが、さらに大きくしていくと、いったん悪化した性能が再び良くなる「二重降下」と呼ばれる現象が報告されたのです。巨大なモデルがなぜうまく働くのかは、現在も研究が続いている問いです。
科学と社会への広がり
2020年、DeepMind の AlphaFold 2 は、タンパク質の立体構造を、アミノ酸の並びから高い精度で予測できることを示しました。生物学で50年来の難問とされてきた課題です。ディープラーニングは、科学の研究を進める道具にもなりました。
2022年には、言葉から画像を作る画像生成 AI が広く公開され、11月には ChatGPT が登場しました。ディープラーニングは、専門家の技術から、誰もが日常的に使う道具へと変わりました。
ここで確認
問い:自己教師あり学習は、どのような問題を解決したのでしょうか。
答え:大きなモデルの学習に必要な、人間が正解ラベルを付けたデータが足りないという問題です。データそのものから問題を作ることで、ラベルのない膨大なデータを学習に使えるようにしました。
第8章 軽くする、理解する(2019〜2025)
大きすぎるモデルを軽くする
モデルが巨大になると、学習にも利用にも、大きな計算資源と費用がかかるようになりました。そこで、モデルを軽くする技術が発展します。
- 蒸留:大きなモデル(教師)の出力をまねるように、小さなモデル(生徒)を学習させる方法。2015年に提案された
- 量子化:重みを表す数値の細かさを落として、必要なメモリと計算量を減らす方法
- 枝刈り:影響の小さい重みを取り除く方法
- LoRA:2021年に提案された方法。巨大なモデルの重みは固定したまま、少数の追加の重みだけを学習させて、特定の用途に合わせる
蒸留は、熟練の職人の仕事ぶりを見て、弟子が要点を身に付けることにたとえられます。こうした技術によって、手元のパソコンやスマートフォンで動くモデルも実用的になってきました。
中身を理解する
もう1つの大きな問題は、ネットワークの中で何が起きているのかが、人間には分かりにくいことです。何億、何兆もの重みの組み合わせが、どのように答えを導いているのかを説明できなければ、医療や金融のような重要な場面で安心して使うことができません。
この問題に対して、ネットワークの内部を調べ、どのニューロンの組み合わせがどのような概念や計算に対応しているかを明らかにしようとする、解釈可能性の研究が進んでいます。事実と異なる内容をもっともらしく出力してしまう問題(ハルシネーション)の原因の解明や対策も、重要な研究テーマです。
ノーベル賞
2024年10月、ノーベル物理学賞が、ジョン・ホップフィールドとジェフリー・ヒントンに贈られることが発表されました。授賞理由は、人工ニューラルネットワークによる機械学習を可能にした基礎的な発見と発明です。第2章で登場したホップフィールドネットワークとボルツマンマシンが、物理学の考え方を土台にしていたことが評価されました。
同じ年のノーベル化学賞は、タンパク質の構造予測と設計の研究に贈られ、AlphaFold を開発したデミス・ハサビスとジョン・ジャンパーが、計算によるタンパク質設計を進めたデイビッド・ベイカーとともに受賞しました。2度の冬を経験したニューラルネットワークの研究は、科学の世界で最も広く知られた賞を受けるまでになりました。
ここで確認
問い:蒸留とは、どのような方法でしょうか。
答え:大きなモデルの出力をまねるように小さなモデルを学習させ、性能をなるべく保ったまま、軽く速いモデルを作る方法です。
第9章 次の課題(2025〜)
電力と計算資源
2025年以降、ディープラーニングの最大の制約の1つは、電力と計算資源になっています。国際エネルギー機関(IEA)は2025年4月の報告書で、世界のデータセンターの電力消費が、2024年の約415テラワット時から、2030年には約945テラワット時へと2倍以上に増えるという見通しを示しました。現在の日本全体の電力消費をやや上回る量で、AI の利用拡大が最大の要因とされています。
第8章で紹介したモデルを軽くする技術は、費用を下げるだけでなく、この制約に対応するためにも重要になっています。
学び続けることが苦手
現在のモデルは、学習を終えた後は重みが固定され、使いながら新しいことを学び続けることが苦手です。新しい内容を追加で学習させると、以前に学んだ内容を忘れてしまう現象(破滅的忘却)が知られています。人間のように経験から学び続ける「継続学習」は、2026年の時点で活発に研究されているテーマです。
Transformer の次を探す
Transformer にも課題があります。すべての要素どうしの関係を計算するため、系列が長くなると、計算量が長さの2乗に比例して増えます。この課題に対して、計算量を抑えながら長い系列を扱う構造(状態空間モデルと呼ばれる方法など)や、Transformer と組み合わせた構造の研究が進んでいます。生成モデルの歴史の記事で紹介した拡散言語モデルのように、文章の作り方そのものを見直す研究もあります。現時点では、Transformer が引き続き主流です。
他の分野との合流
これまでの歴史の記事で見てきたように、答える前に考える推論モデル、道具を使って仕事を進める AI エージェント、行動に応じて変化する世界を作る世界モデル、ロボットを動かすモデルなど、ディープラーニングを土台にした技術が、互いに結び付きながら発展しています。
ここで確認
問い:現在のディープラーニングが抱える課題を、3つ挙げてください。
答え:学習と利用に必要な電力と計算資源が膨大であること、学習を終えた後に新しいことを学び続けるのが苦手であること、ネットワークの中で何が起きているかを説明しにくいことなどです。
終章 物語を貫くパターン
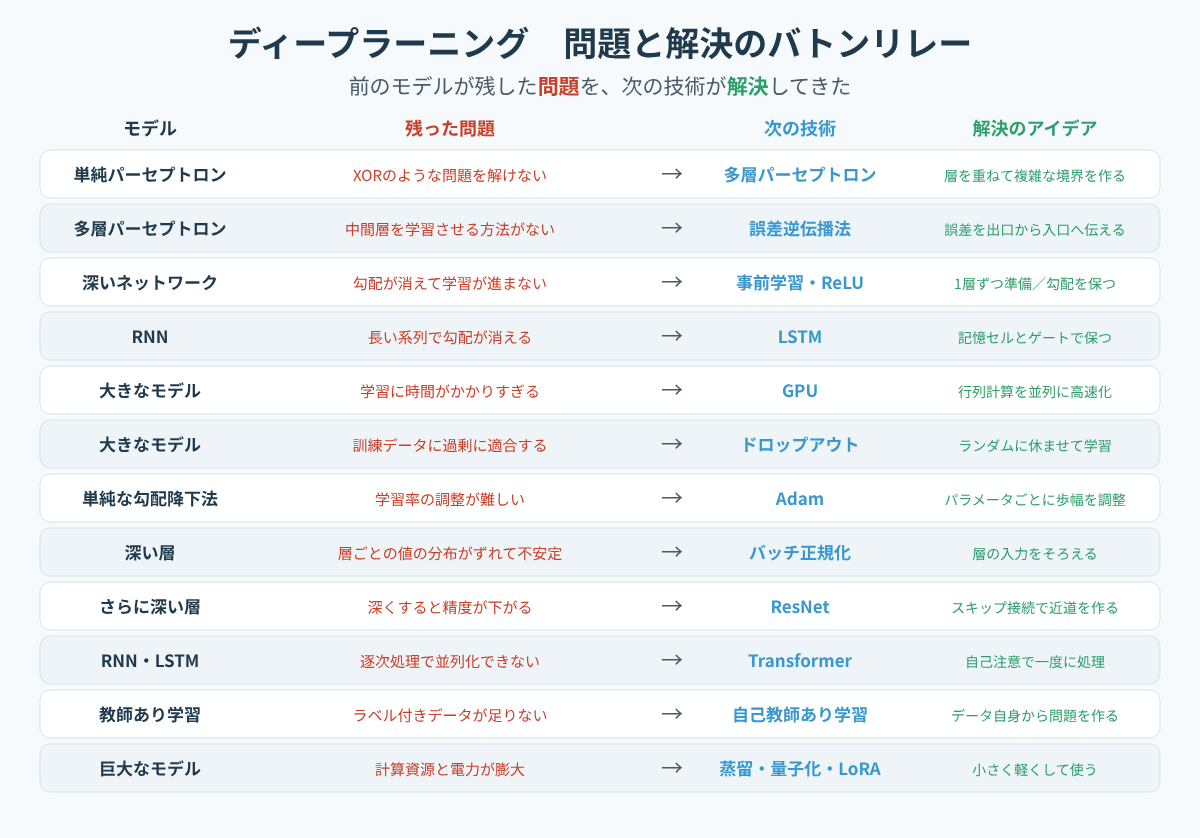
80年以上にわたるディープラーニングの歴史を振り返ると、いくつかのパターンが見えてきます。
波と冬を繰り返してきた
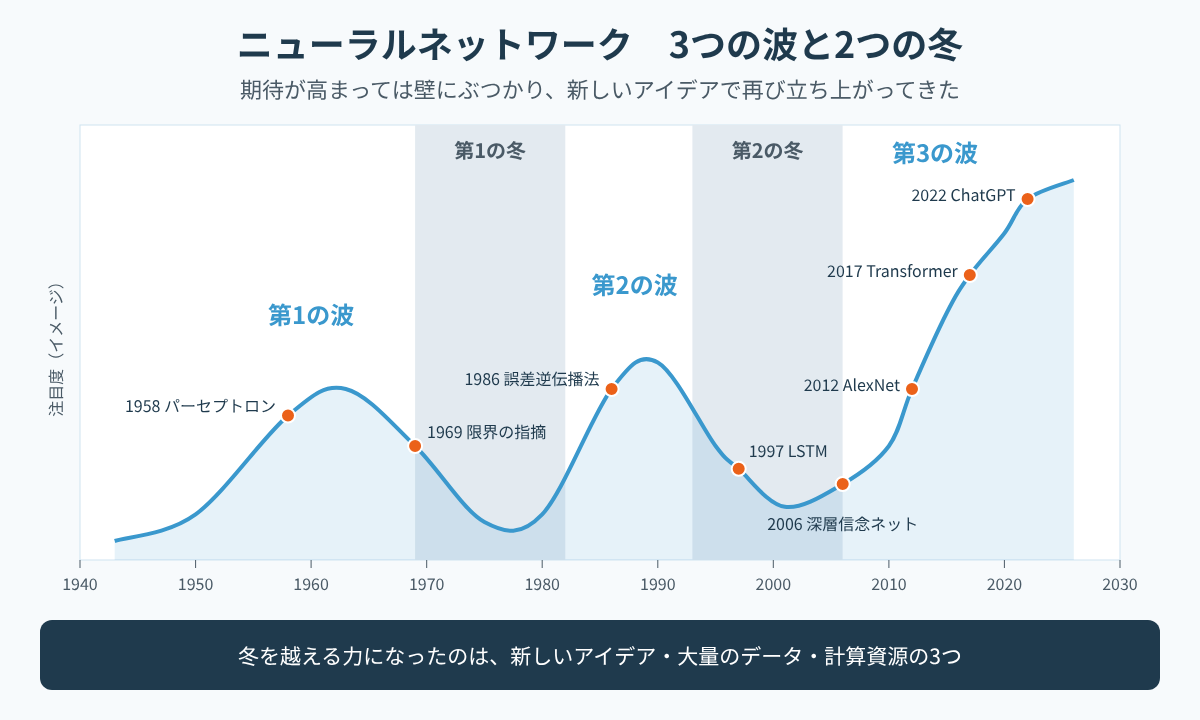
ニューラルネットワークの研究は、3つの波と2つの冬を経験してきました。パーセプトロンへの期待と XOR の壁、誤差逆伝播法への期待と勾配消失の壁、そして2012年から続く3度目の波です。期待が高まり、壁にぶつかり、新しいアイデアで再び立ち上がるという流れを繰り返しています。
なお、G検定などで学ぶ「AI ブーム」の区分(第1次は推論と探索、第2次は知識表現とエキスパートシステム、第3次は機械学習とディープラーニング)は、AI 全体の流行を表したものです。ここで紹介したニューラルネットワークの研究の波とは、時期も内容も異なります。研修では、2つを混同しないように伝えてください。
アイデアは、データと計算資源を待っていた
2つ目のパターンは、アイデアが生まれてから実を結ぶまでに、長い時間がかかっていることです。誤差逆伝播法の考え方は1960年代から1980年代に、CNN の原型は1979年に、LSTM は1997年に生まれていました。これらが大きな成果を上げたのは、GPU と大量のデータがそろった2010年代です。アイデア、データ、計算資源の3つがそろったときに、技術は大きく前進します。
勾配の通り道を作り続けてきた
3つ目のパターンは、「誤差の情報を、どうやって深い層まで届けるか」という課題が、形を変えて繰り返し現れていることです。LSTM の記憶セル、ReLU、適切な初期値、バッチ正規化、スキップ接続は、どれもこの課題への答えです。新しい構造を学ぶときにも、「勾配はどこを通って伝わるのか」という視点で見ると、設計の意図を理解しやすくなります。
研修では、新しい技術を紹介するときに「この技術は、学習のどの問題を解決するために生まれたのか」を必ず問いかけてみてください。受講者は、用語を暗記するのではなく、技術どうしのつながりとして理解できるようになります。
確認問題
ディープラーニングの歴史について、正しい説明を1つ選んでください。
- 単純なパーセプトロンは、1本の直線で XOR の問題を解くことができる
- ReLU は、入力が正のとき微分が 1 になり、勾配が消えにくくなる
- 誤差逆伝播法は、誤差を入口から出口へ伝えて重みを決める方法である
- バッチ正規化は、層を飛び越える近道を作って学習を助ける方法である
解答と解説
正解は 2 です。
- 1 は誤りです。XOR は 1 になる点と 0 になる点が互い違いに並ぶため、1本の直線では分けられません。層を重ねる必要があります
- 2 は正しい説明です。シグモイド関数の微分は最大でも 0.25 ですが、ReLU は入力が正なら微分が 1 なので、層をさかのぼっても勾配が小さくなりにくくなります
- 3 は誤りです。誤差逆伝播法は、出力の誤差を出口から入口に向かって伝え、各層の重みの勾配を計算します
- 4 は誤りです。層を飛び越える近道(スキップ接続)を作るのは ResNet です。バッチ正規化は、層に入るデータの平均とばらつきをそろえる方法です
研修で使うときの進め方
講師向けに、この物語を研修で使う進め方の一例を示します。
- 序章の「AI・機械学習・ディープラーニング」の関係を図に描いて確認する
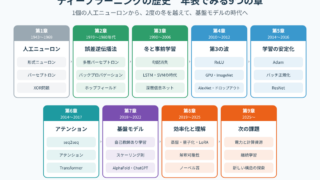
- 年表の図を示し、9つの章の全体像を先に見せる
- パーセプトロンの数値例を受講者に手で計算してもらい、XOR の4つの点を直線1本で分けられないことを、紙の上で試してもらう
- 勾配降下法の数値例(0 → 0.6 → 1.08)を、3回目まで受講者に計算してもらう
- 0.25 を10回掛ける計算を電卓で行い、勾配消失を体感してもらう
- 各章の「ここで確認」の問いを、個人またはペアで答えてもらう
- 3つの波と2つの冬の図、問題と解決のバトンリレーの図で、全体のつながりを振り返る
- グループワークとして、「活性化関数、最適化手法、正規化、スキップ接続は、それぞれ学習のどの問題を解決しているか」を、自分の言葉で説明し合ってもらう
Python の演習と組み合わせる場合は、活性化関数をシグモイド関数にした深いネットワークと、ReLU にしたネットワークで、学習の進み方を比べる実験がおすすめです。歴史上の問題と解決を、自分の目で確かめられます。
まとめ
- ディープラーニングは、1943年の形式ニューロンと1958年のパーセプトロンから始まり、XOR の壁で最初の冬を迎えた
- 誤差逆伝播法は、出力の誤差を入口に向かって伝えることで、多層のネットワークの学習を可能にした
- 深い層では勾配が消える問題が現れ、2度目の冬を迎えたが、LSTM、事前学習、ReLU がこの問題を和らげた
- 2012年、アイデア、GPU、大量のデータがそろい、AlexNet をきっかけに3度目の波が始まった
- Adam、バッチ正規化、ResNet が学習を安定させ、Transformer が汎用の部品になり、自己教師あり学習と大規模化が基盤モデルを生んだ
- 現在は、電力と計算資源、継続学習、内部の理解、Transformer の次の構造の探索が課題になっている
次の学習ステップとしては、中間の層が1つの小さなネットワークで、誤差逆伝播法の計算を手で1回分たどってみる流れをおすすめします。行列の積と微分の連鎖律がそろえば計算できるため、線形代数や微分の学習ともつながり、フレームワークが自動で行っている計算の中身を具体的に理解できます。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 山崎講師2026年11月15日機械学習の歴史を物語で学ぶ|最小二乗法からパーセプトロン、決定木、SVM、ランダムフォレスト、勾配ブースティング、表形式基盤モデルまで
 山崎講師2026年11月15日オプティマイザの歴史を物語で学ぶ|勾配降下法からモーメンタム、AdaGrad、RMSProp、Adam、AdamW、Muonまで
 山崎講師2026年11月15日ディープラーニングの歴史を物語で学ぶ|パーセプトロンから誤差逆伝播法、2度の冬、AlexNet、Transformer、基盤モデルまで
 山崎講師2026年11月15日コンピュータビジョンの歴史を物語で学ぶ|猫の脳の実験からAlexNet、ResNet、YOLO、ViT、CLIP、SAM、ロボットの目まで