自然言語処理の歴史を物語で学ぶ|ELIZAから統計的機械翻訳、word2vec、Transformer、BERT、ChatGPT、AIエージェントまで
 山崎講師
こんにちは。ゆうせいです。
自然言語処理(NLP)の研修では、形態素解析、TF-IDF、word2vec、LSTM、Transformer、BERT、GPT、RAG と、時代も考え方も異なる用語が一度に登場します。受講者から「どれが今も使われていて、どれが昔の技術なのか」「なぜ次々と新しい方法が出てくるのか」と質問されることも多いのではないでしょうか。
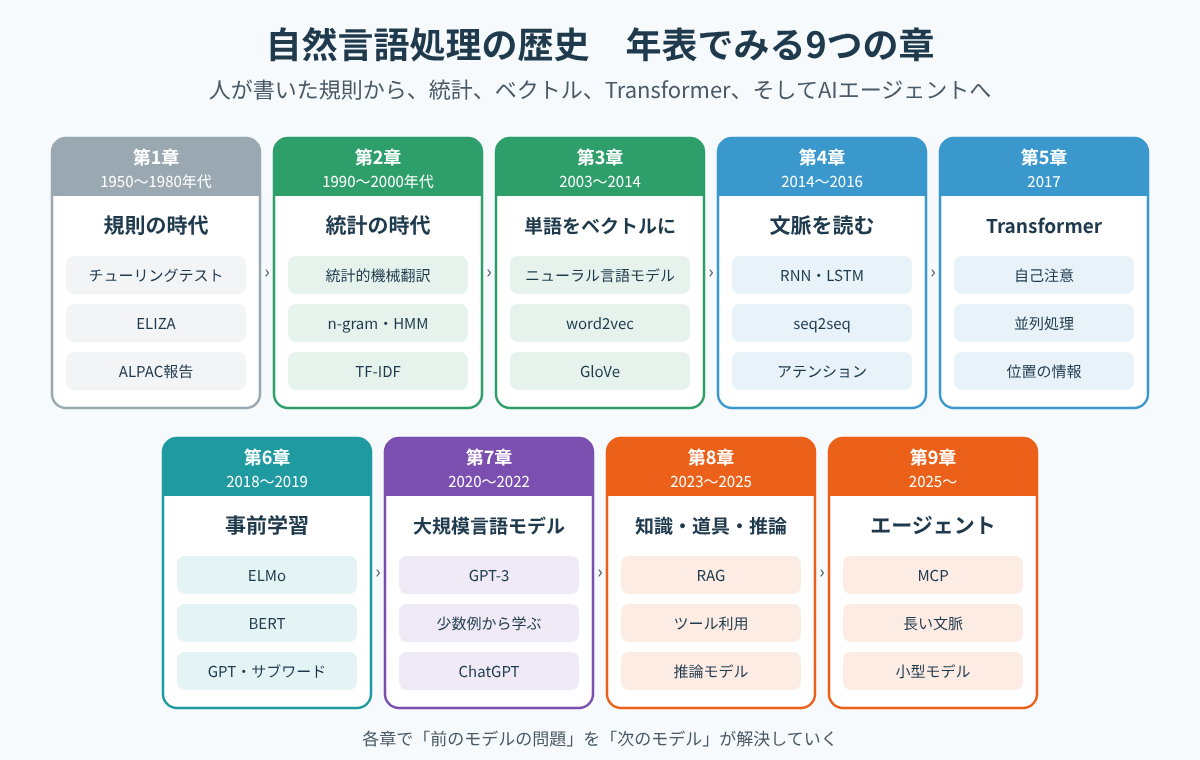
自然言語処理の歴史も、「前の方法が抱えていた問題を、次の方法が解決する」という流れで並べると、1本の物語として理解できます。今回は、自然言語処理の歴史を、その始まりから2026年の最新の動向まで、物語の形でたどります。各章の終わりには、受講者の理解を確かめる問いを用意しました。新人エンジニア研修や、G検定・E資格の学習に活用してください。
序章 自然言語処理とは何か
自然言語とは、日本語や英語のように、人間が日常的に使う言葉のことです。プログラミング言語のように人工的に作られた言語と区別するために、「自然」言語と呼びます。自然言語処理は、コンピュータに自然言語を理解させたり、作らせたりする技術の総称です。
代表的な仕事(タスク)には、次のようなものがあります。
- 機械翻訳:日本語の文章を英語に訳す
- 文書分類:メールが迷惑メールかどうかを判定する
- 情報検索:質問に関係する文書を探し出す
- 対話:人の質問に答えたり、会話を続けたりする
- 要約:長い文章を短くまとめる
自然言語処理が難しいのは、言葉が曖昧だからです。例えば「黒い目の大きな猫」は、目が黒いのか、猫が黒いのか、目が大きいのか、猫が大きいのかで、いくつもの読み方ができます。人間は文脈や常識から自然に意味を選びますが、コンピュータにとっては簡単ではありません。この「曖昧さ」との戦いが、自然言語処理の歴史の中心にあります。
第1章 規則の時代(1950〜1980年代)
機械は会話できるか
自然言語処理の物語は、1950年、アラン・チューリングの問いから始まります。チューリングは論文「計算する機械と知性」の中で、文字のやり取りだけで、相手が人間か機械かを見分けられるかを試す方法(模倣ゲーム、後にチューリングテストと呼ばれる)を提案しました。言葉を扱えることが、知性を測る手がかりとして位置付けられたのです。
翻訳への期待と ALPAC 報告
1954年、アメリカのジョージタウン大学と IBM は、ロシア語の文を英語に翻訳する実験を公開しました。60あまりの文を、数百語の語彙と少数の文法規則で翻訳してみせ、「数年のうちに機械翻訳は実用になる」という大きな期待が生まれました。
1957年には、言語学者ノーム・チョムスキーが、文の構造を規則で表す生成文法の考え方を示し、言葉を規則で扱う研究に大きな影響を与えました。
1966年には、MIT のジョセフ・ワイゼンバウムが、対話プログラム ELIZA を発表しました。ELIZA は、相手の発言の中の単語に反応し、あらかじめ用意した型に当てはめて返事をするだけのプログラムでした。例えば「母が心配です」と入力すると「ご家族についてもっと話してください」と返すといった具合です。それでも、多くの人が ELIZA と本気で会話をしたと言われています。
残された問題
規則の時代の方法は、人間が文法や辞書の規則を1つずつ書く方法でした。しかし、言葉には例外が多く、規則をいくら書いても書ききれません。序章で見た曖昧さにも、規則だけでは対応できませんでした。
1966年、アメリカ政府の諮問委員会がまとめた ALPAC 報告は、機械翻訳の品質や費用対効果に厳しい評価を下しました。その結果、アメリカでは機械翻訳の研究予算が大幅に削られ、研究は長い停滞期に入ります。
ここで確認
問い:規則の時代の自然言語処理が行き詰まった主な理由は何でしょうか。
答え:人間が書く規則では、言葉の例外や曖昧さに対応しきれなかったことです。規則をいくら追加しても、現実の多様な文章をカバーできませんでした。
第2章 統計の時代(1990〜2000年代)
規則を書く代わりに、データから学ぶ
1980年代後半から1990年代にかけて、コンピュータの性能が上がり、電子化された文章(コーパス)が大量に集まるようになりました。そこで、人間が規則を書く代わりに、大量の文章から統計的な傾向を学ぶ方法が主流になります。
その象徴が、IBM の研究者たちが1990年代初めに発表した統計的機械翻訳です。英語とフランス語の対訳文を大量に集め、「この英単語は、このフランス語の単語に訳されることが多い」という確率を学習しました。文法の規則を書かなくても、データから翻訳の傾向を学べることを示したのです。
同じ時期には、直前の単語から次の単語の確率を求める n-gram モデル、品詞(名詞・動詞など)を推定する隠れマルコフモデル(HMM)、文章をいくつかの種類に分類する機械学習の手法などが広く使われるようになりました。日本語では、文章を単語に区切って品詞を付ける形態素解析のツールが整備され、検索や分析の土台になりました。
TF-IDF:単語の重要度を測る
文書の検索や分類でよく使われたのが、単語の重要度を数値にする TF-IDF です。

各記号の意味は次のとおりです。
- tf(t, d):文書 d の中に単語 t が出てくる回数
- N:全体の文書の数
- df(t):単語 t が出てくる文書の数
- log の部分(IDF):多くの文書に出てくる単語ほど小さくなる値
数値で確認します。文書が全部で 1000 件あり、「強化学習」という単語が 10 件の文書にだけ出てくるとします。ある文書に「強化学習」が 3 回出てくると、log の底を 10 として、3 × log(1000/10) = 3 × 2 = 6 になります。一方、「です」のように 1000 件すべての文書に出てくる単語は、log(1000/1000) = log 1 = 0 なので、何回出てきても重要度は 0 です。
「その文書によく出てきて、他の文書にはあまり出てこない単語ほど重要」という考え方は、現在の検索システムでも基礎として使われています。
残された問題
統計の時代の方法には、根本的な問題がありました。単語を、意味を持たない「記号」として扱っていたことです。
例えば、「犬」と「猫」はどちらも動物で、意味が近い単語です。しかし、記号として扱うと、「犬」と「猫」の関係は、「犬」と「自動車」の関係と区別できません。そのため、「犬が好き」という文章で学んだことを、「猫が好き」という文章に生かせませんでした。また、良い性能を出すには、人間が「どのような特徴を使うか」を細かく設計する必要があり、多くの手間がかかりました。
ここで確認
問い:統計の時代の方法では、単語の扱い方にどのような問題があったのでしょうか。
答え:単語を意味を持たない記号として扱っていたため、「犬」と「猫」のように意味が近い単語の関係を捉えられないことです。
第3章 単語をベクトルに(2003〜2014)
意味は「周りの単語」で決まる
この問題を解決したのが、単語を数値の並び(ベクトル)で表し、意味が近い単語ほど近いベクトルにする考え方です。
その土台には、言語学の分布仮説があります。「単語の意味は、その単語の周りに出てくる単語によって決まる」という考え方です。「犬」も「猫」も、「散歩」「えさ」「かわいい」「飼う」といった単語と一緒に出てくることが多いので、意味が近いと考えられます。
2003年、ヨシュア・ベンジオらは、ニューラルネットワークを使って単語のベクトルと次の単語の確率を同時に学ぶ、ニューラル言語モデルを発表しました。
word2vec:単語の計算
2013年、Google のトマス・ミコロフらが発表した word2vec は、大量の文章から単語ベクトルを高速に学習できるようにし、一気に広まりました。
word2vec の単語ベクトルは、意味の関係を計算できることで有名になりました。「王様」のベクトルから「男性」のベクトルを引き、「女性」のベクトルを足すと、「女王」のベクトルに近くなる、という例がよく知られています。
単語どうしの意味の近さは、ベクトルのコサイン類似度で測ります。

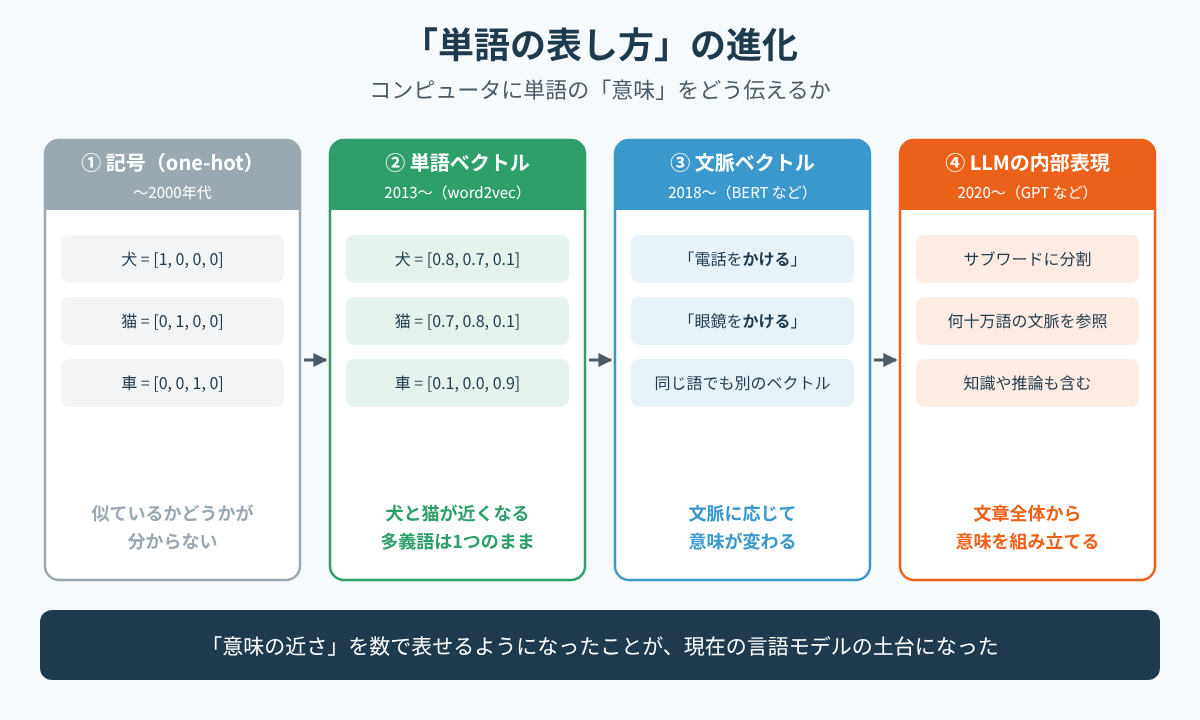
数値で確認します。説明のために、3つの数で表した単語ベクトルを使います。犬 = (0.8, 0.7, 0.1)、猫 = (0.7, 0.8, 0.1)、車 = (0.1, 0.0, 0.9) とすると、犬と猫のコサイン類似度は約 0.99、犬と車のコサイン類似度は約 0.18 になります。値が 1 に近いほど意味が近いことを表し、犬と猫が近く、犬と車が遠いことを数値で確かめられます。
2014年には、スタンフォード大学のグループが、文章全体の単語の出現の統計を使う GloVe を発表しています。
残された問題
word2vec の単語ベクトルには、2つの問題がありました。
1つ目は、1つの単語に1つのベクトルしか持てないことです。「電話をかける」と「眼鏡をかける」の「かける」は意味が違いますが、同じベクトルで表されてしまいます。
2つ目は、単語ベクトルだけでは、語順や文全体の流れを扱えないことです。「犬が猫を追う」と「猫が犬を追う」は、使われている単語が同じでも意味が違います。
ここで確認
問い:word2vec は、統計の時代のどのような問題を解決したのでしょうか。また、どのような問題が残ったのでしょうか。
答え:単語を意味の近さが表れるベクトルで表すことで、「犬」と「猫」が似ていることを捉えられるようにしました。一方で、1つの単語に1つのベクトルしかないため多義語を区別できず、語順や文脈も扱えない問題が残りました。
第4章 文脈を読む:RNN、seq2seq、アテンション(2014〜2016)
前の単語を覚えながら読む
文の流れを扱うために使われたのが、RNN(再帰型ニューラルネットワーク)です。RNN は、単語を1つずつ順番に読み、それまでに読んだ内容を「記憶」として次の単語に持ち回ります。記憶を長く保てるように工夫した LSTM も広く使われました。
2014年には、文章を読み込む RNN(エンコーダ)と、別の文章を書き出す RNN(デコーダ)を組み合わせた seq2seq(系列変換モデル)が発表されました。翻訳元の文を読み込んで1つのベクトルにまとめ、そのベクトルから翻訳先の文を書き出す仕組みです。
アテンション:必要な単語に注目する
seq2seq には、長い文を1つのベクトルに詰め込むため、文が長くなると情報が抜け落ちるという問題がありました。
これを解決したのが、2014年にドミトリー・バダナウらが提案したアテンション(注意機構)です。翻訳先の単語を1つ書くたびに、翻訳元の文のどの単語に注目すべきかを計算し、必要な部分の情報を参照します。人間の翻訳者が、訳しながら原文の該当部分を何度も見返すのと同じ考え方です。
2016年、Google はこうした仕組みを使ったニューラル機械翻訳を Google 翻訳に導入し、翻訳の品質が大きく向上しました。
残された問題
RNN には、根本的な問題が残っていました。単語を1つずつ順番に処理するため、計算を並列化できず、大量のデータで学習するのに時間がかかります。また、文が長くなると、前のほうの単語の影響が薄れていく傾向がありました。
ここで確認
問い:アテンションは、seq2seq のどのような問題を解決したのでしょうか。
答え:長い文を1つのベクトルに詰め込むため情報が抜け落ちる問題です。出力する単語ごとに、入力の文のどの単語に注目すべきかを計算し、必要な情報を直接参照できるようにしました。
第5章 Transformer:すべての単語を一度に見る(2017)
Attention Is All You Need
2017年、Google の研究者たちは、論文「Attention Is All You Need」で Transformer を発表しました。論文の題名のとおり、Transformer は RNN を使わず、アテンションの仕組みだけで文章を処理します。
Transformer の中心にあるのが、自己注意(Self-Attention)です。文の中のすべての単語が、他のすべての単語との関連の強さを一度に計算します。

各記号の意味は次のとおりです。
- Q(クエリ):注目する側の単語が「何を探しているか」を表すベクトル
- K(キー):注目される側の単語が「どのような情報を持っているか」を表すベクトル
- V(バリュー):注目される側の単語が渡す情報そのもの
- d_k:ベクトルの次元数。√d_k で割ることで、値が大きくなりすぎるのを防ぐ
- softmax:数値の並びを、合計が 1 になる割合に変換する関数
図書館にたとえると、クエリは「探している本のテーマ」、キーは「本の背表紙のラベル」、バリューは「本の中身」です。テーマとラベルがよく合う本ほど、中身を多く読み取ります。
数値で確認します。ある単語のクエリと、3つの単語のキーとの関連の強さ(内積を √d_k で割った値)が 2, 1, 0 だったとします。softmax をかけると、約 0.67, 0.24, 0.09 になります。最も関連の強い1つ目の単語の情報を 67% の割合で取り込み、残りの単語の情報も少しずつ取り込みます。
何が変わったのか
自己注意は、すべての単語の組み合わせを同時に計算できるため、GPU で並列に処理できます。また、文の最初と最後の単語でも、間の単語を経由せずに直接関係を計算できます。第4章の「遅い」「遠い単語を忘れる」という2つの問題を、Transformer は同時に解決しました。
一方で、単語を同時に処理すると語順の情報が失われるため、Transformer は単語の位置を表す情報(位置エンコーディング)を加えて、語順を扱えるようにしています。
ここで確認
問い:Transformer の自己注意は、RNN と比べて何が優れていたのでしょうか。
答え:すべての単語どうしの関係を一度に計算するため、並列に処理できて学習が速くなり、離れた単語どうしの関係も直接捉えられるようになりました。
第6章 事前学習の時代:ELMo、BERT、GPT(2018〜2019)
文脈に応じた単語のベクトル
第3章で残った「多義語を区別できない」問題を解決したのが、文脈に応じて単語のベクトルを変える方法です。2018年に発表された ELMo は、文全体を読んだうえで、それぞれの単語のベクトルを作りました。「電話をかける」と「眼鏡をかける」の「かける」は、文脈が違うので、別のベクトルになります。
先に大量の文章で学ぶ
それまでの自然言語処理では、翻訳、分類、質問応答など、タスクごとに人が正解を付けたデータ(ラベル付きデータ)を用意して、一からモデルを学習させていました。しかし、ラベル付きデータを大量に作るには、大きな手間と費用がかかります。
2018年、この問題を解決する方法として、事前学習と微調整(ファインチューニング)の組み合わせが広まりました。
- 事前学習:インターネット上などの大量の文章を使い、正解ラベルなしで言葉の一般的な知識を学ぶ
- 微調整:事前学習したモデルを、少量のラベル付きデータで、特定のタスク向けに調整する
2018年6月、OpenAI は Transformer を使って「次の単語を予測する」事前学習を行う GPT を発表しました。同じ年の10月、Google は BERT を発表しました。BERT は、文の一部の単語を隠し(マスクし)、前後の両方の文脈から隠された単語を当てる方法で事前学習を行います。BERT は多くのタスクで当時の最高性能を更新し、2019年には Google 検索にも使われるようになりました。
未知語と日本語の分かち書き
単語を単位にすると、辞書にない新しい単語(未知語)を扱えないという問題もありました。また、日本語は英語のように単語の間に空白がないため、単語の区切り方そのものが難しい言語です。
この問題には、単語をさらに細かい部品(サブワード)に分ける方法が使われるようになりました。よく出てくる文字の組み合わせを1つの部品としてまとめる BPE や、空白のない言語にもそのまま使える SentencePiece(2018年)などです。例えば、辞書にない単語でも、知っている部品の組み合わせとして表せます。現在の言語モデルの多くは、このようなサブワード(トークン)を単位にして文章を扱っています。
残された問題
事前学習によって、必要なラベル付きデータは大幅に減りました。それでも、タスクごとに微調整のためのデータを用意し、モデルを学習し直す必要がありました。
ここで確認
問い:BERT のような事前学習モデルは、それまでの自然言語処理のどのような問題を解決したのでしょうか。
答え:タスクごとに大量のラベル付きデータを用意して一から学習する必要があった問題です。大量の文章で先に言葉の一般的な知識を学ぶことで、少量のラベル付きデータで各タスクに対応できるようにしました。
第7章 大規模言語モデル:GPT-3 から ChatGPT へ(2020〜2022)
微調整なしで、例を見せるだけで解く
2020年、OpenAI は GPT-3 を発表しました。GPT-3 は、それまでのモデルよりはるかに大きく、大量の文章で事前学習されていました。
GPT-3 が示したのは、モデルを微調整しなくても、指示文(プロンプト)の中にいくつかの例を書くだけで、新しいタスクをこなせるということです。例えば、「英語:apple → 日本語:りんご」という例を2〜3個見せてから「英語:dog → 日本語:」と書くと、続きに「犬」と書きます。このように、プロンプトの中の例から学ぶ能力は、文脈内学習(インコンテキスト学習)と呼ばれます。
同じ年には、モデルの大きさ、データの量、計算量を増やすと、性能が予測可能な形で向上するというスケーリング則も報告されました。2022年には、「段階的に考えてください」と促したり、途中の考え方を含む例を見せたりすると、推論の問題の正答率が上がるという Chain-of-Thought(思考の連鎖)の手法も発表されています。
残された問題と ChatGPT
GPT-3 は流暢な文章を書けましたが、人間の指示に素直に従うとは限らず、不適切な内容や事実と異なる内容を出力することもありました。「次の単語をうまく予測すること」と「人間にとって役に立つ回答をすること」は同じではなかったのです。
この問題に対して、OpenAI は人間の評価を使った強化学習(RLHF)で言語モデルを調整し、2022年11月に ChatGPT を公開しました。自然言語処理は、研究者や技術者のための技術から、誰もが日常的に使う道具へと大きく変わりました。RLHF の詳しい物語は、強化学習の歴史の記事で紹介しています。
ここで確認
問い:GPT-3 の「文脈内学習」とは、どのような能力でしょうか。
答え:モデルを微調整しなくても、プロンプトの中に書かれたいくつかの例を見るだけで、新しいタスクのやり方をつかんで解く能力です。
第8章 知識・道具・推論(2023〜2025)
もっともらしい誤りと、古い知識
ChatGPT が広く使われるようになると、新しい問題が目立つようになりました。
1つ目は、事実と異なる内容を、もっともらしく答えてしまう問題です。この現象はハルシネーション(幻覚)と呼ばれます。
2つ目は、知識が古いという問題です。言語モデルの知識は、学習に使った文章の時点で止まっているため、それ以降の出来事や、社内の資料のように学習に含まれていない情報には答えられません。
RAG:調べてから答える
これらの問題への代表的な解決策が、RAG(Retrieval-Augmented Generation:検索拡張生成)です。2020年に発表された手法で、ChatGPT の登場後、企業での活用を中心に広く使われるようになりました。
RAG は、質問に関係する文書を検索して取り出し、その内容をプロンプトに加えてから、言語モデルに回答させます。試験にたとえると、記憶だけで答える「持ち込み不可」の試験から、資料を見ながら答える「持ち込み可」の試験に変える方法です。根拠となる資料を示せるため、回答を確かめやすくなる利点もあります。第2章の TF-IDF のような検索技術と、第3章の単語ベクトルの考え方を発展させた文のベクトル検索が、ここで再び活躍します。
道具を使い、考えてから答える
2023年には、言語モデルが外部の関数や API を呼び出すツール利用(関数呼び出し)の仕組みが広まりました。計算は電卓に、最新の情報は検索エンジンに任せるといった形で、言語モデルが苦手な部分を道具で補えるようになりました。同じ年に発表された GPT-4 などでは、文章だけでなく画像も理解できるマルチモーダル化も進んでいます。
2024年から2025年にかけては、OpenAI の o1 や DeepSeek-R1 のように、答える前に長く考える推論モデルが登場しました。強化学習によって考える過程を学ばせることで、数学やプログラミングの問題で大きく性能を伸ばしています。
ここで確認
問い:RAG は、言語モデルのどのような問題を解決するための方法でしょうか。
答え:知識が学習時点で止まっていて古いことや、学習していない情報に答えられないこと、もっともらしい誤りを出力することです。関係する文書を検索してプロンプトに加えることで、根拠に基づいた回答を作れるようにしました。
第9章 エージェントの時代へ(2025〜)
会話から、仕事へ
2025年から2026年にかけて、言語モデルの使われ方は、質問に答える「会話」から、複数の手順を自分で進めて仕事をやり遂げる「AIエージェント」へと広がっています。プログラムを読み書きしてテストまで行うコーディング支援のエージェントや、調査を進めて報告書をまとめるエージェントなどが、実際の業務で使われるようになりました。
MCP:道具とつなぐ共通の規格
エージェントが増えると、新しい問題が生まれました。言語モデルと外部の道具(ファイル、データベース、業務システムなど)をつなぐ方法が、サービスごとにばらばらだったのです。道具を1つ追加するたびに、個別の接続の仕組みを作る必要がありました。
この問題に対して、2024年11月、Anthropic は AI アプリケーションと外部のシステムをつなぐ共通の規格として MCP(Model Context Protocol)を公開しました。MCP は短期間で多くの企業やサービスに採用され、2025年12月には、Linux Foundation のもとに新しく設立された Agentic AI Foundation に寄贈されています。USB の規格が決まったことで、どのメーカーの機器でも同じ差し込み口でつなげるようになったのと同じように、AI と道具をつなぐ方法の標準化が進んでいます。
長い文脈と、小さなモデル
扱える文章の長さ(コンテキストウィンドウ)も大きく伸び、本1冊分やプログラム全体を一度に読み込めるモデルも登場しています。一方で、長い文章を読み込めても、その全体を正しく使いこなして推論できるかは別の課題であり、目的によっては RAG で必要な部分だけを取り出すほうが適している場合もあります。
また、大きなモデルだけでなく、手元のパソコンやスマートフォンで動く小型のモデルや、重みが公開されたオープンなモデルの性能も向上しています。生成モデルの歴史の記事で紹介した拡散言語モデルのように、「次の単語を1つずつ予測する」以外の方法で文章を作る研究も進んでいます。
残された問題
最新の自然言語処理にも、多くの課題が残っています。
- ハルシネーション:RAG や推論モデルでも、誤りを完全になくすことはできていない
- 評価の難しさ:長い手順の仕事の出来をどう測るか
- 安全性:エージェントが外部の道具を操作するときの誤操作や悪用をどう防ぐか
- 計算資源:大規模なモデルの学習と利用に必要な電力や費用
ここで確認
問い:MCP は、AIエージェントのどのような問題を解決するために作られたのでしょうか。
答え:言語モデルと外部の道具やシステムをつなぐ方法がサービスごとにばらばらで、道具を追加するたびに個別の仕組みが必要だった問題です。共通の規格を定めることで、同じ方法でさまざまな道具とつなげるようにしました。
終章 物語を貫くパターン
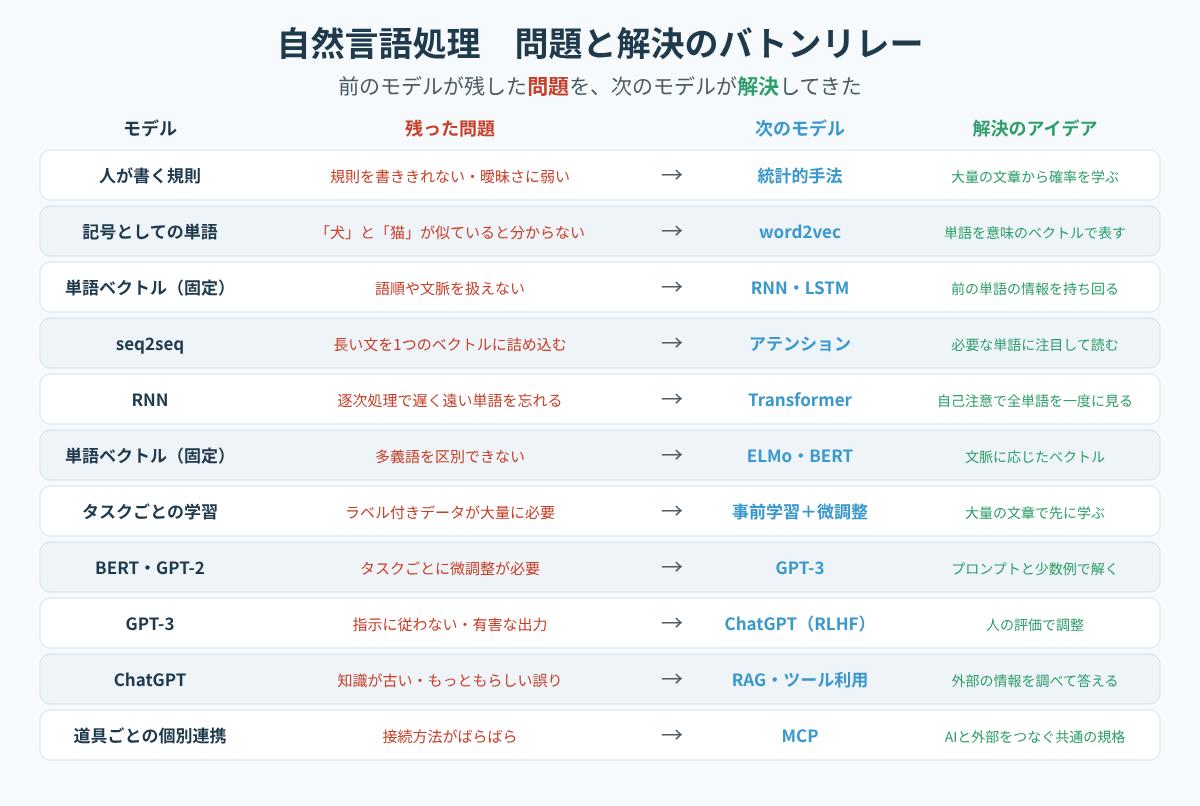
70年以上にわたる自然言語処理の歴史を振り返ると、いくつかのパターンが見えてきます。
人が教える量が減っていった
1つ目のパターンは、人間が教えなければならない量が、時代とともに減っていったことです。
- 規則の時代:人が文法や辞書の規則をすべて書いた
- 統計の時代:人が正解を付けたデータと、使う特徴を用意した
- 事前学習の時代:大量の文章から先に学び、正解付きデータは少量で済むようになった
- 大規模言語モデルの時代:プロンプトで指示や例を示すだけで、さまざまなタスクに対応できるようになった
意味を数で表す工夫
2つ目のパターンは、「単語の意味をどう表すか」という工夫の積み重ねです。記号として扱っていた単語は、意味の近さが表れるベクトルになり、文脈によって変わるベクトルになり、現在の言語モデルでは文章全体から意味を組み立てる内部表現になりました。第3章の図は、この流れをまとめたものです。
古い技術は消えずに部品になる
3つ目のパターンは、古い技術が消えるのではなく、新しい仕組みの部品として生き続けることです。TF-IDF のような検索技術は RAG の中で、n-gram の「次の単語を予測する」考え方は GPT の学習の中で、アテンションは Transformer の中心として使われ続けています。
研修では、新しい技術を紹介するときに「この技術は、どの問題を解決するために生まれたのか」「どの古い技術を部品として使っているのか」の2つを問いかけてみてください。受講者は、用語を暗記するのではなく、技術どうしのつながりとして理解できるようになります。
確認問題
自然言語処理の歴史について、正しい説明を1つ選んでください。
- word2vec は、同じ単語でも文脈に応じて別のベクトルを作れる
- Transformer は、単語を1つずつ順番に処理する RNN を改良したものである
- BERT は、ラベル付きデータだけを使って一から学習するモデルである
- RAG は、関係する文書を検索してから言語モデルに回答させる方法である
解答と解説
正解は 4 です。
- 1 は誤りです。word2vec は1つの単語に1つのベクトルしか持てません。文脈に応じたベクトルを作れるようになったのは、ELMo や BERT からです
- 2 は誤りです。Transformer は RNN を使わず、自己注意ですべての単語の関係を一度に計算します
- 3 は誤りです。BERT は、正解ラベルのない大量の文章で事前学習してから、少量のラベル付きデータで微調整します
- 4 は正しい説明です。検索した文書をプロンプトに加えることで、新しい情報や社内の情報に基づいて回答できるようにします
研修で使うときの進め方
講師向けに、この物語を研修で使う進め方の一例を示します。
- 「黒い目の大きな猫」のような曖昧な文を示し、言葉を扱う難しさを体験してもらう
- 年表の図を示し、9つの章の全体像を先に見せる
- 各章を「主人公(技術)」「立ちはだかった壁(問題)」「次の主人公への引き継ぎ(解決)」の3点で説明する
- 各章の「ここで確認」の問いを、個人またはペアで答えてもらう
- 単語の表し方の図を使い、記号からベクトル、文脈ベクトルへの変化を整理する
- 問題と解決のバトンリレーの図で、章どうしのつながりを振り返る
- グループワークとして、「自分たちの業務で AIエージェントを使うとしたら、どの問題が残るか」を話し合ってもらう
Python の演習と組み合わせる場合は、TF-IDF による文書検索、単語ベクトルのコサイン類似度の計算、事前学習済みモデルを使った文書分類の順に体験させると、歴史の流れを手を動かして確かめられます。
まとめ
- 自然言語処理は、人が規則を書く方法から始まり、言葉の例外や曖昧さに対応できずに行き詰まった
- 統計の時代は大量の文章から確率を学んだが、単語を記号として扱うため意味の近さを捉えられなかった
- word2vec は単語をベクトルで表して意味の近さを捉え、RNN とアテンションは文脈を扱えるようにした
- Transformer は自己注意で並列処理と長い文脈の把握を両立し、BERT や GPT の事前学習の土台になった
- GPT-3 はプロンプトで多くのタスクを解けることを示し、ChatGPT で自然言語処理は誰もが使う道具になった
- 現在は、RAG、ツール利用、推論モデル、MCP などにより、言語モデルが調べ、道具を使い、仕事をやり遂げるエージェントへと発展している
次の学習ステップとしては、Transformer の自己注意の計算を、小さな行列で実際に手計算してみる流れをおすすめします。行列の積、内積、softmax の3つがそろえば計算できるため、線形代数の学習とも自然につながります。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 山崎講師2026年11月15日機械学習の歴史を物語で学ぶ|最小二乗法からパーセプトロン、決定木、SVM、ランダムフォレスト、勾配ブースティング、表形式基盤モデルまで
 山崎講師2026年11月15日オプティマイザの歴史を物語で学ぶ|勾配降下法からモーメンタム、AdaGrad、RMSProp、Adam、AdamW、Muonまで
 山崎講師2026年11月15日ディープラーニングの歴史を物語で学ぶ|パーセプトロンから誤差逆伝播法、2度の冬、AlexNet、Transformer、基盤モデルまで
 山崎講師2026年11月15日コンピュータビジョンの歴史を物語で学ぶ|猫の脳の実験からAlexNet、ResNet、YOLO、ViT、CLIP、SAM、ロボットの目まで