コンピュータビジョンの歴史を物語で学ぶ|猫の脳の実験からAlexNet、ResNet、YOLO、ViT、CLIP、SAM、ロボットの目まで
 山崎講師
こんにちは。ゆうせいです。
画像認識の研修では、CNN、ResNet、YOLO、U-Net、ViT、CLIP、SAM と、多くのモデル名が登場します。受講者から「分類と検出とセグメンテーションは何が違うのか」「CNN と Transformer はどちらを学べばよいのか」と質問されることも多いのではないでしょうか。
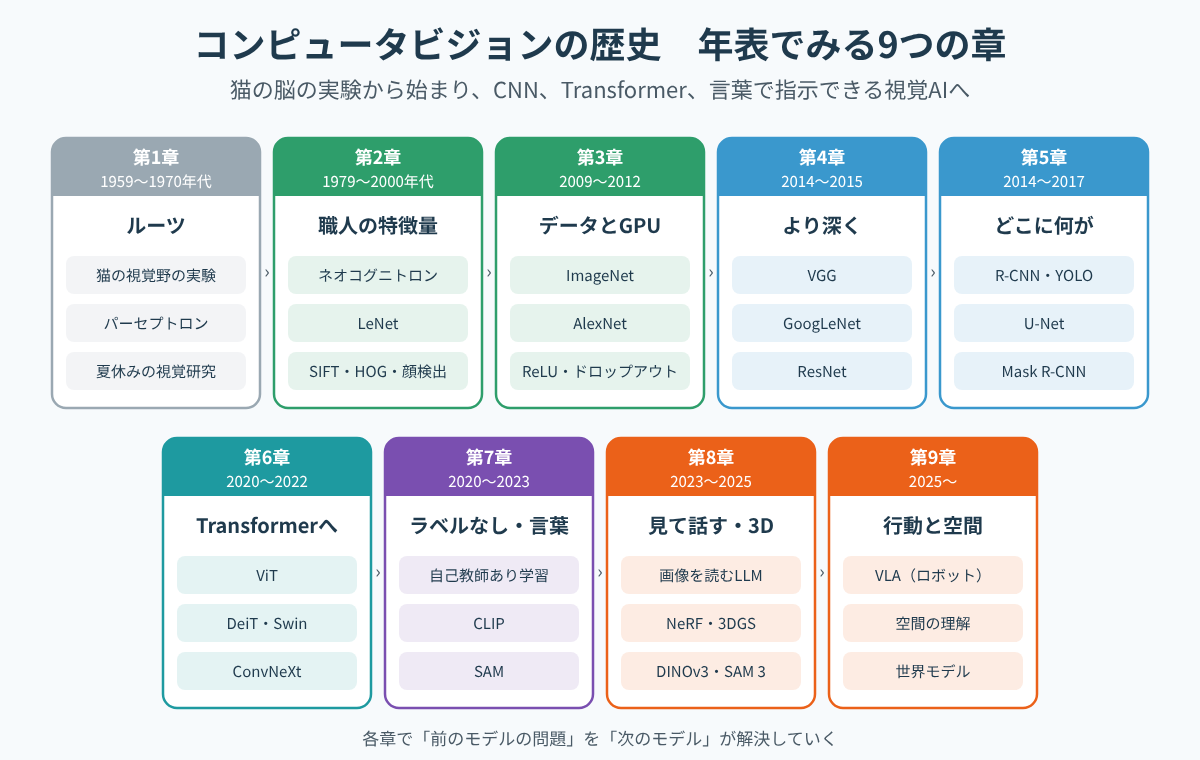
コンピュータビジョンの歴史も、「前のモデルが抱えていた問題を、次のモデルが解決する」という流れで並べると、1本の物語として理解できます。今回は、コンピュータビジョンの歴史を、その始まりから2026年の最新の動向まで、物語の形でたどります。各章の終わりには、受講者の理解を確かめる問いを用意しました。G検定・E資格の学習や、画像認識の研修の導入に活用してください。
序章 コンピュータビジョンとは何か
コンピュータビジョンは、コンピュータに画像や映像の内容を理解させる技術の総称です。人間が目で見て行っていることを、機械で実現することを目指します。
コンピュータにとって、画像は数値の並びにすぎません。白黒の画像なら、1つ1つの点(画素)の明るさを 0 から 255 の数で表した表です。カラーの画像なら、赤・緑・青の3枚の表が重なっています。人間は写真を見た瞬間に「猫だ」と分かりますが、コンピュータは何十万個もの数値の並びから「猫」を見つけ出さなければなりません。
しかも、同じ猫でも、向き、大きさ、明るさ、背景、体の一部が隠れているかどうかで、数値の並びはまったく変わります。この「見た目の変化」に負けずに中身を捉えることが、コンピュータビジョンの歴史を通じた課題です。
第1章 ルーツ:猫の脳と、夏休みの宿題(1959〜1970年代)
猫の視覚野の実験
コンピュータビジョンの物語は、意外なことに、猫の脳の実験から始まります。1959年、神経科学者のデイヴィッド・ヒューベルとトルステン・ウィーセルは、猫の脳の視覚を担当する部分(視覚野)の神経細胞が、何に反応するかを調べました。
2人が発見したのは、特定の向きの線や縁(エッジ)にだけ反応する細胞があることでした。さらに、単純な線に反応する細胞の情報を組み合わせて、より複雑な形に反応する細胞があることも分かりました。視覚は、単純な特徴を段階的に組み合わせて成り立っているのです。この発見は、後に2人にノーベル賞をもたらし、20年後の畳み込みニューラルネットワークの設計の手がかりになりました。
夏休みで解けるはずだった
1958年には、フランク・ローゼンブラットが、学習する機械パーセプトロンを発表しています。そして1966年、マサチューセッツ工科大学(MIT)では、「夏休みの間に、学生たちの手でコンピュータに物を見分けさせる」という研究計画が立てられました。当時の研究者たちは、視覚の問題は一夏で解決できると考えていたのです。
実際には、その解決に半世紀以上かかることになります。
残された問題
当時の方法は、画像から線や縁を取り出し、人間が考えた規則に当てはめて形を判断するものでした。積み木のような単純な物体なら扱えましたが、現実の写真は、影、重なり、背景の模様などがあまりに複雑で、規則を書ききることができませんでした。
ここで確認
問い:ヒューベルとウィーセルの実験は、後の画像認識にどのような手がかりを与えたのでしょうか。
答え:視覚が、線や縁のような単純な特徴に反応する細胞と、それらを組み合わせて複雑な形に反応する細胞の段階的な仕組みで成り立っていることです。この考え方が、畳み込みニューラルネットワークの層の構造につながりました。
第2章 職人が作る特徴量と、早すぎた CNN(1979〜2000年代)
ネオコグニトロンと LeNet
1979年、日本の福島邦彦は、猫の視覚野の仕組みをまねたニューラルネットワーク、ネオコグニトロンを発表しました。単純な特徴を取り出す層と、位置のずれを吸収する層を交互に重ねる構造は、現在の畳み込みニューラルネットワーク(CNN)の原型です。
1989年、ヤン・ルカンらは、この構造を誤差逆伝播法で学習させ、手書きの郵便番号を読み取ることに成功しました。1998年に発表された LeNet-5 は、手書き数字の認識で高い精度を示し、小切手の読み取りなどに実用化されました。
畳み込みの計算
CNN の中心になる計算が、畳み込みです。小さな数値の表(フィルター)を画像の上で少しずつずらしながら、重なった部分の数値を掛けて足し合わせます。

各記号の意味は次のとおりです。
- x_ij:画像の一部(フィルターと重なった部分)の、i 行 j 列目の画素の値
- w_ij:フィルターの i 行 j 列目の値(重み)
- y:その位置での出力。フィルターが探している模様に、画像がどれだけ合っているかを表す
数値で確認します。左側が暗く(0)、右端が明るい(1)画像の一部と、縦の縁を探すフィルターを用意します。

同じ位置の数どうしを掛けて足すと、左の列は 0 × (-1) が3つで 0、中央の列は 0、右の列は 1 × 1 が3つで 3 なので、出力は 3 です。一方、全体が同じ明るさ(すべて 1)の部分では、-1 が3つ、0 が3つ、1 が3つで、出力は 0 になります。縦の縁がある場所でだけ大きな値が出るため、このフィルターは「縦の縁の検出器」として働きます。
ヒューベルとウィーセルが見つけた「特定の向きの線に反応する細胞」を、計算で再現したものと言えます。CNN の重要な点は、フィルターの値を人間が決めるのではなく、学習によって自動的に決めることです。
主流は手作りの特徴量だった
しかし、1990年代から2000年代にかけて、CNN は主流にはなりませんでした。当時のコンピュータの性能と画像データの量では、大きな CNN を学習させることができなかったためです。
この時代の主役は、研究者が工夫を凝らして設計した特徴量でした。画像の拡大・縮小や回転に強い SIFT(1999年)、明るさの変化の向きを集計する HOG(2005年)、そして2001年にポール・ヴィオラとマイケル・ジョーンズが発表した高速な顔検出の方法などです。デジタルカメラの顔検出機能は、この時代の技術から生まれました。取り出した特徴量を、サポートベクターマシン(SVM)などの機械学習の手法で分類するのが、標準的な方法でした。
残された問題
手作りの特徴量には、設計に専門知識と長い時間が必要という問題がありました。顔のような特定の対象ではうまくいっても、あらゆる物体を見分ける一般的な物体認識では、精度が頭打ちになっていました。
ここで確認
問い:CNN のフィルターと、SIFT や HOG のような手作りの特徴量は、何が違うのでしょうか。
答え:手作りの特徴量は、画像のどこに注目するかを人間が設計します。CNN のフィルターは、値を学習によってデータから自動的に決めます。
第3章 データと GPU がそろう:ImageNet と AlexNet(2009〜2012)
足りなかったのはデータだった
2000年代の後半、スタンフォード大学のフェイフェイ・リーらは、アルゴリズムの改良ではなく、データに注目しました。子どもは、何年もかけて膨大な数の物を見て育ちます。コンピュータにも、それに匹敵する量の画像が必要ではないか、と考えたのです。
リーらは、インターネット上の画像を集め、世界中の人々の協力を得て1枚ずつラベルを付けました。2009年に公開された ImageNet は、最終的に2万以上の種類、1400万枚以上の画像を集めた巨大なデータセットになりました。2010年からは、ImageNet の一部(1000種類、約120万枚)を使って認識の精度を競う大会 ILSVRC が毎年開かれるようになります。
2012年の衝撃
2012年の大会で、トロント大学のアレックス・クリジェフスキー、イリヤ・サツケバー、ジェフリー・ヒントンのチームが、深い CNN である AlexNet で優勝しました。上位5つの予測に正解が入らない割合(エラー率)は約15%で、手作りの特徴量を使った2位の約26%に、10ポイント以上の差を付けました。
AlexNet の構造そのものは、LeNet を大きくしたものです。成功の鍵は、次の組み合わせにありました。
- 大量のデータ:ImageNet の約120万枚の画像
- GPU:ゲーム用の画像処理装置を計算に使い、学習時間を大幅に短縮した
- ReLU:学習を速く進められる活性化関数
- ドロップアウト:学習中にニューロンをランダムに休ませ、訓練データへの過剰な適合(過学習)を防ぐ方法
第2章で「早すぎた」CNN は、データと計算資源がそろったことで、一気に主役になりました。この年を境に、画像認識の研究は深層学習へと大きく舵を切ります。
ここで確認
問い:AlexNet の成功を支えた要素を、アルゴリズム以外の面から2つ挙げてください。
答え:ImageNet という大量のラベル付き画像データと、学習を高速に行うための GPU です。
第4章 より深く:VGG から ResNet へ(2014〜2015)
深くすれば賢くなるはずだった
AlexNet の成功を受けて、研究者たちは CNN の層を増やし始めました。2014年の VGG は 16〜19層、同じ年の GoogLeNet は 22層まで深くなり、精度も向上しました。層を重ねるほど、単純な線から、模様、部品、物体全体へと、より複雑な特徴を捉えられるからです。
深くすると学習が進まない
ところが、層をさらに増やすと、かえって精度が下がるという問題が現れました。過学習ではなく、訓練データに対する精度そのものが悪くなったのです。誤差の情報を出口から入口へ伝える途中で情報が弱まり、深いネットワークをうまく学習させられないことが原因でした。
ResNet:近道を作る
2015年、マイクロソフトの研究者カイミン・ヒー(何愷明)らは、ResNet(残差ネットワーク)を発表しました。アイデアは、層を飛び越える近道(スキップ接続)を足すという単純なものです。

各記号の意味は次のとおりです。
- x:ブロックへの入力
- F(x):ブロック内の層が学習する変換
- y:ブロックの出力。変換した結果に、入力そのものを足したもの
数値で確認します。入力が x = 2 で、層の変換が F(x) = 0.1 なら、出力は 2.1 です。もし、その層が何も学ぶ必要がなければ、F(x) = 0 になるだけで、出力は入力と同じ 2 のままです。層を追加しても、少なくとも「何もしない」状態を簡単に作れるため、深くしても精度が下がりにくくなります。
それまでの層は、望ましい出力をゼロから作る必要がありました。ResNet の層は、入力との差(残差)だけを学べばよいのです。文章の添削にたとえると、全文を書き直すのではなく、赤ペンで直す部分だけを書き込む方法です。
ResNet は 152層という深さで2015年の大会に優勝し、エラー率は約3.6%に達しました。人間が同じ課題に取り組んだ場合のエラー率は約5%と見積もられており、この課題に限れば人間を上回る水準です。スキップ接続は、その後の Transformer を含む、ほとんどすべての深層学習モデルに使われています。
ここで確認
問い:ResNet のスキップ接続は、どのような問題を解決したのでしょうか。
答え:層を深くすると学習が進まなくなり、精度がかえって下がる問題です。入力をそのまま出力に足す近道を作ることで、層は入力との差だけを学べばよくなり、非常に深いネットワークを学習できるようになりました。
第5章 どこに何があるか:検出とセグメンテーション(2014〜2017)
分類だけでは足りない
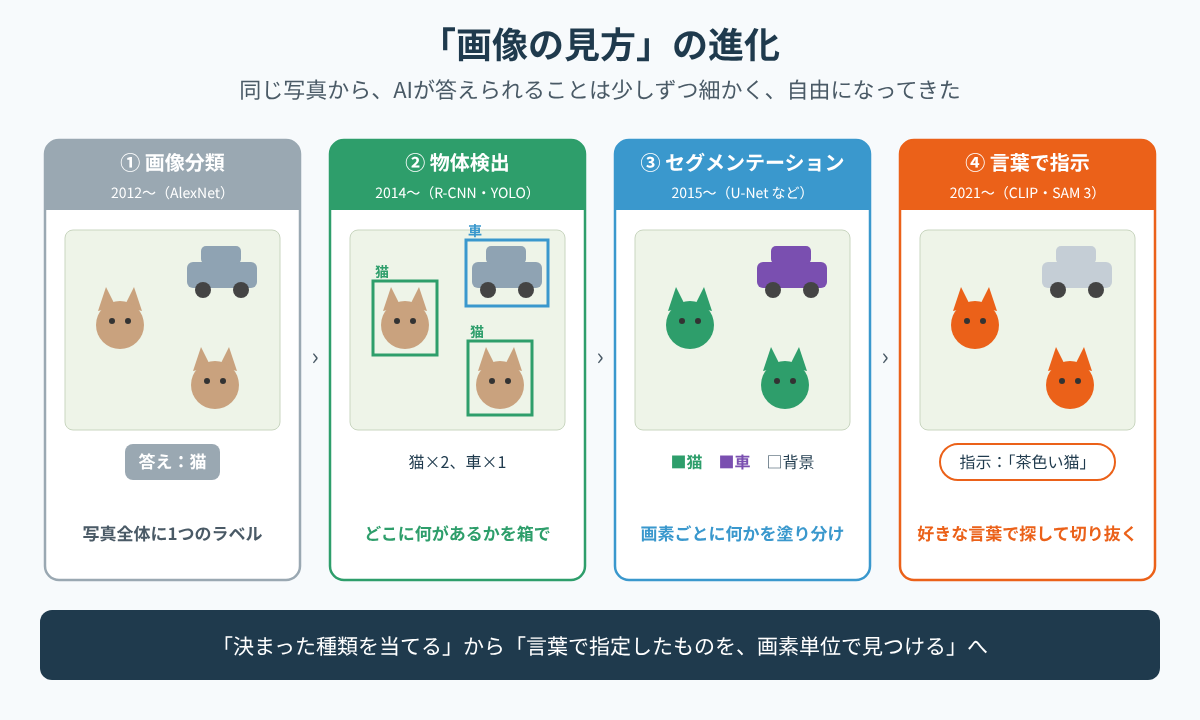
ここまでの物語は、写真全体に1つのラベルを付ける画像分類の話でした。しかし、自動運転や医療画像の診断では、「どこに」「何が」あるかまで知る必要があります。
物体検出:R-CNN から YOLO へ
物体の位置を四角い枠で囲み、その種類を答えるタスクを、物体検出と呼びます。
2014年の R-CNN は、画像の中から物体がありそうな領域の候補を約2000個取り出し、それぞれを CNN で分類する方法で、検出の精度を大きく高めました。しかし、候補ごとに CNN の計算を繰り返すため、1枚の画像の処理に数十秒かかるという問題がありました。
2015年の Fast R-CNN と Faster R-CNN は、CNN の計算を画像全体で1回にまとめ、候補の領域もネットワーク自身が提案するようにして、大幅に高速化しました。同じ年に発表された YOLO(You Only Look Once)は、さらに発想を変え、画像を1回見るだけで、すべての物体の位置と種類を同時に予測します。YOLO は、動画をリアルタイムに処理できる速さを実現しました。
検出の正しさは、予測した枠と正解の枠の重なり具合で測ります。この指標を IoU(Intersection over Union)と呼びます。

A は予測した枠、B は正解の枠で、分子は2つの枠が重なった部分の面積、分母は2つの枠を合わせた全体の面積です。数値で確認します。どちらの枠も面積が 10000 で、重なった部分の面積が 5000 のとき、全体の面積は 10000 + 10000 - 5000 = 15000 なので、IoU は 5000 ÷ 15000 ≒ 0.33 です。完全に一致すれば 1、まったく重ならなければ 0 になります。
セグメンテーション:画素ごとに塗り分ける
四角い枠よりも細かく、画素の1つ1つが何に属するかを判定するタスクを、セグメンテーション(領域分割)と呼びます。
2015年に発表された FCN は、CNN の出力を画像と同じ大きさの「塗り分け図」にする方法を示しました。同じ年の U-Net は、画像を縮めながら特徴を取り出す前半と、元の大きさに戻す後半を、スキップ接続でつないだ構造で、少ないデータでも細かい輪郭を捉えられることを示し、医療画像の分野で広く使われるようになりました。U-Net は後に、画像生成の拡散モデルの中でも使われます。2017年の Mask R-CNN は、検出とセグメンテーションを組み合わせ、物体を1つずつ区別して塗り分けられるようにしました。
残された問題
検出やセグメンテーションのモデルを学習させるには、枠や塗り分けの正解を人間が作る必要があります。特に、画素単位の塗り分けの作成には、1枚の画像に何分もかかります。また、学習したモデルは、あらかじめ決めた種類の物体しか見つけられませんでした。
ここで確認
問い:R-CNN と YOLO の最も大きな違いは何でしょうか。
答え:R-CNN は物体の候補の領域ごとに CNN の計算を繰り返すため遅く、YOLO は画像を1回見るだけですべての物体の位置と種類を同時に予測するため、リアルタイムに処理できる速さを実現しました。
第6章 Transformer がやってくる:ViT(2020〜2022)
画像を「単語の列」として扱う
2017年に言葉の世界で生まれた Transformer は、2020年、画像の世界にもやってきました。Google の研究者たちが発表した ViT(Vision Transformer)です。論文の題名は「1枚の画像は 16×16 個の単語に値する」でした。
ViT は、画像を小さな正方形(パッチ)に切り分け、それぞれを単語のように並べて、Transformer で処理します。例えば、縦横 224 画素の画像を 16 画素四方のパッチに分けると、14 × 14 = 196 個のパッチの列になります。
CNN との違い
CNN は、小さなフィルターで近くの画素から順に情報をまとめていくため、画像の離れた場所どうしの関係を捉えるには、多くの層を重ねる必要があります。ViT は、自己注意によって、最初の層からすべてのパッチどうしの関係を直接計算できます。
一方で、CNN には「近くの画素は関係が深い」「模様は画像のどこにあっても同じように扱う」という、画像に適した前提があらかじめ組み込まれています。ViT にはこの前提がないため、少ないデータでは CNN に及ばず、数億枚規模の大量のラベル付き画像で学習して初めて、CNN を上回りました。
歩み寄る2つの流れ
この問題に対して、学習の工夫によって ImageNet の規模でも ViT を学習できるようにした DeiT(2020年末)や、CNN のように段階的に画像を縮めていく構造を取り入れた Swin Transformer(2021年)が登場しました。反対に、2022年の ConvNeXt は、Transformer の設計の工夫を CNN に取り入れ、CNN でも同等の精度を出せることを示しています。CNN と Transformer は、互いの長所を取り入れながら発展しています。
ここで確認
問い:ViT は、CNN と比べてどのような長所と短所があったのでしょうか。
答え:長所は、自己注意によって画像の離れた場所どうしの関係を最初から直接捉えられることです。短所は、画像に適した前提が組み込まれていないため、大量の学習データが必要になることです。
第7章 ラベルなしで学び、言葉とつながる(2020〜2023)
自己教師あり学習:ラベルを使わない
ViT が必要とする大量のラベル付き画像を、人間が用意し続けるのは困難です。この問題を解決したのが、ラベルなしの画像から学ぶ自己教師あり学習です。自然言語処理で、BERT や GPT がラベルなしの文章から学んだのと同じ考え方です。
代表的な方法は2つあります。
- 対照学習:1枚の画像を切り抜いたり色を変えたりして2通りに加工し、「元が同じ画像どうしは近く、別の画像とは遠く」なるように学習する。2020年の SimCLR や MoCo が代表例
- マスク画像モデリング:画像の一部を隠し、隠された部分を復元するように学習する。2021年の MAE は、画像の約4分の3を隠しても学習できることを示した
2021年に発表された DINO と、その後継の DINOv2(2023年)は、ラベルを一切使わずに学習したモデルが、分類、セグメンテーション、奥行きの推定など、さまざまなタスクの土台として使えることを示しました。
CLIP:画像と言葉を結び付ける
もう1つの大きな問題は、モデルが「あらかじめ決めた種類」しか答えられないことでした。1000種類を学習したモデルは、1001番目の種類を答えられません。
2021年1月、OpenAI は CLIP を発表しました。CLIP は、インターネット上から集めた4億組の画像と説明文を使い、「正しい組み合わせの画像と文章は近く、間違った組み合わせは遠く」なるように学習します。画像と言葉を、同じ空間のベクトルとして比べられるようにしたのです。
その結果、「犬の写真」「猫の写真」「自動車の写真」のような文章を用意して、画像に最も近い文章を選ぶだけで、その種類を一度も個別に学習していなくても分類できるようになりました。このような能力を、ゼロショット分類と呼びます。CLIP は、言葉から画像を作る画像生成 AI の土台にもなりました。
SAM:何でも切り抜く
2023年4月、Meta は SAM(Segment Anything Model)を発表しました。SAM は、1100万枚の画像と11億個以上の領域のデータで学習され、画像の上の点や枠を指定するだけで、学習時に見たことのない物体でも切り抜くことができます。2024年の SAM 2 では、動画の中の物体を追い続けることもできるようになりました。
自然言語処理で、1つの大きな事前学習モデルがさまざまなタスクの土台になったのと同じように、コンピュータビジョンでも、DINO、CLIP、SAM のような基盤モデルを土台として使う時代になりました。
ここで確認
問い:CLIP は、それまでの画像分類モデルのどのような制約を取り払ったのでしょうか。
答え:あらかじめ決めた種類しか答えられないという制約です。画像と言葉を同じ空間で比べられるようにしたことで、種類を文章で指定するだけで、個別に学習していない種類でも分類できるようになりました。
第8章 見て話す AI と、3次元の世界(2023〜2025)
画像を読む言語モデル
2023年、言語モデルが画像を理解できるようになりました。CLIP のような画像の読み取り役(画像エンコーダ)と、大規模言語モデルをつなぐことで、写真について質問に答えたり、図やグラフを読み取ったり、手書きのメモを文章にしたりできます。同じ年に公開された GPT-4 の画像入力機能や、研究用に公開された LLaVA などが代表例です。このようなモデルは、視覚言語モデル(VLM)と呼ばれます。
それまでは、分類、検出、文字の読み取りなど、目的ごとに別々のモデルを用意していました。VLM では、言葉で質問するだけで、1つのモデルがさまざまな課題に答えます。
写真から3次元を作る
写真は、3次元の世界を2次元に写したものです。複数の写真から、元の3次元の形を復元する研究も大きく進みました。
2020年に発表された NeRF は、さまざまな角度から撮った写真をもとに、3次元の空間をニューラルネットワークで表し、撮影していない角度からの見え方を高い品質で作り出しました。ただし、学習と描画に時間がかかる問題がありました。2023年に発表された 3D Gaussian Splatting は、空間を多数のぼんやりした粒の集まりで表すことで、高い品質のまま、リアルタイムに描画できるようにしました。
基盤モデルの進化
基盤モデルも進化を続けています。2025年8月、Meta は DINOv3 を発表しました。約17億枚のラベルなし画像と、70億パラメータという大きなモデルで自己教師あり学習を行い、言葉の説明を手がかりに学習するモデルを、幅広いタスクで初めて上回ったと報告しています。
2025年11月に発表された SAM 3 は、「黄色いスクールバス」のような短い言葉や、見本の画像を指定するだけで、画像や動画の中から該当するものをすべて見つけ、切り抜き、追跡できるようになりました。点や枠で1つずつ指定していた SAM から、言葉で概念を指定する方法へと進んだことになります。第7章の「言葉とつながる」流れと「何でも切り抜く」流れが、ここで合流しました。
ここで確認
問い:視覚言語モデル(VLM)の登場で、画像認識の使い方はどのように変わったのでしょうか。
答え:分類、検出、文字の読み取りなど、目的ごとに別々のモデルを用意する必要があった状態から、1つのモデルに言葉で質問するだけで、さまざまな課題に答えられるようになりました。
第9章 見るだけから、行動へ(2025〜)
ロボットの目と手をつなぐ
2025年から2026年にかけて、コンピュータビジョンの舞台は、画面の中から現実の世界へと広がっています。その中心にあるのが、VLA(Vision-Language-Action:視覚・言語・行動)モデルです。VLA モデルは、カメラの映像と言葉による指示を受け取り、ロボットの腕や体をどう動かすかを直接出力します。「見て、考えて、動く」を1つのモデルで行う考え方です。
残された問題:空間が分からない
ここで、新しい問題が明らかになっています。現在の視覚言語モデルの多くは、平面の画像と言葉の組み合わせから学んでいるため、「どちらが手前にあるか」「どのくらい離れているか」といった、3次元の空間の理解が十分ではないのです。現実の世界で物をつかんだり、部屋の中を移動したりするには、奥行きや位置関係の正確な理解が欠かせません。
この問題に対して、第8章で紹介した3次元の復元技術を視覚言語モデルに組み込む研究や、奥行きの情報を追加して学習させる研究が盛んに行われています。
世界モデルとの合流
もう1つの流れが、世界モデルです。生成モデルの歴史の記事で紹介したように、行動に応じて変化する仮想の世界を、リアルタイムに生成するモデルが登場しています。ロボットや AI エージェントは、現実で失敗を繰り返す代わりに、生成された世界の中で安全に試行錯誤できます。見る技術(コンピュータビジョン)、作る技術(生成モデル)、行動を学ぶ技術(強化学習)が、ここで1つに合流しようとしています。
社会的な課題
技術が広く使われるようになったことで、社会的な課題も大きくなっています。
- プライバシー:顔認識や監視カメラの映像の扱い
- 公平性:学習データの偏りによって、特定の人々に対する精度が低くなる問題
- 安全性:自動運転やロボットが、まれな状況で誤った判断をする危険
- 偽の映像:本物と見分けがつかない画像や動画への対策
ここで確認
問い:ロボットに視覚言語モデルを使うとき、現在どのような点が課題になっているのでしょうか。
答え:平面の画像と言葉から学んだモデルは、奥行きや位置関係といった3次元の空間の理解が十分ではないことです。現実の世界で行動するには、空間の正確な理解が必要になります。
終章 物語を貫くパターン
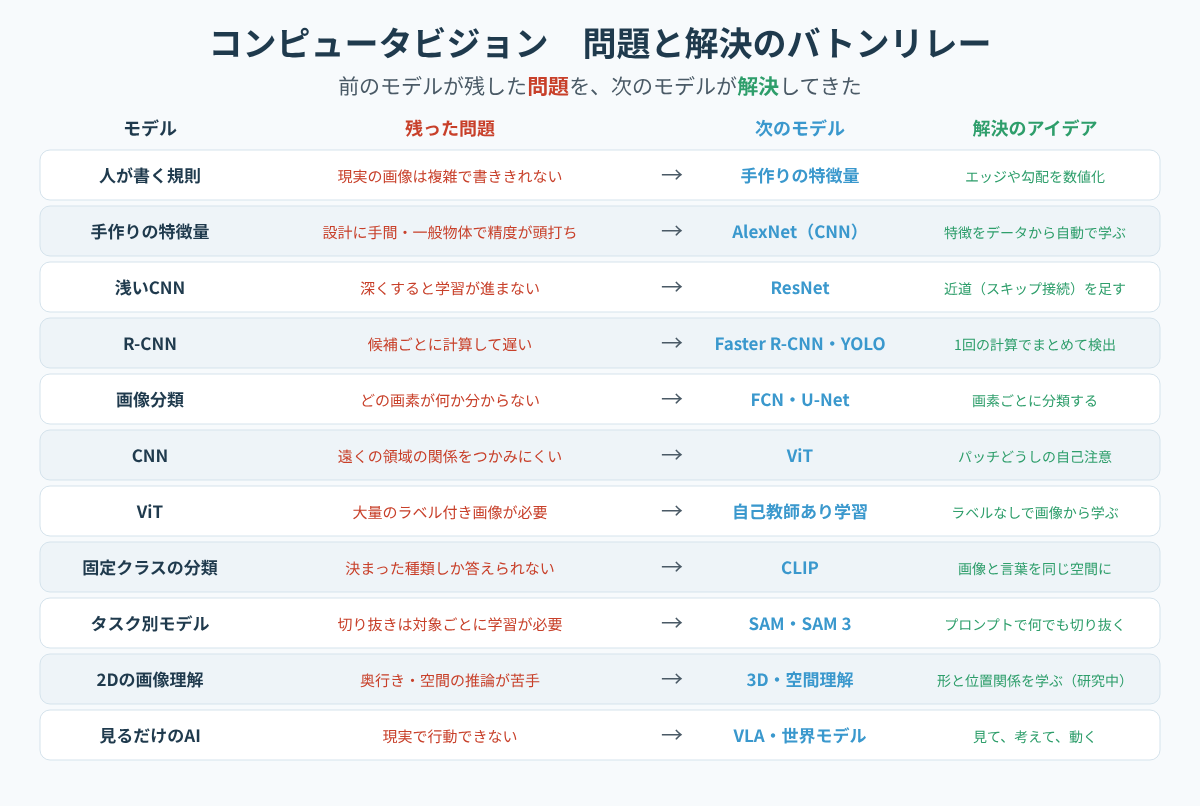
60年以上にわたるコンピュータビジョンの歴史を振り返ると、いくつかのパターンが見えてきます。
人が作る部分が減っていった
1つ目のパターンは、人間が手で作る部分が、時代とともに減っていったことです。
- 規則の時代:人が、形を判断する規則を書いた
- 特徴量の時代:人が、画像のどこに注目するか(特徴量)を設計した
- CNN の時代:特徴量はデータから学び、人はラベルを付けた
- 自己教師あり学習の時代:ラベルも不要になり、画像そのものから学ぶようになった
- 基盤モデルの時代:言葉で指示するだけで、新しい課題に対応できるようになった
自然言語処理の歴史で見たパターンと、同じ流れをたどっていることが分かります。
答えられることが細かく、自由になった
2つ目のパターンは、AI が答えられる内容の変化です。写真全体に1つのラベルを付ける分類から、位置を示す検出、画素ごとに塗り分けるセグメンテーションへと細かくなり、さらに、言葉で自由に指定したものを見つけられるようになりました。第5章の図は、この流れをまとめたものです。
他の分野と合流していく
3つ目のパターンは、分野の境界がなくなってきたことです。言葉のために生まれた Transformer が画像に使われ、画像と言葉が CLIP で結び付き、言語モデルが画像を読み、ロボットの行動までつながりました。
研修では、新しいモデルを紹介するときに「このモデルは、どの問題を解決するために生まれたのか」「人が用意するものは何が減ったのか」の2つを問いかけてみてください。受講者は、モデルの名前を暗記するのではなく、技術どうしのつながりとして理解できるようになります。
確認問題
コンピュータビジョンの歴史について、正しい説明を1つ選んでください。
- AlexNet は、人が設計した特徴量を SVM で分類する方法で優勝した
- YOLO は、物体の候補の領域ごとに CNN の計算を繰り返す方法である
- ResNet は、入力を出力に足す近道によって深い層の学習を可能にした
- CLIP は、あらかじめ決めた1000種類だけを分類するためのモデルである
解答と解説
正解は 3 です。
- 1 は誤りです。AlexNet は、特徴量をデータから自動で学ぶ深い CNN です。人が設計した特徴量と SVM の組み合わせは、それ以前の主流の方法です
- 2 は誤りです。候補の領域ごとに計算を繰り返すのは R-CNN です。YOLO は、画像を1回見るだけですべての物体を同時に予測します
- 3 は正しい説明です。スキップ接続によって、層は入力との差だけを学べばよくなり、100層を超える深いネットワークを学習できるようになりました
- 4 は誤りです。CLIP は画像と言葉を同じ空間で比べるため、種類を文章で指定すれば、個別に学習していない種類も分類できます
研修で使うときの進め方
講師向けに、この物語を研修で使う進め方の一例を示します。
- 写真を数値の表として見せ、「この数字の並びのどこが猫ですか」と問いかけて、問題の難しさを体験してもらう
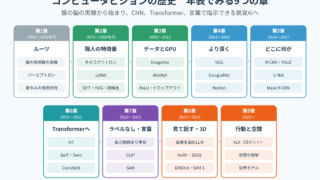
- 年表の図を示し、9つの章の全体像を先に見せる
- 各章を「主人公(モデル)」「立ちはだかった壁(問題)」「次の主人公への引き継ぎ(解決)」の3点で説明する
- 畳み込みの数値例を、受講者に手で計算してもらう
- 画像の見方の図を使い、分類・検出・セグメンテーション・言葉による指示の違いを整理する
- 各章の「ここで確認」の問いを、個人またはペアで答えてもらう
- 問題と解決のバトンリレーの図で、章どうしのつながりを振り返る
- グループワークとして、「自分たちの業務で画像認識を使うなら、分類・検出・セグメンテーションのどれが必要か」を話し合ってもらう
Python の演習と組み合わせる場合は、縁を検出するフィルターの畳み込み、学習済みの CNN による画像分類、物体検出、言葉を使ったゼロショット分類の順に体験させると、歴史の流れを手を動かして確かめられます。人物が写った画像を扱う場合は、肖像権やプライバシーへの配慮についても、あわせて伝えるようにしてください。
まとめ
- コンピュータビジョンは、猫の視覚野の実験で分かった「単純な特徴を段階的に組み合わせる」仕組みを手がかりに発展した
- 手作りの特徴量の時代を経て、2012年の AlexNet が、データと GPU の力で深層学習の時代を開いた
- ResNet はスキップ接続で深いネットワークの学習を可能にし、YOLO や U-Net は「どこに何があるか」を答えられるようにした
- ViT は Transformer を画像に持ち込み、自己教師あり学習はラベルなしで学べるようにした
- CLIP は画像と言葉を結び付け、SAM は何でも切り抜けるようにし、基盤モデルの時代が始まった
- 現在は、画像を読む言語モデル、3次元の復元、ロボットの行動へと広がり、空間の理解が大きな課題になっている
次の学習ステップとしては、小さな画像に対する畳み込みとプーリングの計算を、手で一通り行ってみる流れをおすすめします。行列の積や内積の考え方がそのまま使えるため、線形代数の学習ともつながり、CNN の中で何が起きているかを具体的に理解できます。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 山崎講師2026年11月15日機械学習の歴史を物語で学ぶ|最小二乗法からパーセプトロン、決定木、SVM、ランダムフォレスト、勾配ブースティング、表形式基盤モデルまで
 山崎講師2026年11月15日オプティマイザの歴史を物語で学ぶ|勾配降下法からモーメンタム、AdaGrad、RMSProp、Adam、AdamW、Muonまで
 山崎講師2026年11月15日ディープラーニングの歴史を物語で学ぶ|パーセプトロンから誤差逆伝播法、2度の冬、AlexNet、Transformer、基盤モデルまで
 山崎講師2026年11月15日コンピュータビジョンの歴史を物語で学ぶ|猫の脳の実験からAlexNet、ResNet、YOLO、ViT、CLIP、SAM、ロボットの目まで