ソフトマックス関数の公式と覚え方:多クラス分類における確率変換の仕組みを解説
 山崎講師
こんにちは。ゆうせいです。
画像に写っている動物が犬、猫、鳥のどれであるかを判別するような、3つ以上の選択肢から正解を選ぶ問題を多クラス分類と呼びます。機械学習や深層学習の出力層において、モデルが算出した各分類の数値を確率へと変換する計算処理がソフトマックス関数です。今回は、基礎知識を持たない方に向けて、ソフトマックス関数の役割、公式の覚え方、そして長所と短所を順序立てて解説します。
ソフトマックス関数とは何か
ソフトマックス関数は、複数の実数値を受け取り、それぞれの値が起きる確率を0から1の範囲で算出し、全体の合計が1になるように変換する関数です。
高校の文化祭で行われる模擬店の人気投票を例に考えてみます。焼きそば店、たこ焼き店、クレープ店の3店舗があり、審査員がそれぞれの店にプラスの点数やマイナスの点数を付けたとします。この段階の素点はマイナス5点や30点といった不揃いな数値であり、そのままでは「どの店が何パーセントの確率で選ばれるか」という割合を直接把握することができません。
そこで、各店舗の数値をすべて正の数へと引き伸ばした上で、全員の点数を足し合わせた全体量で個別の点数を割ります。これにより、全店舗の割合を足すとちょうど100パーセント(数値として1)になり、各店舗の支持率を確率として比較できるようになります。この計算を行う仕組みがソフトマックス関数です。
ソフトマックス関数の公式と覚え方
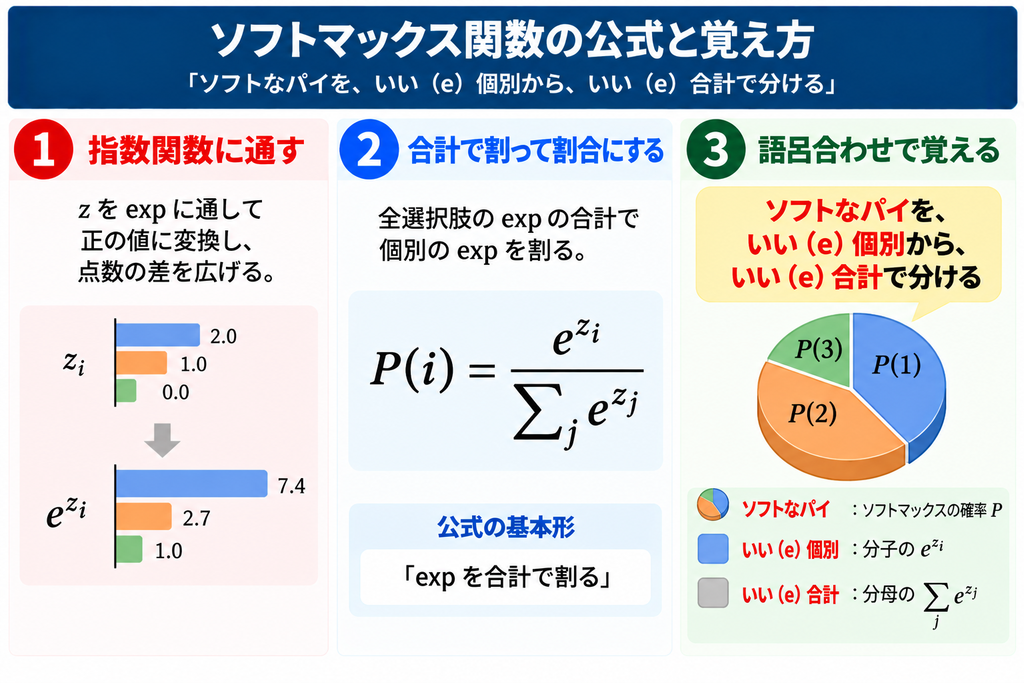
分類したい選択肢の総数を K 個とします。入力された各選択肢の数値を z_1, z_2, ..., z_K と置いたとき、特定の選択肢 i に対応する出力確率 P_i を求めるソフトマックス関数の公式は次の通りです。

ここで、e は自然対数の底(約2.718)であり、指数関数を表します。分子は注目している選択肢の数値を指数関数に通した値であり、分母はすべての選択肢の数値を指数関数に通して足し合わせた総和です。
覚え方の手順と語呂合わせ
公式の構造を記憶する際は、次の2つの段階を把握します。
- 指数関数に通す:元の数値 z を指数関数 exp(eの累乗)に代入して正の値に変換し、点数の差を広げます。
- 総和で割って割合にする:全選択肢の exp を合計した分母で、個別の exp である分子を割ります。
公式の基本形は「exp を合計で割る」という1文で捉えられます。
暗記を補助する語呂合わせとして、「ソフトなパイを、いい(e)個別から、いい(e)合計で分ける」という対応関係で連想します。
- ソフトなパイ:ソフトマックス関数の確率 P
- いい(e)個別:分子にある特定の e^{z_i}
- いい(e)合計:分母にある全体の総和 \sum e^{z_j}
この語呂合わせによって、分子に個別の指数関数が入り、分母にすべての選択肢の指数関数の合計が入るという分数の上下関係を混同せずに思い出せます。
ソフトマックス関数のメリットとデメリット
ソフトマックス関数には、分類モデルを構築する上で明確な性質があります。
メリット
- 出力を確率分布として解釈できる:すべての出力値が0より大きく1未満の範囲に収まり、総和が厳密に1となるため、モデルの予測結果をそのまま確率として提示できます。
- 微分が容易で学習に適している:滑らかな連続関数であり、損失関数である多クラス交差エントロピー誤差と組み合わせた際に逆伝播の計算が簡潔な差分のみに整理されます。
- 小さな差を明確に際立たせる:指数関数を用いる性質上、元の数値にわずかな差がある場合でも、大きい値がより強調されて明確な順位付けが行われます。
デメリット
- 極端な値による数値のオーバーフローが生じる:入力値 z の数値が大きすぎると、指数計算の結果が計算機の扱える上限を超えて無限大(inf)となり、計算エラーを引き起こすため、最大値を事前に差し引く補正処理が必要になります。
- 外れ値に過剰に反応する:突出して大きな入力値が存在すると、1つの選択肢のみが確率1に偏り、他の選択肢が限りなく0に押し込められるため、確信度の歪みを生む要因となります。
まとめ
ソフトマックス関数は、複数の分類候補に対する素点を指数関数によって正の数に広げ、全体総和で割ることで総和が1となる確率分布へ変換する関数です。「exp を合計で割る」という構造を基本とし、「ソフトなパイを、いい個別から、いい合計で分ける」という語呂合わせを併用することで、公式の分子と分母の配置を迷わず導き出せます。
ソフトマックス関数の役割を整理した次の学習段階として、予測された確率と正解ラベルのズレを測る「多クラス交差エントロピー誤差」の定義と計算手順を確認してみてください。続いて、深層学習における出力層の活性化関数と誤差逆伝播法との関係性を学ぶことで、ニューラルネットワークを用いた分類アルゴリズムの全体像を体系的に理解できます。
投稿者プロフィール