生成モデルの歴史を物語で学ぶ|シャノンの文章生成からVAE、GAN、拡散モデル、ChatGPT、世界モデルまで
 山崎講師
こんにちは。ゆうせいです。
生成AIの研修では、VAE、GAN、拡散モデル、Transformer、GPT といった名前が次々に登場します。受講者から「結局どれが新しくて、どれが古いのか」「なぜこんなに多くの種類があるのか」と質問されることも多いのではないでしょうか。
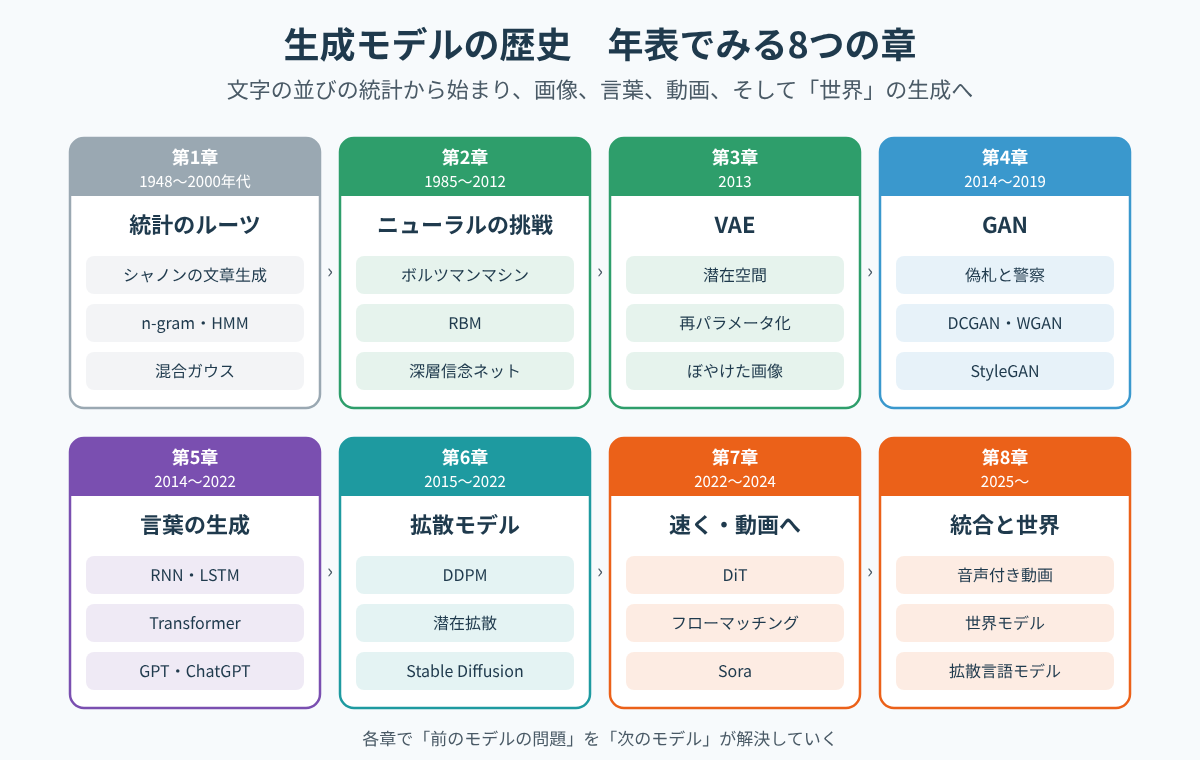
生成モデルの歴史も、強化学習と同じように「前のモデルが抱えていた問題を、次のモデルが解決する」という流れで並べると、1本の物語として理解できます。今回は、生成モデルの歴史を、その始まりから2026年の最新の動向まで、物語の形でたどります。各章の終わりには、受講者の理解を確かめる問いを用意しました。G検定・E資格の学習や、生成AI研修の導入に活用してください。
序章 生成モデルとは何か
物語を始める前に、生成モデルとは何かを確認します。
機械学習のモデルは、大きく2つの役割に分けられます。
- 識別モデル:データを見て、それが何かを判定するモデル。例:写真を見て「猫」か「犬」かを答える
- 生成モデル:データの特徴(どのようなデータが、どのくらいの確率で現れるか)を学び、それに似た新しいデータを作るモデル。例:猫の写真をたくさん学び、存在しない猫の写真を作る
料理にたとえると、識別モデルは「この料理はカレーだ」と言い当てる人、生成モデルは「カレーとはこういうものだ」と理解して、新しいカレーを作れる人です。生成モデルは、データの「答え」ではなく、データがどのように生まれるかという「分布」そのものを学ぶ点が特徴です。
第1章 統計のルーツ(1948〜2000年代)
シャノンの文章生成
生成モデルの物語は、1948年、情報理論の父と呼ばれるクロード・シャノンの論文から始まります。シャノンは、英語の文章に現れる文字や単語の並び方の統計を使い、それらしい文章を機械的に作れることを示しました。
例えば、「直前の1単語が何だったか」によって次の単語の確率を決め、その確率に従ってサイコロを振るように単語を選んでいくと、意味は通らないものの、英語らしい単語の並びができあがります。
n-gram と統計モデル
この考え方は、直前の n - 1 個の単語から次の単語を予測する n-gram モデルとして発展し、音声認識や機械翻訳で長く使われました。同じ時期には、音声などの時系列データを扱う隠れマルコフモデル(HMM)や、データの分布を複数の山(正規分布)の重ね合わせで表す混合ガウスモデルも使われています。
文章の確率を、単語の条件付き確率の積に分けて考える方法は、次の式で表せます。

各記号の意味は次のとおりです。
- w_i:文章の i 番目の単語
- P(w_i | w_1, …, w_{i-1}):それまでの単語が与えられたときに、i 番目の単語が現れる確率
- Π(パイ):すべてを掛け合わせる記号
例えば、「私 は 猫 が 好き」という文章の確率は、「私」が最初に来る確率 × 「私」の次に「は」が来る確率 × …… と、5つの確率の掛け算で表せます。この「次の単語を予測し続ける」考え方は、約70年後の GPT にそのまま受け継がれます。
残された問題
n-gram は、直前の数語しか見ないため、文章全体の流れや遠く離れた単語との関係を捉えられませんでした。見る範囲を広げると、組み合わせの数が爆発的に増え、データが足りなくなります。また、統計モデルで表せるのは比較的単純な分布に限られ、画像のような複雑なデータを生成することはできませんでした。
ここで確認
問い:n-gram モデルが抱えていた大きな問題は何でしょうか。
答え:直前の数語しか見ないため、文章全体の流れや離れた単語との関係を捉えられないことです。見る範囲を広げると組み合わせが爆発し、データが不足します。
第2章 ニューラルネットの挑戦(1985〜2012)
ボルツマンマシン
複雑なデータの分布を表すために、ニューラルネットワークを使う試みが始まりました。1985年、ジェフリー・ヒントンらは、物理学の考え方を取り入れたボルツマンマシンを発表しました。ボルツマンマシンは、ネットワーク全体の「エネルギー」が低い状態ほど現れやすいという仕組みで、データの分布を表します。
その後、構造を単純にした制限付きボルツマンマシン(RBM)が登場し、2006年にはヒントンらが RBM を積み重ねた深層信念ネットワーク(DBN)を発表しました。DBN は、深いニューラルネットワークをうまく学習させる方法として注目され、現在の深層学習ブームのきっかけの1つになりました。
残された問題
ボルツマンマシンの系統には、学習と生成に時間がかかるという問題がありました。新しいデータを1つ作るにも、ネットワークの状態を少しずつ何度も更新する必要があり(マルコフ連鎖モンテカルロ法)、高解像度の画像のような大きなデータを扱うのは困難でした。
ここで確認
問い:ボルツマンマシンの系統のモデルは、どのような点で実用が難しかったのでしょうか。
答え:学習やデータの生成に、状態を少しずつ何度も更新する手順が必要で、時間がかかったことです。大きな画像を扱うのが困難でした。
第3章 VAE:潜在空間の発見(2013)
圧縮して、広げる
2013年、ディーデリク・キングマとマックス・ウェリングは、変分オートエンコーダ(VAE:Variational Autoencoder)を発表しました。VAE は、2つのネットワークを組み合わせます。
- エンコーダ:画像などのデータを、少ない数の値(潜在変数)に圧縮する
- デコーダ:潜在変数から、元のデータを復元する
VAE の特徴は、潜在変数を「1つの点」ではなく「確率の分布(平均とばらつき)」として表すことです。学習が終わると、潜在空間(潜在変数が並ぶ空間)のどこかの点を選んでデコーダに通すだけで、新しいデータを作れます。
似顔絵にたとえると、エンコーダは「目の大きさ、輪郭、髪型」など少数の特徴を読み取る係、デコーダは特徴から似顔絵を描く係です。特徴の値を少しずつ変えれば、存在しない人の似顔絵を描けます。
再パラメータ化トリック
VAE が画期的だったのは、確率的にサンプルを選ぶ部分を含みながら、誤差逆伝播法(ニューラルネットワークの標準的な学習方法)でまとめて学習できるようにした点です。この工夫は再パラメータ化トリックと呼ばれます。ランダムな値を外から加える形に書き換えることで、勾配(どの方向に重みを直せばよいか)を計算できるようにしました。
第2章の「何度も状態を更新しないと生成できない」問題を、VAE は「デコーダに1回通すだけで生成できる」形で解決しました。
残された問題
VAE で生成した画像は、全体的にぼやけてしまう傾向がありました。複数の可能性の「平均」に近い画像を出力しやすく、髪の毛の1本1本のような細かい部分を、くっきりと描くことが苦手でした。
ここで確認
問い:VAE は、ボルツマンマシンの系統と比べて、生成の手順をどのように簡単にしたのでしょうか。また、どのような問題が残ったのでしょうか。
答え:潜在空間の点を選んでデコーダに1回通すだけで、新しいデータを生成できるようにしました。一方で、生成した画像がぼやけやすいという問題が残りました。
第4章 GAN:偽札作りと警察の対決(2014〜2019)
2つのネットワークを競わせる
2014年、イアン・グッドフェローらは、敵対的生成ネットワーク(GAN:Generative Adversarial Network)を発表しました。GAN も2つのネットワークを使いますが、その関係は VAE とまったく異なります。
- 生成器(Generator):ランダムなノイズから、本物そっくりの偽物を作る
- 識別器(Discriminator):渡されたデータが本物か、生成器が作った偽物かを見分ける
GAN は、偽札作りと警察の関係によくたとえられます。偽札作り(生成器)は警察にばれないように偽札の精度を上げ、警察(識別器)は偽札を見破る力を高めます。この競争を繰り返すうちに、生成器は本物と見分けがつかないデータを作れるようになります。
GAN の目的関数
GAN の学習は、次の式で表されます。

各記号の意味は次のとおりです。
- G:生成器、D:識別器
- x:本物のデータ、z:生成器に入力するランダムなノイズ
- D(x):識別器が x を本物だと判断する確率(0 から 1)
- G(z):生成器が作った偽物
- E:期待値(多くのデータでの平均)
識別器 D は、本物には D(x) を 1 に近づけ、偽物には D(G(z)) を 0 に近づけて、式全体を大きくしようとします(max)。生成器 G は、偽物を本物だと思わせて D(G(z)) を 1 に近づけ、式全体を小さくしようとします(min)。
数値で確認します。識別器が本物に D(x) = 0.9、偽物に D(G(z)) = 0.2 を出力したとすると、式の値は log 0.9 + log 0.8 ≒ -0.11 - 0.22 = -0.33 です。識別器が見分けるのが上手になるほど値は 0 に近づき、生成器が上手にだますほど値は小さくなります。
くっきりした画像と、高まる完成度
GAN が生成する画像は、VAE と比べてくっきりしていました。識別器が「ぼやけた画像は偽物だ」と見抜くため、生成器はぼやけた画像では勝てないからです。第3章の「ぼやける」問題を、GAN は対決の仕組みで解決しました。
その後、畳み込みニューラルネットワークを使った DCGAN(2015年)、学習を安定させる工夫を加えた WGAN(2017年)などの改良が続き、2018年に NVIDIA が発表した StyleGAN は、実在しない人物の顔写真を、本物と見分けがつかないほどの品質で生成しました。
残された問題
GAN には、大きく2つの問題がありました。
1つ目は、学習が不安定なことです。生成器と識別器の力のバランスが崩れると、学習がうまく進まなくなります。
2つ目は、モード崩壊と呼ばれる問題です。生成器が、識別器をだましやすい一部の種類のデータばかりを作るようになり、生成されるデータの多様性が失われます。例えば、数字の画像を学習させたのに「1」ばかり生成する、といった状態です。
また、本物そっくりの顔や映像を作れることから、ディープフェイクと呼ばれる偽の映像の悪用も社会的な課題になりました。
ここで確認
問い:GAN は、VAE の「画像がぼやける」問題をどのような仕組みで解決したのでしょうか。
答え:本物と偽物を見分ける識別器と競わせる仕組みです。ぼやけた画像は識別器に偽物だと見抜かれるため、生成器はくっきりした画像を作るように学習します。
第5章 言葉の生成:RNN から Transformer、GPT へ(2014〜2022)
RNN と LSTM:文脈を覚える
画像の生成と並行して、言葉の生成も進化しました。ニューラルネットワークで文章を扱うために、前の単語の情報を内部に保持しながら1単語ずつ処理する RNN(再帰型ニューラルネットワーク)や、長い文脈を覚えやすくした LSTM が使われました。2014年には、文章を読み込んで別の文章を出力する seq2seq(系列変換モデル)が登場し、機械翻訳の品質が大きく向上しました。同じ年には、入力のどの部分に注目すべきかを学ぶアテンション(注意機構)も提案されています。
第1章の n-gram が「直前の数語しか見ない」問題を、ニューラルネットワークは単語を数値のベクトル(分散表現)で表し、より広い文脈を扱うことで乗り越えようとしました。
Transformer:並列に、遠くまで
RNN にも問題がありました。単語を1つずつ順番に処理するため、計算を並列化できず、大量のデータで学習するのに時間がかかりました。また、文章が長くなると、最初のほうの情報が薄れてしまいます。
2017年、Google の研究者たちは論文「Attention Is All You Need」で Transformer を発表しました。Transformer は、RNN のような順番どおりの処理をやめ、アテンションの仕組みだけで、文中のすべての単語どうしの関係を一度に計算します。これにより、計算を並列化でき、離れた単語の関係も直接捉えられるようになりました。
GPT:次の単語を予測し続ける
2018年、OpenAI は Transformer を使った GPT を発表しました。GPT の学習は、第1章の式と同じく「それまでの単語から、次の単語を予測する」ことの繰り返しです。シャノンの時代の考え方が、70年の時を経て、巨大なニューラルネットワークで実現されたことになります。
GPT-2(2019年)、GPT-3(2020年)とモデルを大きくするにつれて、文章の質は大きく向上しました。2020年には、モデルの大きさ、データの量、計算量を増やすと、性能が予測可能な形で向上するという「スケーリング則」も報告されています。
残された問題と ChatGPT
GPT-3 は流暢な文章を書けましたが、人間の指示に素直に従うとは限らず、事実と異なる内容や不適切な内容を出力することもありました。「次の単語をうまく予測すること」と「人間にとって役に立つ回答をすること」は、同じではなかったのです。
この問題に対して、OpenAI は人間の評価を使った強化学習(RLHF)で言語モデルを調整し、2022年11月に ChatGPT を公開しました。RLHF の詳しい物語は、強化学習の歴史の記事で紹介しています。
ここで確認
問い:Transformer は、RNN のどのような問題を解決したのでしょうか。
答え:単語を1つずつ順番に処理するため並列化できず、長い文章で最初のほうの情報が薄れる問題です。Transformer はアテンションですべての単語の関係を一度に計算することで、並列化と離れた単語の関係の把握を両立しました。
第6章 拡散モデル:ノイズから生まれる画像(2015〜2022)
インクが水に広がる様子から
画像の生成に話を戻します。GAN の学習の不安定さとモード崩壊を解決したのが、拡散モデルです。
拡散モデルの考え方は、2015年にジャシャ・ソール=ディックスタインらが、物理学の拡散現象から着想を得て発表しました。水に垂らしたインクは、時間がたつと広がって均一になります。この「広がる」過程を逆にたどれれば、均一な状態からインクの形を復元できるはずだ、という発想です。
当初は大きな注目を集めませんでしたが、2020年にジョナサン・ホーらが発表した DDPM(Denoising Diffusion Probabilistic Models)が、GAN に匹敵する品質の画像を生成し、一気に主役に躍り出ました。
ノイズを加えて、取り除く
拡散モデルは、2つの過程で考えます。
- 拡散過程:本物の画像に少しずつノイズを加え、最終的に完全なノイズにする
- 逆拡散過程:完全なノイズから、少しずつノイズを取り除き、画像を復元する
ノイズを加える過程は、次の式で一度に計算できます。

各記号の意味は次のとおりです。
- x_0:元の画像(の1つの画素の値)
- x_t:t 回目のステップでノイズが加わった画像
- ε(イプシロン):ランダムなノイズ
- ᾱ_t(アルファバー):元の画像がどれだけ残っているかを表す値。t が大きいほど 0 に近づく
数値で確認します。元の画素の値が x_0 = 1.0、ノイズが ε = 0.5、ᾱ_t = 0.64 のとき、√0.64 = 0.8、√(1 - 0.64) = 0.6 なので、x_t = 0.8 × 1.0 + 0.6 × 0.5 = 1.1 です。
モデルが学ぶのは、「ノイズが加わった画像 x_t を見て、加えられたノイズ ε を当てる」ことです。ノイズを当てられれば、それを引くことで、少しずつ元の画像に近づけられます。
彫刻にたとえると分かりやすくなります。大理石の塊(ノイズ)から、少しずつ余分な部分(ノイズ)を削っていくと、最後に彫像(画像)が現れます。
なぜ GAN の問題を解決できたのか
拡散モデルは、「ノイズを当てる」という単純で安定した問題を学習するため、GAN のように2つのネットワークの力のバランスを取る必要がありません。また、データ全体の分布を少しずつ学ぶため、一部の種類だけを生成するモード崩壊が起こりにくく、多様な画像を生成できます。
残された問題と潜在拡散
拡散モデルにも大きな問題がありました。ノイズを取り除く手順を何百回、場合によっては1000回も繰り返すため、1枚の画像を作るのに時間がかかりました。さらに、高解像度の画像の画素を直接扱うと、計算量が膨大になります。
2020年の DDIM は、手順を飛ばして少ない回数で生成する方法を示しました。そして、2021年から2022年にかけて発表された潜在拡散モデル(Latent Diffusion Model)は、画像を VAE のエンコーダで小さな潜在空間に圧縮し、その中で拡散を行うことで、計算量を大幅に減らしました。第3章で「ぼやける」と言われた VAE が、ここでは拡散モデルを支える圧縮の役割として戻ってきます。
言葉で画像を作る
拡散モデルに「言葉による指示」を組み合わせたことで、画像生成は一気に身近になりました。2021年に OpenAI が発表した CLIP は、画像と文章を同じ空間で比較できるようにし、文章と画像を結び付ける土台になりました。2022年には、DALL·E 2、Imagen、Midjourney が相次いで登場し、同じ年の8月には、潜在拡散モデルを使った Stable Diffusion が誰でも使える形で公開されました。
ここで確認
問い:拡散モデルは、GAN のどのような問題を解決したのでしょうか。また、拡散モデルに残った問題は何でしょうか。
答え:学習の不安定さとモード崩壊を解決しました。ノイズを当てるという安定した問題を学ぶため、多様な画像を安定して生成できます。一方で、ノイズを取り除く手順を何百回も繰り返すため、生成に時間と計算量がかかる問題が残りました。
第7章 速く、大きく、動画へ(2022〜2024)
少ない手順で生成する
拡散モデルの「遅い」問題には、さまざまな解決策が提案されました。
2022年には、フローマッチングや整流フロー(Rectified Flow)と呼ばれる方法が発表されました。ノイズから画像までの道のりを、できるだけまっすぐな経路として学ぶことで、少ない手順で生成できるようにする考え方です。曲がりくねった山道ではなく、まっすぐなトンネルを掘るイメージです。2024年の Stable Diffusion 3 などで採用されています。
2023年には、ノイズから1回または数回の手順で画像を生成する一貫性モデル(Consistency Model)も発表されました。
Transformer と拡散の合流
2022年末に発表された DiT(Diffusion Transformer)は、拡散モデルの中で使うネットワークを、それまでの画像向けのネットワーク(U-Net)から Transformer に置き換えました。第5章で言葉の世界を変えた Transformer が、画像生成にも入ってきたのです。Transformer は大きくするほど性能が上がりやすいため、拡散モデルも大規模化しやすくなりました。
Sora:動画の生成
画像生成の次の壁は、動画でした。動画では、1枚1枚の絵がきれいなだけでなく、時間の流れの中で人や物の形が一貫している必要があります。
2024年2月、OpenAI は動画生成モデル Sora を発表しました。Sora は、動画を時間と空間の小さなブロック(パッチ)に分け、言語モデルが単語を扱うように並べて、DiT の仕組みで生成します。最大1分程度の、一貫性のある高品質な動画を生成できることを示し、大きな話題になりました。
同じ時期、言語モデルの側でも、文章だけでなく画像や音声を理解するマルチモーダル化が進みました。
ここで確認
問い:フローマッチングや整流フローは、拡散モデルのどのような問題を、どのような考え方で解決しようとしたのでしょうか。
答え:生成に多くの手順が必要で遅いという問題です。ノイズから画像までの経路をまっすぐに近づけることで、少ない手順で生成できるようにしました。
第8章 統合と「世界」の生成へ(2025〜)
言語モデルが絵を描き、動画に音が付く
2025年以降、別々に発展してきた生成モデルが、1つにまとまる動きが目立っています。
2025年3月、OpenAI は GPT-4o に画像生成の機能を組み込み、言語モデルが会話の流れを理解したうえで画像を作れるようにしました。動画の分野では、2025年に Google の Veo 3 や OpenAI の Sora 2 などが、映像と音声(台詞や効果音)を同時に生成できることを示しています。映像と音を別々に作って後で合わせるのではなく、1つのモデルでまとめて生成する方向に進んでいます。
世界モデル:見るだけでなく、操作できる
動画生成モデルにも、まだ大きな制約がありました。どれほどきれいな動画でも、視聴者は見るだけで、中の世界を操作することはできません。
2025年8月、Google DeepMind は Genie 3 を発表しました。Genie 3 は、文章による指示から、利用者がリアルタイムに歩き回ったり操作したりできる仮想の世界を生成する「世界モデル」です。数分間にわたって、一度見た場所の様子を保ったまま世界を生成し続けられることが示されました。DeepMind は、世界モデルを、AIエージェントやロボットが試行錯誤しながら学ぶための訓練の場として位置付けています。生成モデルが、強化学習の「環境」を作る役割を担い始めたのです。
拡散の考え方が言葉に戻ってくる
もう1つの動きが、拡散の考え方を文章の生成に使う拡散言語モデルです。
第5章以来、文章の生成は「次の単語を1つずつ予測する」自己回帰の方法が主流でした。この方法は、単語を1つずつ順番に出すため、長い文章ほど時間がかかります。拡散言語モデルは、文章の一部を隠した(マスクした)状態から、複数の単語をまとめて少しずつ埋めていくことで、並列に文章を生成します。
2025年2月には、拡散の方法で一から学習した大規模な言語モデル LLaDA が発表され、同じ年の5月には、Google が実験的なモデル Gemini Diffusion を公開しました。Inception Labs の Mercury のように、高速さを特徴とする商用の拡散言語モデルも登場しています。画像の世界で育った拡散の考え方が、言葉の世界に戻ってきたことになります。
残された問題
最新の生成モデルにも、多くの課題が残っています。
- 長い時間の一貫性:世界モデルや長い動画で、時間がたっても矛盾なく生成し続けること
- 物理的な正確さ:物の落ち方や衝突など、現実の物理法則に沿った動きを生成すること
- 事実の正確さ:言語モデルがもっともらしい誤り(ハルシネーション)を出力すること
- 社会的な課題:ディープフェイクへの悪用、著作権との関係、生成物であることを示す電子透かしの整備など
ここで確認
問い:動画生成モデルと比べて、世界モデルは何ができるようになったのでしょうか。
答え:生成された世界を見るだけでなく、利用者やAIエージェントが行動に応じてリアルタイムに操作できるようになりました。そのため、エージェントやロボットの訓練の場としても期待されています。
終章 物語を貫くパターン
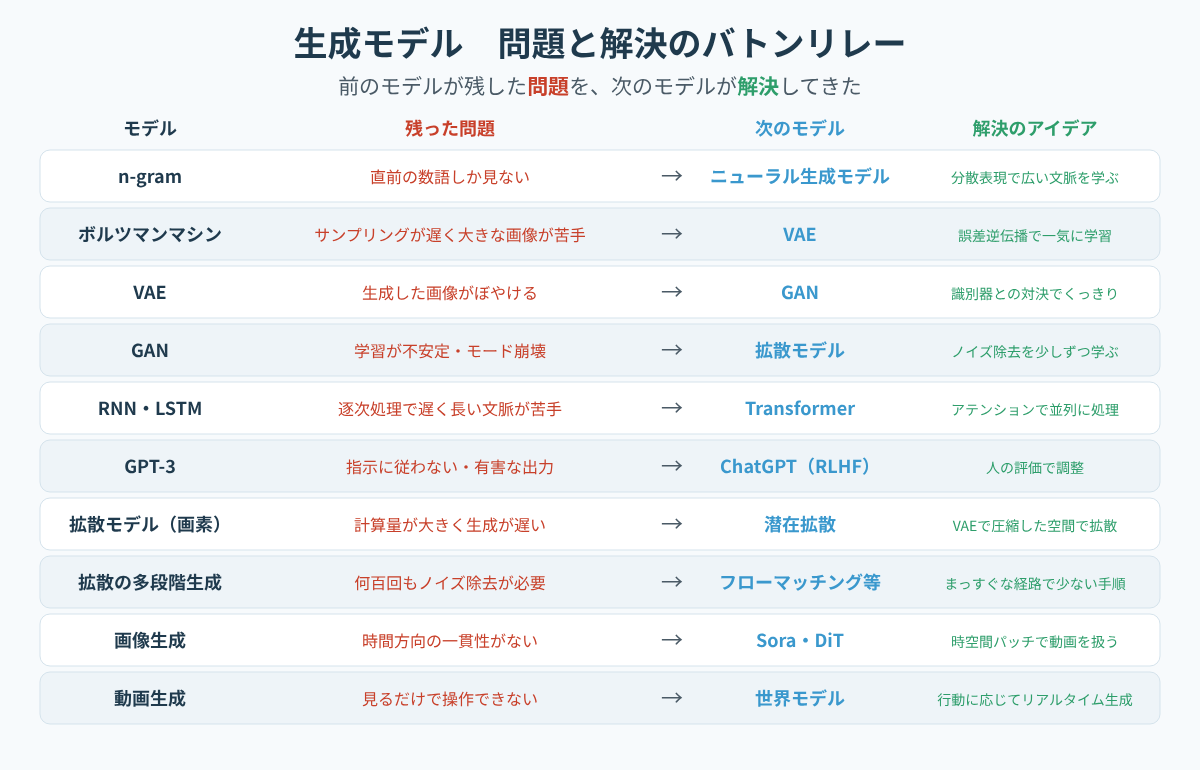
生成モデルの歴史を振り返ると、いくつかのパターンが見えてきます。
品質・多様性・速さの三すくみ
生成モデルには、次の3つの性質が求められます。
- 品質:くっきりした、本物らしいデータを作れるか
- 多様性:偏らず、さまざまな種類のデータを作れるか
- 速さ:少ない計算で、すぐに作れるか
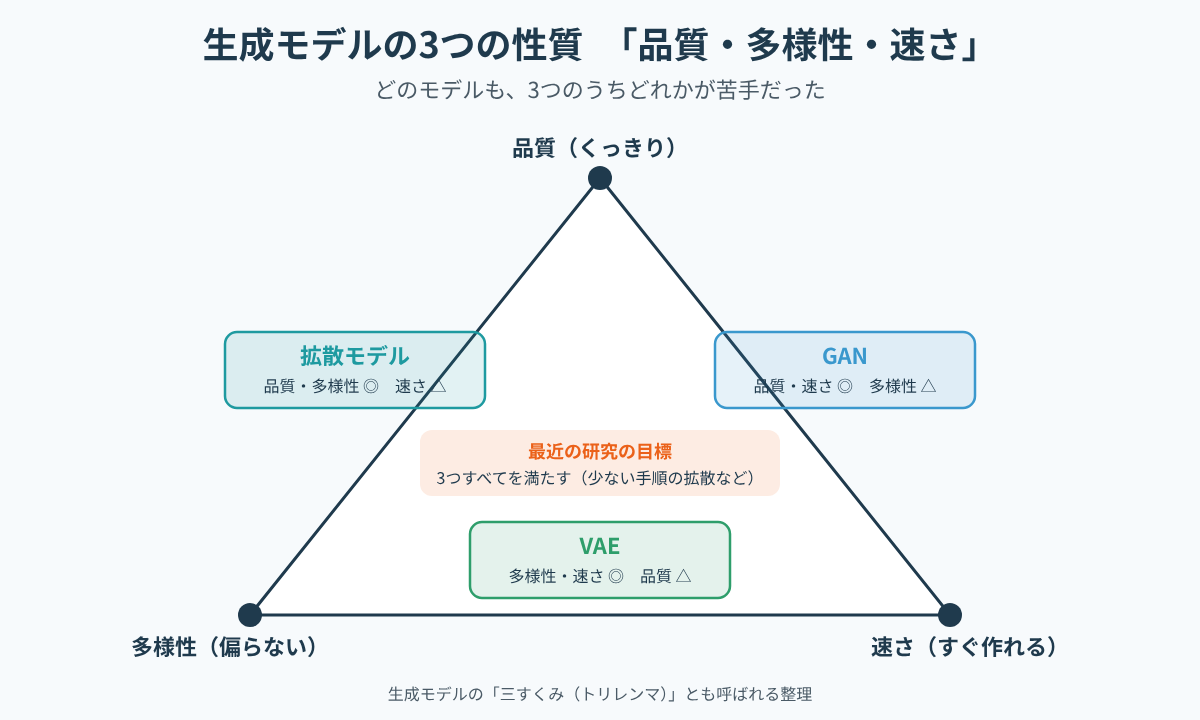
研究者の間では、この3つを同時に満たすのが難しいことを「生成モデルの三すくみ(トリレンマ)」と呼ぶ整理があります。GAN は品質と速さに優れる一方で多様性に課題があり、VAE は多様性と速さに優れる一方で品質に課題があり、拡散モデルは品質と多様性に優れる一方で速さに課題がありました。フローマッチングや一貫性モデルなどの研究は、この3つすべてを満たすことを目指したものと捉えられます。
古いアイデアが部品として戻ってくる
もう1つのパターンは、古いアイデアが、形を変えて何度も戻ってくることです。
- シャノンの「次の単語を予測する」考え方は、GPT の学習の中心になった
- 「ぼやける」と言われた VAE は、潜在拡散モデルの圧縮役として戻ってきた
- 言葉のために生まれた Transformer は、画像や動画の生成でも主役になった
- 画像で育った拡散の考え方は、拡散言語モデルとして言葉の生成に戻ってきた
研修では、新しいモデルを紹介するときに「このモデルは、どの問題を解決するために生まれたのか」「どの古いアイデアを使っているのか」の2つを問いかけてみてください。受講者は、モデルの名前を暗記するのではなく、技術どうしのつながりとして理解できるようになります。
確認問題
生成モデルの歴史について、正しい説明を1つ選んでください。
- 潜在拡散モデルは、VAE で圧縮した空間の中で拡散を行う
- GAN は、ノイズを少しずつ取り除く手順を繰り返して画像を作る
- Transformer は、単語を1つずつ順番に処理する RNN の一種である
- 拡散モデルは、GAN よりも少ない手順で画像を生成できる
解答と解説
正解は 1 です。
- 1 は正しい説明です。画像を VAE で小さな潜在空間に圧縮し、その中で拡散を行うことで計算量を減らしました
- 2 は誤りです。ノイズを少しずつ取り除くのは拡散モデルです。GAN は生成器が1回でデータを作り、識別器と競わせて学習します
- 3 は誤りです。Transformer は RNN のような順番どおりの処理をやめ、アテンションですべての単語の関係を一度に計算します
- 4 は誤りです。拡散モデルは何百回もの手順が必要で、生成の速さは GAN に劣ることが課題でした
研修で使うときの進め方
講師向けに、この物語を研修で使う進め方の一例を示します。
- 序章の識別モデルと生成モデルの違いを、料理のたとえで確認する
- 年表の図を示し、8つの章の全体像を先に見せる
- 各章を「主人公(モデル)」「立ちはだかった壁(問題)」「次の主人公への引き継ぎ(解決)」の3点で説明する
- 各章の「ここで確認」の問いを、個人またはペアで答えてもらう
- 三すくみの図を使い、各モデルの得意・不得意を整理する
- 問題と解決のバトンリレーの図で、章どうしのつながりを振り返る
- グループワークとして、「世界モデルや拡散言語モデルに残る問題を、次のモデルはどう解決するか」を話し合ってもらう
画像生成AIの体験と組み合わせる場合は、生成した画像の著作権や、実在の人物を扱う際の注意点についても、あわせて伝えるようにしてください。
まとめ
- 生成モデルは、データの分布を学び、新しいデータを作るモデルで、その源流はシャノンの文章生成にある
- VAE は潜在空間から1回で生成できるようにしたが、画像がぼやける問題が残った
- GAN は識別器との対決でくっきりした画像を生成したが、学習の不安定さとモード崩壊が残った
- 拡散モデルはノイズを少しずつ取り除くことで安定と多様性を実現し、潜在拡散で計算量を減らした
- 言葉の生成は、n-gram、RNN、Transformer、GPT と進み、ChatGPT で広く使われるようになった
- 現在は、音声付き動画、操作できる世界モデル、拡散言語モデルなど、生成モデルの統合と拡張が進んでいる
次の学習ステップとしては、VAE、GAN、拡散モデルを、小さなデータセット(手書き数字など)で実際に動かして比べる流れをおすすめします。同じデータで3つのモデルを学習させると、ぼやける、偏る、遅いといった歴史上の問題を、自分の目で確かめられます。
投稿者プロフィール
- 代表取締役
-
セイ・コンサルティング・グループ株式会社代表取締役。
岐阜県出身。
海外放浪の末、2000年創業、2004年会社設立。
IT企業向け人材育成研修歴業界歴20年以上。
すべての無駄を省いた費用対効果の高い「筋肉質」な研修を提供します!
この記事に間違い等ありましたらぜひお知らせください。
学生時代は趣味と実益を兼ねてリゾートバイトにいそしむ。長野県白馬村に始まり、志賀高原でのスキーインストラクター、沖縄石垣島、北海道トマム。高じてオーストラリアのゴールドコーストでツアーガイドなど。現在は野菜作りにはまっている。
最新の投稿
 山崎講師2026年11月15日機械学習の歴史を物語で学ぶ|最小二乗法からパーセプトロン、決定木、SVM、ランダムフォレスト、勾配ブースティング、表形式基盤モデルまで
 山崎講師2026年11月15日オプティマイザの歴史を物語で学ぶ|勾配降下法からモーメンタム、AdaGrad、RMSProp、Adam、AdamW、Muonまで
 山崎講師2026年11月15日ディープラーニングの歴史を物語で学ぶ|パーセプトロンから誤差逆伝播法、2度の冬、AlexNet、Transformer、基盤モデルまで
 山崎講師2026年11月15日コンピュータビジョンの歴史を物語で学ぶ|猫の脳の実験からAlexNet、ResNet、YOLO、ViT、CLIP、SAM、ロボットの目まで