山崎講師
機能説明で終わらないSASフレームワーク ── IT営業が「解決策・利点・満足」で価値を語る方法
こんにちは。ゆうせいです。 IT営業向け連載の第6回です。前回は、リサーチシートで仮説を3つに絞る方法をお伝えしました。仮説をお客様に確かめ、課題が整理できたら、次は提案の中身を語る段階です。今回は、提案の価値を「解決策 […]
訪問前に勝負が決まる ── IT営業のリサーチシートと仮説を3つに絞る方法
こんにちは。ゆうせいです。 IT営業向け連載の第5回です。前回は、信頼を作る3つの柱と、5W2Hで課題を整理する順番をお伝えしました。今回は、訪問前の準備がテーマです。お客様を調べて仮説を作るための道具であるリサーチシー […]
傾聴・共感・共鳴と5W2H ── IT営業が信頼を作り課題を引き出すヒアリングの順番
こんにちは。ゆうせいです。 IT営業向け連載の第4回です。前回は、お客様のソーシャルスタイルに合わせて伝え方を変える方法をお伝えしました。今回は、伝える前の段階である「聴く」がテーマです。信頼関係を作る傾聴・共感・共鳴の […]
ソーシャルスタイルで変えるお客様への伝え方 ── 同じ提案が通る人と通らない人がいる理由
こんにちは。ゆうせいです。 IT営業向け連載の第3回です。前回は、SWOT分析とTOWS分析で自社の強みを言葉にし、「誰に何を提案するか」を決める方法をお伝えしました。今回は、決めた提案を「相手に合わせてどう伝えるか」が […]
自社の強みを言葉にするSWOT分析とTOWS分析の使い方 ── IT営業が「誰に何を提案するか」を決める方法
こんにちは。ゆうせいです。 IT営業向け連載の第2回です。前回は、御用聞き型営業が価格競争に入りやすい理由と、仮説提案型営業への転換についてお伝えしました。仮説を作るには、お客様を知ることと同じくらい、自社を知ることが必 […]
御用聞き営業はなぜ価格競争に巻き込まれるのか ── IT営業が「仮説提案型」に変わるための第一歩
こんにちは。ゆうせいです。 この連載では、IT営業の方に向けて、ソリューション営業とネゴシエーション(交渉)の基本を全10回でお伝えします。第1回のテーマは、営業スタイルそのものです。「お客様の要望を丁寧に聞いて、正確に […]
研修講師のための発信者情報開示請求入門 中傷されたときの判断手順と現実的なコスト
こんにちは。ゆうせいです。 研修講師として活動していると、自分の名前がインターネット上に残ります。実績として残ることもあれば、望まない形で書かれることもあります。 口コミサイトに事実と異なることを書かれた。SNSで中傷さ […]
研修講師のためのフリーランス法入門 契約・報酬・中止時の扱いを実務目線で整理
こんにちは。ゆうせいです。 研修講師として業務委託で仕事を受けていると、次のような経験はないでしょうか。 登壇日は決まっているのに、契約書が届かない。報酬の振込が研修の3か月後になる。営業用のデモ研修を無償で頼まれる。研 […]
消費税減税とインフレの関係:減税が家計に与える影響と経済の仕組み
こんにちは。ゆうせいです。 物価の上昇が続く中で、景気対策や家計支援の手段として消費税の減税が議論される場面が増えています。税率を引き下げれば店頭の価格が下がり、消費者の負担が軽くなるという見方がある一方で、減税が物価の […]
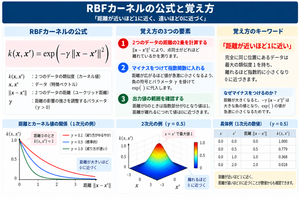
RBFカーネル(放射基底関数)の公式と覚え方を解説
こんにちは。ゆうせいです。 データを直線で分けることが難しい場合、機械学習ではデータを高次元の空間に移して境界を引く手法が用いられます。その中心的な役割を担うのがサポートベクターマシンなどで使われるカーネル関数であり、代 […]
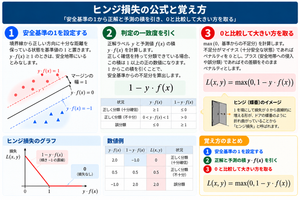
SVMのヒンジ損失とソフトマージンの公式と覚え方を解説
こんにちは。ゆうせいです。 データを2つのグループに分類するサポートベクターマシン(SVM)において、全てのデータを完全に分離できない状況に対応する仕組みとしてソフトマージンがあります。その際、誤った分類やマージンへの侵 […]
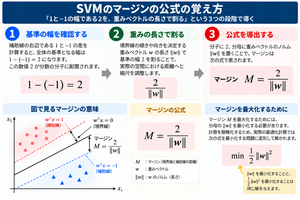
サポートベクターマシン(SVM)におけるマージン最大化の公式と覚え方
こんにちは。ゆうせいです。 データを2つのグループに分類する機械学習の代表的なアルゴリズムとして、サポートベクターマシンがあります。サポートベクターマシンは、境界線を引いてデータを分ける際に、境界線とデータとの間の隙間を […]
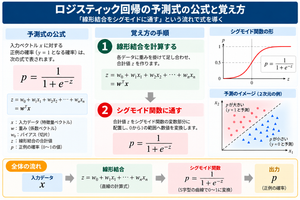
ロジスティック回帰の公式と覚え方:シグモイド関数による確率予測を解説
こんにちは。ゆうせいです。 機械学習において、ある事象が起こるか起こらないかを判定する分類問題があります。例えば、メールが迷惑メールかどうかを判定したり、明日の天気が雨になるかを予測したりする場面です。こうした判定を行う […]
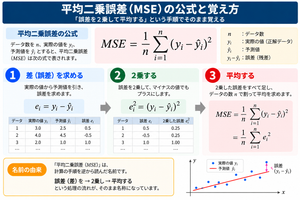
平均二乗誤差(MSE)の公式と覚え方:機械学習の基礎評価指標を解説
こんにちは。ゆうせいです。 機械学習や統計学のモデルを作成する際、予測がどれくらい当たっているかを数値化する必要があります。その代表的な指標が「平均二乗誤差(Mean Squared Error、通称MSE)」です。本記 […]
線形回帰の正規方程式の覚え方とは?w=(XᵀX)⁻¹Xᵀyの仕組みを初心者向けに解説
こんにちは。ゆうせいです。 統計学や機械学習の基礎を学ぶ過程で、データの予測を行う最初の手法として線形回帰が登場します。その計算を一度の操作で完了させる数式が正規方程式です。アルファベットや転置記号、逆行列の記号が複数組 […]
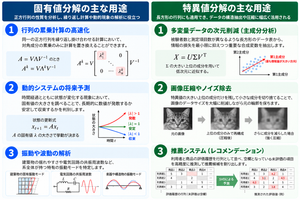
特異値分解と固有値分解の違いとは?適用できる行列の形状と用途を初心者向けに解説
こんにちは。ゆうせいです。 線形代数の応用を学び進めると、データ分析や機械学習の基盤となる計算手法として固有値分解と特異値分解(SVD)の2つが登場します。どちらも行列を複数の単純な要素へと分解する手法ですが、具体的にど […]
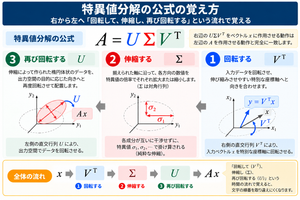
特異値分解(SVD)の公式の覚え方とは?A=UΣVᵀを初心者向けに解説
こんにちは。ゆうせいです。 データ分析や画像圧縮、機械学習の基礎理論を学ぶ過程で、避けて通れない重要な計算手法に特異値分解(Singular Value Decomposition、略称SVD)があります。数式を見るとア […]
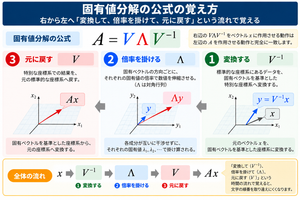
固有値分解の公式の覚え方とは?A=VΛV⁻¹の意味と仕組みを初心者向けに解説
こんにちは。ゆうせいです。 線形代数を学ぶ中で、多くの学習者がつまずきやすい数式の一つに、固有値分解の公式があります。アルファベットや記号が並ぶ式を見ると、丸暗記に頼ってしまい、計算の途中で文字の順番が分からなくなる方も […]
CDS(クレジット・デフォルト・スワップ)の名前の由来と基礎知識
こんにちは。ゆうせいです。 金融のニュースなどでCDSという言葉を目にする機会があります。アルファベット3文字の略称であるため、どのような取引を指すのか把握しづらいと感じる方も多いのではないでしょうか。本記事では、金融の […]
インセプションモジュールの名前の由来と画像認識での仕組み
こんにちは。ゆうせいです。 人工知能や画像認識の技術を学ぶ過程で、インセプションモジュールという名称を目にする機会があります。この技術は、2014年の画像認識コンテストで優勝したGoogLeNetと呼ばれるニューラルネッ […]
残差学習(Residual Learning)の名前の由来と深層学習での仕組み
こんにちは。ゆうせいです。 人工知能や画像認識の分野では、残差学習(Residual learning)という手法が広く活用されています。この手法は、2015年に発表されたResNetと呼ばれるニューラルネットワークの根 […]
日本の長期金利上昇の背景は国債価格の下落を通じて生じる現象であり、財政状況や民間需要を含む市場全体の取引によって決まっている。
こんにちは。ゆうせいです。 日本の長期金利が3%の水準に達し、約30年ぶりの高水準となったことが話題を集めています。金利の上昇はニュースで頻繁に取り上げられますが、その具体的な発生理由や、私たちの家計や社会全体に及ぼす影 […]
ソフトマックス関数がなぜネイピア数eを使うのか:確率分布と情報理論の視点
こんにちは。ゆうせいです。 ディープラーニングで分類問題を学ぶ際、必ず登場するのがソフトマックス関数です。その式を見ると、ネイピア数e(およそ2.718)を使った指数が入っています。なぜわざわざeの指数なのか、という疑問 […]
オープンウェイトモデルとは何か:オープンソースとの違いを理解する
こんにちは。ゆうせいです。 生成AIのニュースを読んでいると、「オープンウェイトモデル」という言葉を目にする機会が増えています。MetaのLlamaシリーズや、MistralのモデルなどがAIコミュニティで注目される際に […]
ロジスティック回帰と線形回帰の関係:分類問題への拡張を理解する
こんにちは。ゆうせいです。 機械学習を学ぶ際、「線形回帰」と「ロジスティック回帰」という二つの手法が登場します。一見すると別の手法のように思えますが、実は密接な関係があります。ロジスティック回帰は、線形回帰の考え方を分類 […]
統計学と機械学習の考え方の違い:3つの根本的な相違点
こんにちは。ゆうせいです。 データを扱う技術として「統計学」と「機械学習」は、一見すると似たような領域です。どちらもデータから情報を抽出し、予測や推定を行うからです。しかし、その根本的な考え方は大きく異なります。この違い […]
次元数に対して約10倍のデータが必要なのはなぜか:次元の呪いの実践的理解
こんにちは。ゆうせいです。 機械学習モデルを構築するとき、「特徴量(次元)の数に対して、最低でも約10倍のデータが必要」という経験則をよく聞きます。例えば、50個の特徴量がある場合、500個以上のサンプルが必要という主張 […]
モデル窃取と蒸留の違いを理解する:機械学習モデルの知識移転と不正複製
こんにちは。ゆうせいです。 機械学習の発展に伴い、既存のモデルから知識や機能を取得する技術が注目を集めています。その中には、正当な目的で行われる「蒸留」と、不正な目的で行われる「モデル窃取」という二つの概念があります。ど […]
代表的な4つのXAI技術を比較する:LIME、SHAP、Grad-CAM、Permutation Importance
こんにちは。ゆうせいです。 機械学習モデルが予測や分類を行う際に、「なぜそのような結果が得られたのか」という問いに答えることは、システムの信頼性を高める上で重要です。特に医療診断、与信判定、採用審査など、判定結果が人の人 […]
C2PA(コンテンツの真正性証明標準):デジタルコンテンツの出所を追跡する仕組み
こんにちは。ゆうせいです。 インターネット上には、加工されたり、改ざんされたり、AIで生成されたりした画像や動画が溢れています。見た人が、そのコンテンツが本物なのか、加工されたものなのかを判断することは難しくなっています […]